영어 음성 인식 평가, 이집트와 나이지리아 발음까지 넓힌다
허깅페이스가 리바 AI와 함께 영어 음성 인식 평가에 쓸 발음을 늘렸다. 공개되지 않은 데이터를 써서 성능 시험 점수만 노리는 경쟁을 줄이겠다는 취지다.
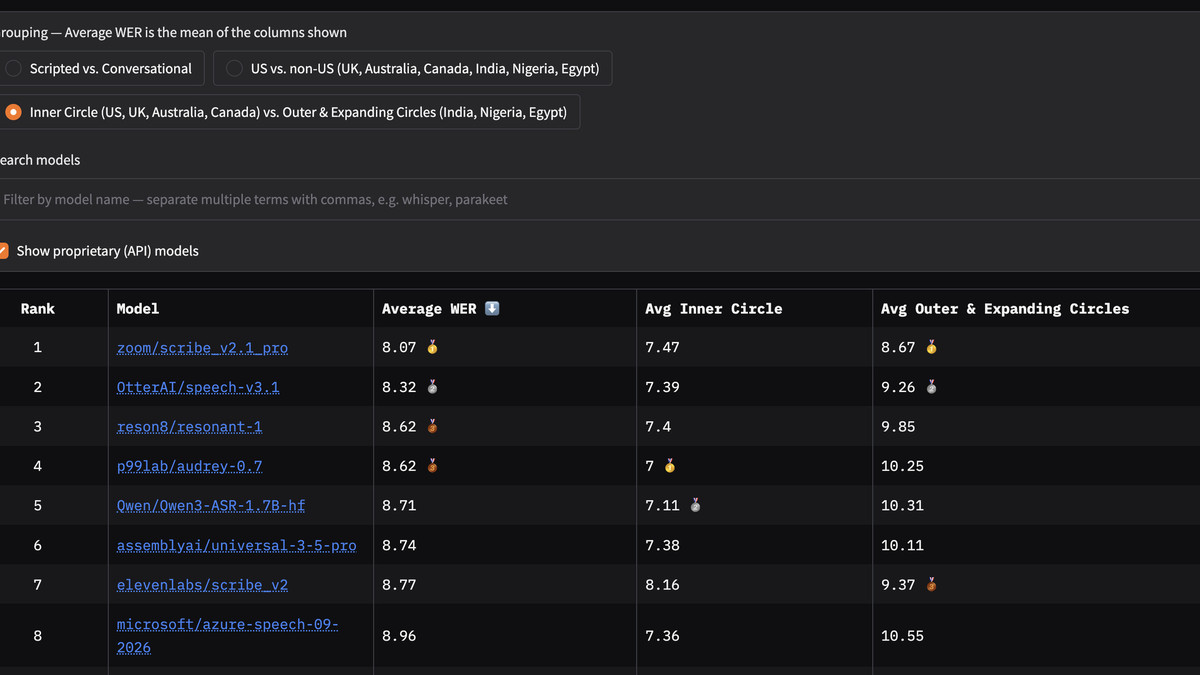
허깅페이스가 영어 음성 인식 성능 비교표인 Open ASR Leaderboard에 이집트식과 나이지리아식 영어 발음 평가 데이터를 추가한다고 11월 6일 밝혔다. 리바 AI(Liva AI)와 협력해 확보한 비공개 데이터다. 같은 영어라도 어떤 발음으로 말하느냐에 따라 음성 인식 모델의 성적이 어떻게 달라지는지 더 폭넓게 볼 수 있게 된다.
발음 데이터를 늘린 것은 이번이 처음이 아니다. 앞서 허깅페이스는 앱펜과 데이터오션AI에서 받은 비공개 평가용 데이터 11개 묶음을 추가했다. 대본을 그대로 읽은 음성과 자유롭게 대화한 음성을 다섯 가지 발음으로 담은 데이터다. 이후 보이스 아레나와 함께 인도식 영어 데이터 묶음을 하나 더했고, 이번에 두 지역 발음이 더 붙었다.
허깅페이스는 다양한 발음을 평가에 반영하고 결과의 신뢰도를 높이는 것이 목표라고 설명했다. 새로운 비공개 데이터와 데이터 제공처를 확보해 성능 시험 점수만 끌어올리려는 행위를 줄이겠다는 것이다. 발음 구분에는 영어 사용 지역을 세 겹의 원으로 나누는 카치루의 세 동심원 이론을 적용한다. 앞으로 발음 종류가 더 늘면 평가 범주도 일부 나눌 계획이다.
이미지: huggingface.co
영어 음성 인식 도구를 고르는 쪽에서는 비교해 볼 수 있는 대상이 넓어진다. 이집트식과 나이지리아식 영어에서도 모델의 인식 성적을 확인할 수 있다. 앞으로 볼 점은 발음별 평가 범위가 얼마나 더 넓어지는지, 그래서 모델 간 차이를 얼마나 구체적으로 가릴 수 있는지다.