엔비디아, 주행과 로봇 장면 만드는 Cosmos 3 모델 4종 공개
카메라와 라이다 데이터를 함께 만들고, 로봇 동작에 따라 바뀌는 장면을 예측한다. 추가 학습 방법까지 공개해 개발자가 자기 차량 센서와 로봇에 맞춰 바꿀 수 있다.
엔비디아가 11월 5일(현지시간) 가상 주행과 로봇 실험에 쓰는 Cosmos 3 모델 4종을 공개했다. 차량 주변 장면을 만들거나, 로봇의 움직임에 따라 다음 화면을 예측하는 모델이다. 네 모델 모두 Cosmos 3 Nano를 추가 학습해 만들었고, 모델 크기는 각각 160억 개다. OpenMDW1.1 이용 조건에 따라 상업적, 비상업적 목적으로 모두 쓸 수 있다.
카메라 11개 시점, 어떻게 한 번에 만드나
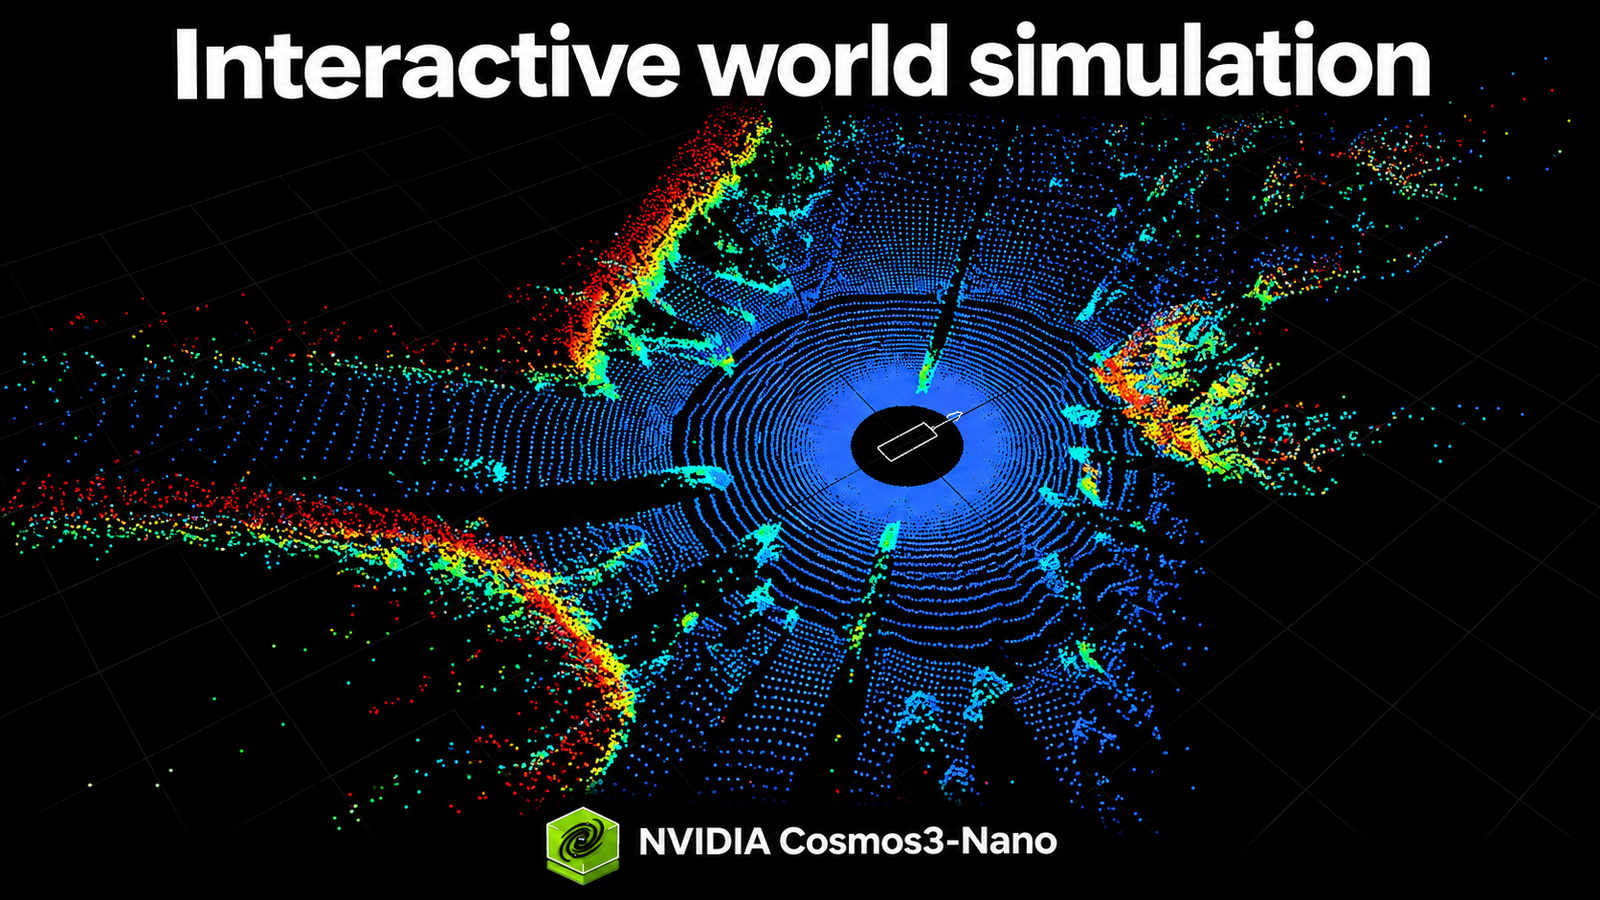
Cosmos3-Nano-Transfer-Auto는 주행 학습용 데이터를 미리 만드는 모델이다. 넓게 보이는 어안 카메라를 포함해 최대 11개 시점의 영상을 서로 맞춰 만든다. 컬러 영상뿐 아니라 라이다 데이터도 만든다. 라이다는 레이저로 주변의 입체 구조를 읽는 센서다. 도로 구조와 교통 흐름을 정해 두고, 날씨나 조명, 시간대는 글로 적어 바꾸는 방식이다.
개발자는 자기 차량의 센서 구성과 주행 환경에 맞춰 이 모델을 추가 학습할 수 있다. 카메라 배치나 라이다 설정에 맞게 조정한 뒤 데이터를 만드는 데 쓰면 된다. 엔비디아는 이렇게 조정한 모델을 바탕으로 장면을 빠르게 이어 만드는 Cosmos3-Nano-Sim-Auto를 개발했다고 설명했다.
Sim-Auto는 앞서 만든 장면과 새 주행 제어 정보를 받아 카메라 영상과 라이다 데이터를 짧은 구간씩 만든다. 차량의 다음 행동에 따라 장면이 계속 바뀌는 실험을 할 수 있다. 다만 주행 입력을 장면에 반영하려면 시뮬레이션을 돌리는 환경과 제어 정보를 만드는 도구를 따로 갖춰야 한다.
로봇의 다음 동작을 영상으로
Cosmos3-Nano-Sim-Transfer는 물리 시뮬레이터가 계산한 상태를 사실적인 영상으로 바꾼다. 시뮬레이터가 움직임과 접촉을 계산하면, 모델은 거리와 물체 경계 같은 정보에 글로 적은 지시를 더해 화면을 만든다. 물리 계산은 시뮬레이터에 맡기고, 로봇 제어 AI가 볼 장면만 만들어 내는 구조다.
이미지: huggingface.co
Cosmos3-Nano-Sim-Bimanual은 장면과 로봇 행동만 보고 다음에 보일 영상을 바로 예측한다. 양팔 로봇인 YAM과 AgiBot을 지원하며, 제어 AI나 사람이 조이스틱으로 움직일 수 있다. 이미지 한 장에서 시작해 로봇이나 카메라를 움직이면 그에 맞는 화면이 생성된다. 한 번의 제어 과정에서 시점을 바꾸는 동작과 물체를 다루는 동작을 번갈아 할 수 있다.
개발자가 쓰려면 무엇이 필요한가
엔비디아는 모델과 함께 추가 학습 절차도 공개했다. 개발자는 자체 주행 데이터나 로봇 데이터로 모델을 자기 환경에 맞출 수 있다. Bimanual 모델을 돌리려면 리눅스와 엔비디아 GPU, Docker, NVIDIA Container Toolkit이 필요하다. 공개된 서버 실행 구성은 GB200 한 대에서 시험됐다.
이미지: huggingface.co
엔비디아는 생성한 화면의 작은 오류가 다음 화면에 영향을 주며 쌓일 수 있다고 설명했다. 앞으로 볼 대목은 영상이 얼마나 사실적인지보다, 이렇게 만든 가상 환경이 제어 AI의 학습과 평가를 제대로 뒷받침하느냐다. 엔비디아도 그 범위와 한계를 재는 일을 남은 과제로 꼽았다.