NEO-VLA 공개, 로봇이 움직일 때 이미지 중간 정보까지 본다
이미지 처리 중간에 나오는 정보까지 읽어 로봇 동작을 만드는 연구 모델이다. 가상환경 시험에서는 높은 성공률을 보고했지만, 물체 위치와 목표가 달라진 시험에서는 성적이 크게 떨어졌다.
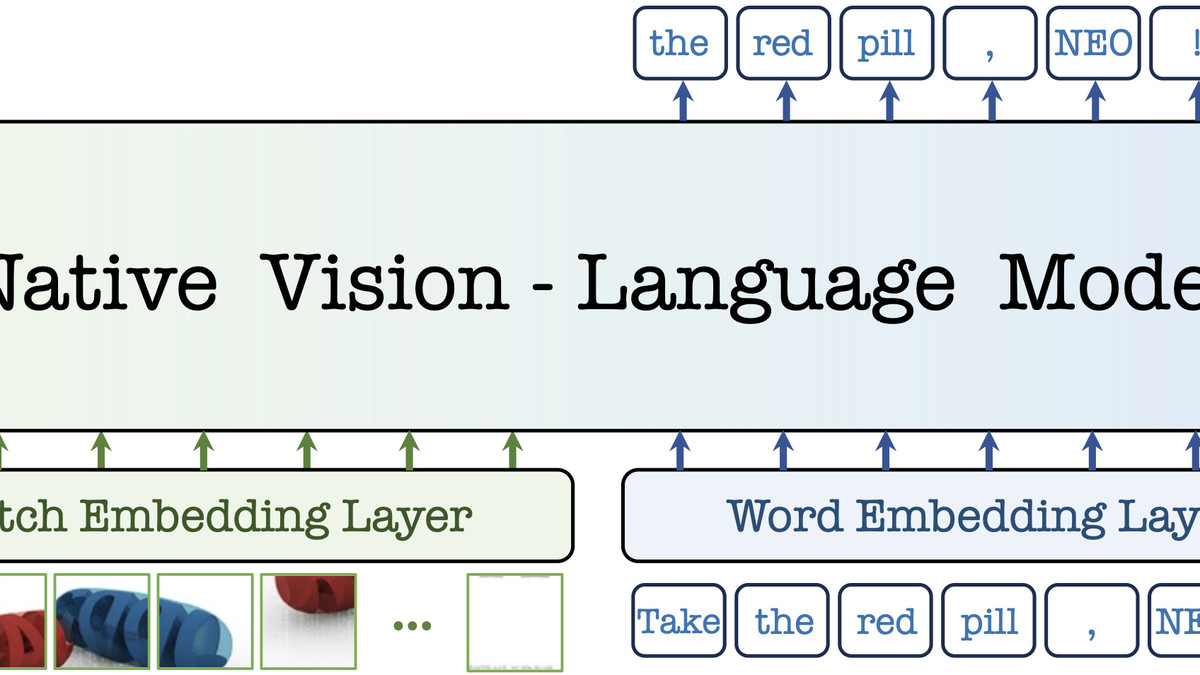
로봇이 보는 정보와 움직임을 더 긴밀하게 잇는 연구 모델 NEO-VLA가 나왔다. 연구진은 11월 4일(현지시간) 논문을 공개했다. 이미지와 사람의 말로 된 지시를 받아 로봇 동작을 만드는 모델이다. 연구 코드 저장소 링크도 함께 실었다.
로봇은 어떤 정보를 보고 움직이나
NEO-VLA는 이미지 처리가 끝난 결과만 쓰지 않는다. 처리 중간에 생기는 시각 정보까지 행동을 정하는 데 쓴다. 기존의 많은 모델은 별도 장치가 이미지 정보를 압축한 뒤 행동을 결정하는 모델에 넘긴다. 연구진은 이 과정에서 물체의 경계와 깊이, 미세한 상태 변화처럼 물건을 집고 옮길 때 필요한 단서가 약해질 수 있다고 지적했다.
NEO-VLA는 이미지 조각과 언어 지시를 같은 모델 안에서 함께 처리한다. 행동을 만드는 부분은 여러 처리 단계에서 시각 정보를 읽어 로봇의 연속된 움직임을 만든다. 연구진은 조건을 똑같이 맞춘 비교에서 이른 단계의 시각 정보가 물건을 다루는 데 도움이 됐다고 밝혔다. 사람이 말로 내린 지시를 로봇이 수행할 때 물체의 세부 모습을 얼마나 잘 쓰는지가 이 연구의 관심사다.
성공률 97.4%, 실제 로봇에서도 그럴까
연구진이 보고한 가상환경 성능 시험 LIBERO의 평균 성공률은 97.4%였다. 환경 변화를 포함한 LIBERO-Plus의 종합 점수는 89.7점이었다. 실제 로봇으로 해 본 세 가지 과제에서는 각각 20회씩 시도해 12회, 17회, 13회 성공했다.
LIBERO 평균 성공률만 보면 NEO-VLA보다 높은 모델도 있다. 논문에 실린 EO-1은 98.4%, MMaDA-VLA는 98.0%를 기록했다. 연구진은 모델마다 학습 데이터와 평가 조건이 달라 이 숫자만으로 우열을 가릴 수 없다고 설명했다.
물체를 놓는 위치나 목표가 달라지는 시험에서는 성적이 크게 떨어졌다. LIBERO-Pro에서 물체 위치가 바뀐 조건의 성공률은 3.0%, 과제 목표가 바뀐 조건은 6.3%였다. 평균 97.4%를 기록한 모델이 이런 조건에서는 성공률이 10%에도 못 미쳤다.
지금 무엇을 살펴볼 수 있나
지금 공개된 것은 논문과 연구 코드, 학습된 모델 파일이다. 로봇 개발에 관심 있는 연구자와 개발자는 모델의 설계와 평가 결과를 들여다볼 수 있다. 바로 사서 쓸 수 있는 제품 단계는 아니고, 로봇이 시각 정보를 행동으로 잇는 방법을 따져 본 연구에 가깝다.
이번 연구는 로봇이 움직임을 정할 때 이미지 처리의 어느 단계까지 참고할지에 초점을 맞췄다. 평가 결과는 물체 위치나 목표가 바뀌는 상황이 여전히 어려운 과제임을 보여준다. 앞으로 볼 점은 중간 단계의 시각 정보를 쓰는 방식이 이런 변화에 대한 대응력까지 높일 수 있느냐다.