이미지 0.3초에 만들고 글자도 정확하게, 새 학습법 IDM 공개
Inclusion AI 연구진이 적은 계산으로 이미지 속 글자를 더 정확히 만드는 학습법을 공개했다. 이미지 생성 코드는 받을 수 있지만, 학습을 마친 모델 파일은 아직 ‘공개 예정’이다.
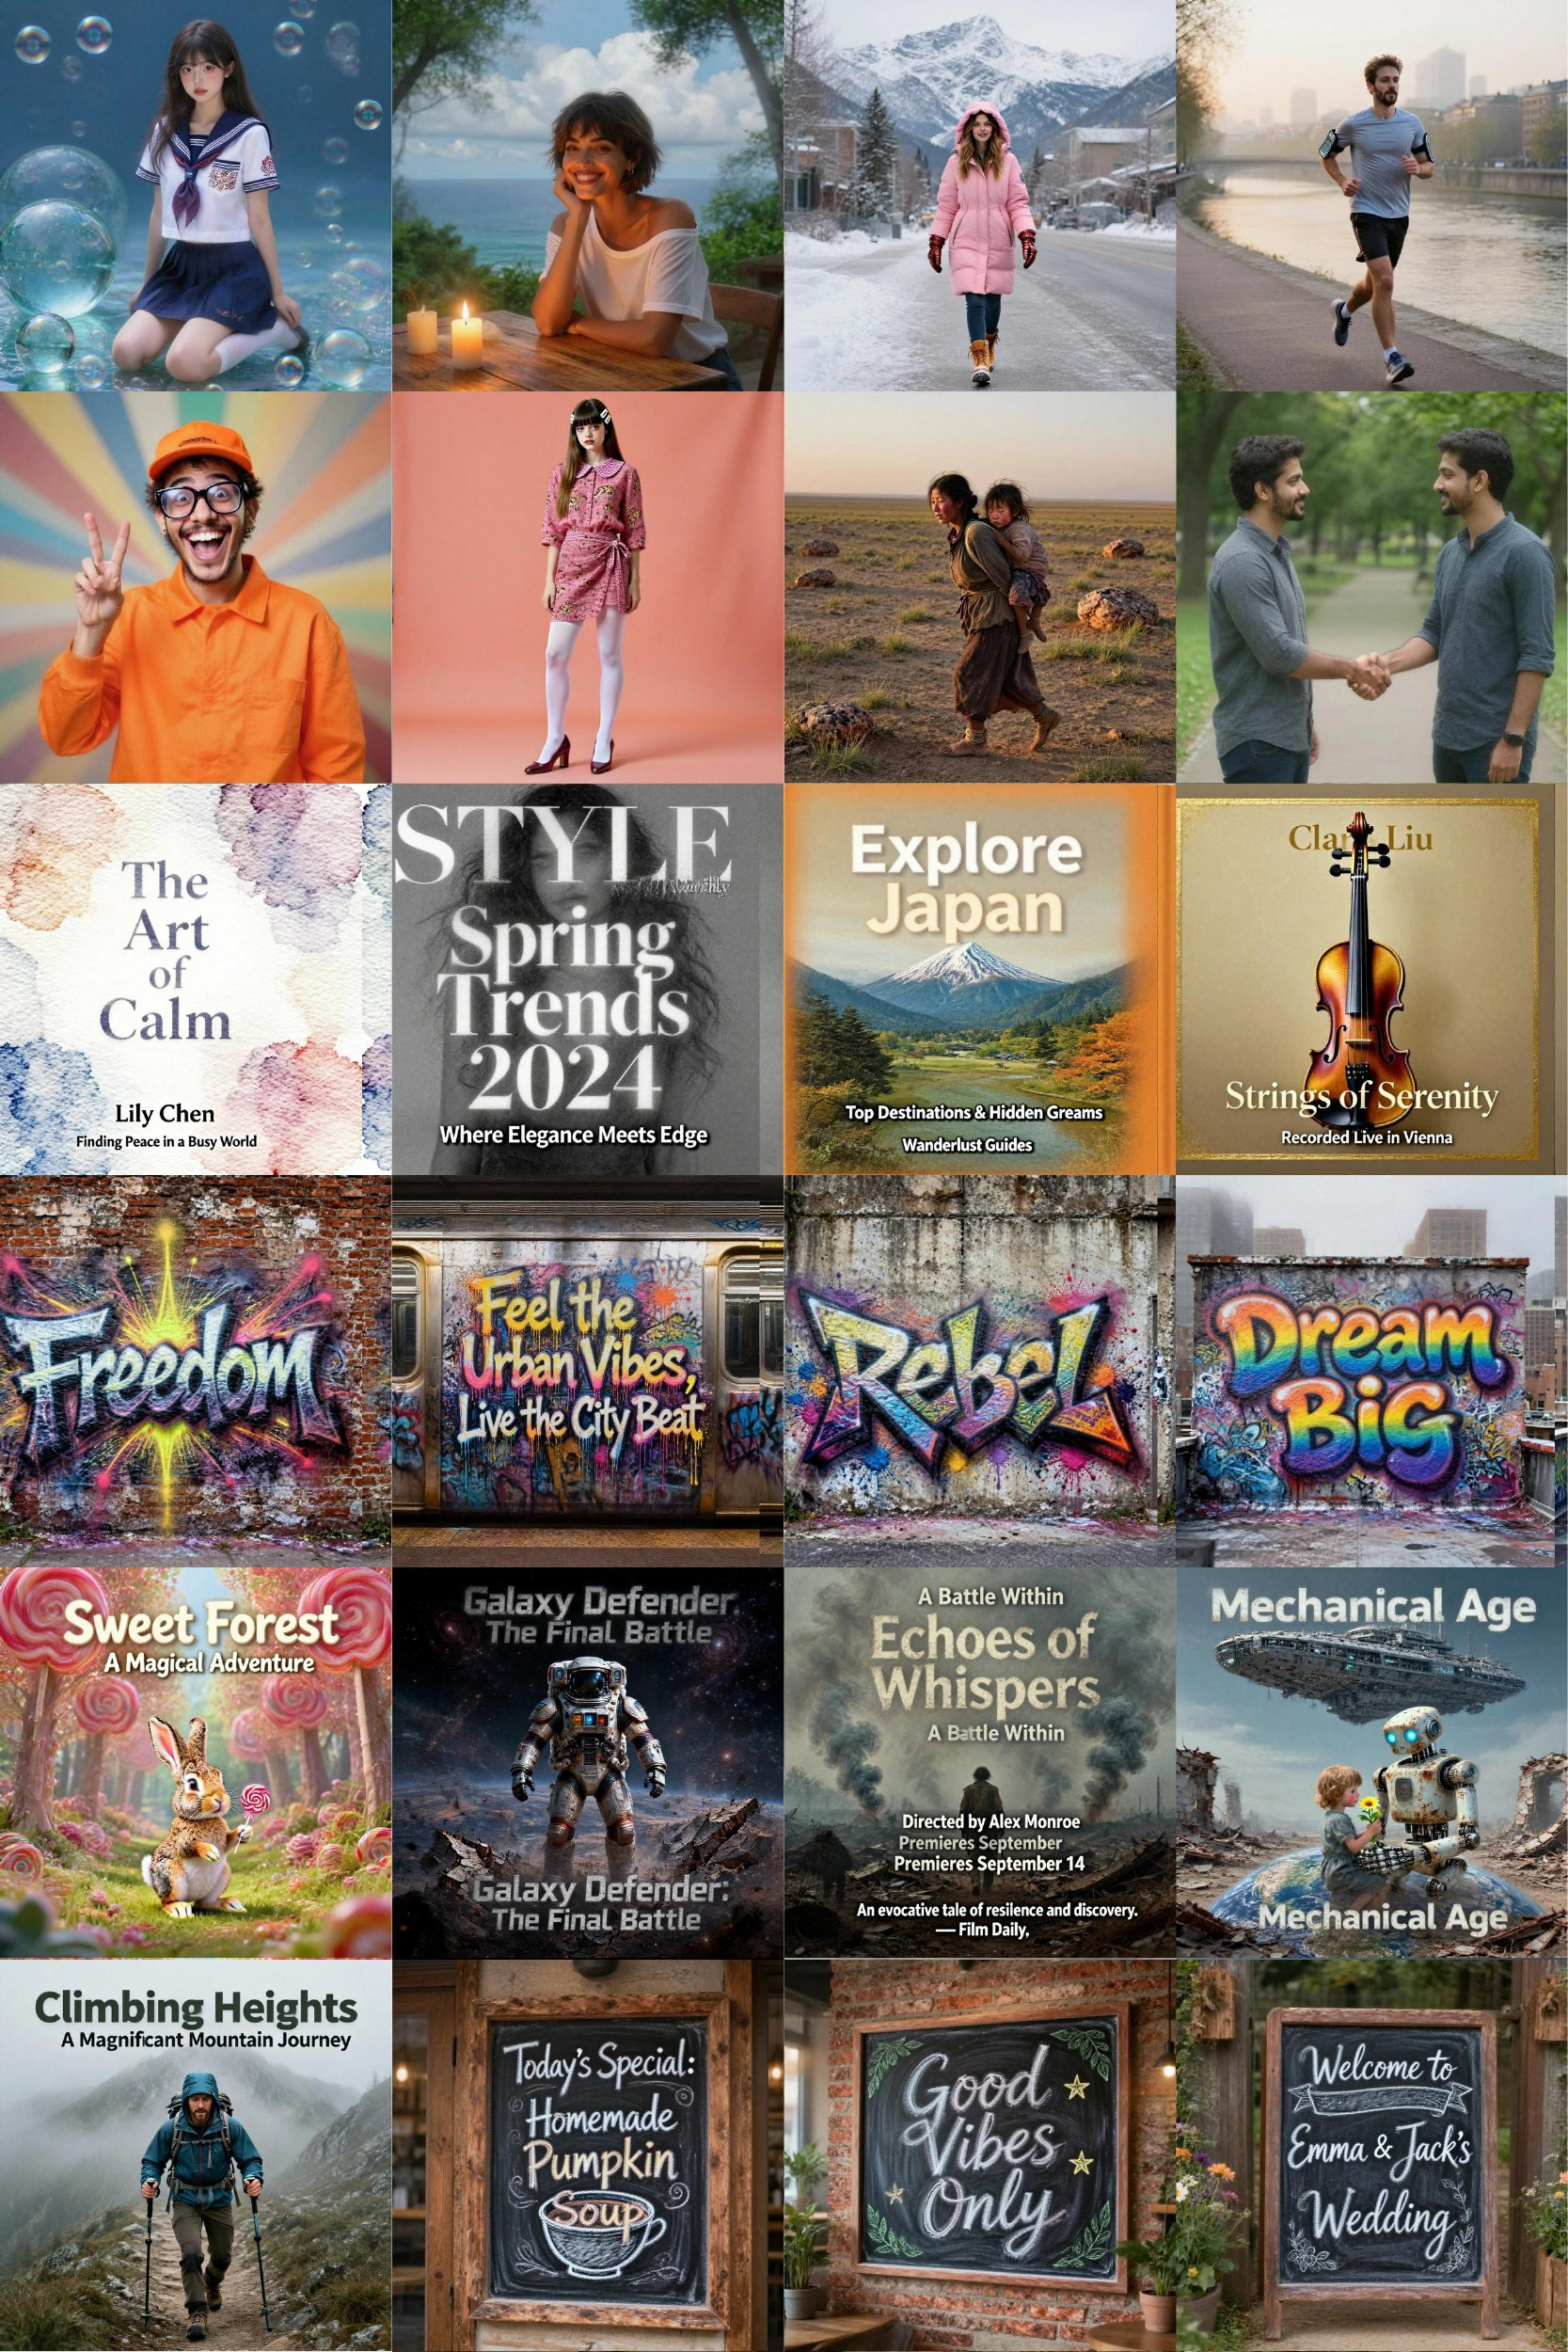
Inclusion AI와 여러 대학, 연구기관 소속 연구진이 이미지 생성 모델을 가르치는 새 기법 ‘Intrinsic Distribution Matching(IDM)’을 공개했다. 계산을 한두 번만 해서 이미지를 만드는 모델의 정확도를 높이는 연구다. 연구진은 Z-Image 기반 모델이 두 번 계산으로 이미지를 0.30초에 만들었다고 밝혔다. 이미지 안에 영어와 중국어 글자를 넣는 시험에서도 성적이 좋아졌다고 설명했다.
0.3초에 만든 이미지, 글자도 정확할까
적은 횟수로 이미지를 만드는 모델은 결과를 다듬을 기회가 적다. 그 짧은 과정에서 사용자가 주문한 세부 사항까지 담아내야 한다. IDM은 이 문제를 학습 단계에서 다룬다. 연구진은 이미지에 긴 글을 넣는 시험으로 글자가 얼마나 정확히 들어가는지 살폈다.
실험 대상은 모델 크기가 60억인 Z-Image-Turbo와 200억인 Qwen-Image다. Z-Image에 IDM을 적용한 모델은 두 번 계산하는 조건에서 글자 시험(LongText-Bench) 중국어 94.25%, 영어 90.20%를 기록했다. 논문에서 비교한 같은 계산 횟수의 방법 가운데 가장 높은 점수라고 연구진은 밝혔다. 0.30초는 연구진이 그래픽카드(A100) 한 대에서 직접 측정한 시간이다.
기존 학습법에 무엇을 더했나
기존 방식인 분포 매칭 증류(DMD)는 모델이 만든 이미지의 전체 특성이 기준 이미지에 가까워지도록 가르치는 방법이다. 예전에는 이미지의 특성을 추정하려고 별도 신경망을 붙였다. IDM은 앞선 연구인 TwinFlow와 APEX처럼 이미지를 만드는 모델 내부의 신호를 그대로 쓴다. 여기에 만들어진 이미지 특징값의 평균과 퍼진 정도를 기준에 맞추는 조건을 더했다.
기준값은 모델 자신의 상태를 누적해 반영한 복사본에서 얻는다. 외부에서 특징을 뽑아내는 장치를 따로 붙일 필요가 없다는 설명이다. 이 계산은 학습할 때만 하고, 실제로 이미지를 만들 때는 하지 않는다. 같은 조건으로 학습한 DMD 대조군과 비교하면 다섯 가지 평가 지표에서 모두 앞섰다. 다만 DPG-Bench에서는 APEX의 점수가 IDM보다 높았다.
지금 직접 쓸 수 있나
지금 받을 수 있는 것은 논문과 이미지 생성용 코드다. 10월 30일 기준 공식 저장소에는 학습을 마친 모델 파일이 ‘공개 예정’으로 표시돼 있다. 코드만으로는 논문에 실린 IDM 결과를 그대로 재현하기 어렵다. 코드는 Apache 2.0 라이선스로 공개됐고, 모델 파일에는 나중에 별도 라이선스가 붙는다.
한글은 어떨까. 공식 자료의 글자 시험과 예시는 영어와 중국어만 다룬다. 한국어 글자 생성 성능이나 국내 출시 계획은 나오지 않았다.
이번 연구는 짧은 생성 시간 안에 사용자가 요구한 세부 표현을 더 정확히 담는 데 초점을 뒀다. 이미지에 글을 넣으려는 이용자라면 속도와 함께 글자 정확도를 함께 볼 만하다. 실제로 써 볼 수 있을지는 모델 파일 공개와 이용 조건, 한국어 시험 결과에 달려 있다.