1시간 녹음 받아쓰고 번역까지, 엔비디아 Nemotron 3.5 공개
Nemotron 3.5 Transcribe는 받아쓰기, 화자 구분, 번역, 질문 답변을 한 모델에서 처리한다. 전문 용어에 맞춰 추가 학습할 수 있도록 Granary v2 데이터와 학습 도구도 함께 내놓았다.
엔비디아가 10월 28일 음성을 글로 바꾸는 모델 Nemotron 3.5 Transcribe를 공개했다. 여러 언어로 된 학습 데이터 Granary v2도 함께 내놓았다. 이 모델은 40개 언어를 받아쓴다. 이 가운데 31개 언어는 영어로, 또는 영어에서 번역한다. 누가 말했는지 구분하는 기능은 13개 언어에서 쓸 수 있다.
녹음을 쓰임새에 맞는 글로 바꾸는 것이 핵심이다. 최대 1시간짜리 녹음을 처리하고, 말하는 사람을 최대 8명까지 구분한다. AI에게 주는 지시문인 프롬프트로 발언자 표시를 요청하거나 영어 번역을 시킬 수 있다. 회의에서 어떤 결정이 나왔는지 묻는 것도 된다.
녹음 하나로 어디까지 되나
같은 모델에 지시만 달리 주면 필요한 형태의 글을 얻는다. 의료 녹음이라면 나올 법한 약 이름이나 검사명을 미리 알려줘 인식을 도울 수 있다. 단어마다 발언 시점을 표시하는 기능도 있다. 실시간 음성과 영상 플랫폼 기업 Agora는 이 기능으로 녹화 수업 재생 화면에 대본을 함께 띄우는 시연을 선보였다.
쓰임새에 따라 지원 언어는 다르다. 녹음 내용에 관해 묻고 답하는 기능은 영어로 학습했다. 실시간 중계가 아니라 이미 녹음된 파일을 처리하도록 만들어졌다. 엔비디아는 이름과 발언자가 바뀌는 지점, 질문에 대한 답을 원래 녹음과 대조해 점검하라고 안내했다.
받아쓰기 정확도는 얼마나 되나
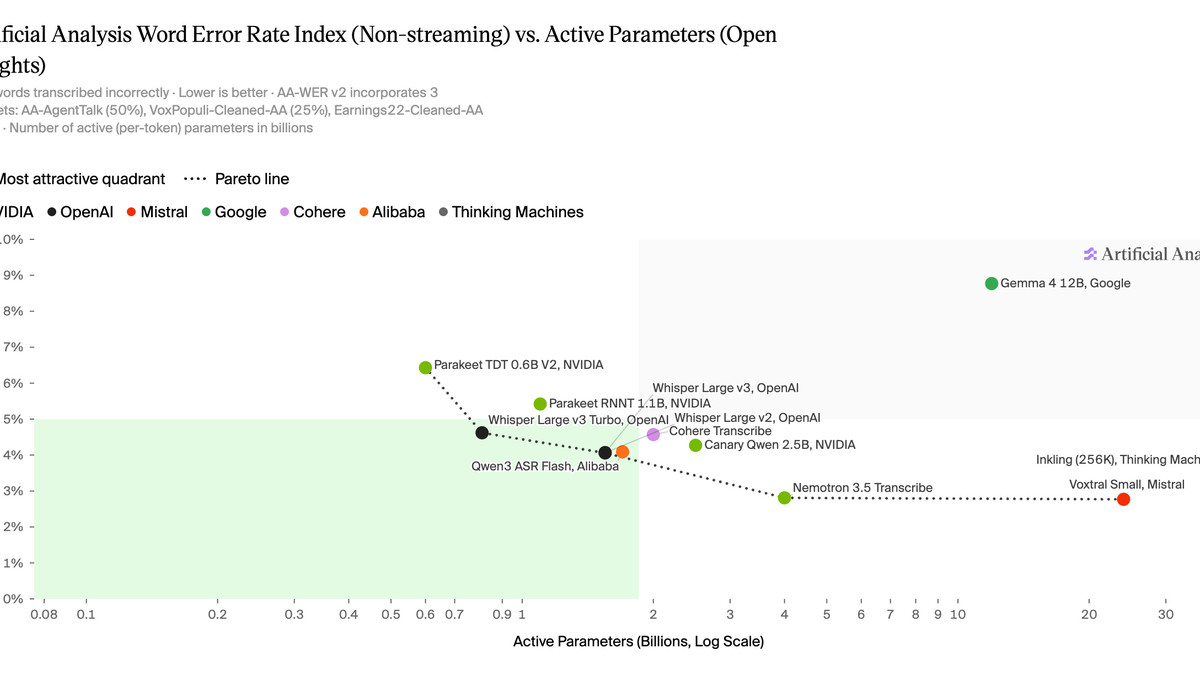
엔비디아는 허깅페이스의 영어 음성 인식 성능 시험에서 모델을 공개한 제품 가운데 1위를 기록했다고 밝혔다. 받아쓰기 실수 비율을 뜻하는 단어 오류율은 평균 5.33%였다. 숫자가 낮을수록 잘못 적은 단어가 적다는 뜻이다. 다른 기관인 Artificial Analysis의 평가에서는 같은 범주의 모델 중 공동 1위였고, 오류율은 2.8%로 나왔다.
이미지: huggingface.co
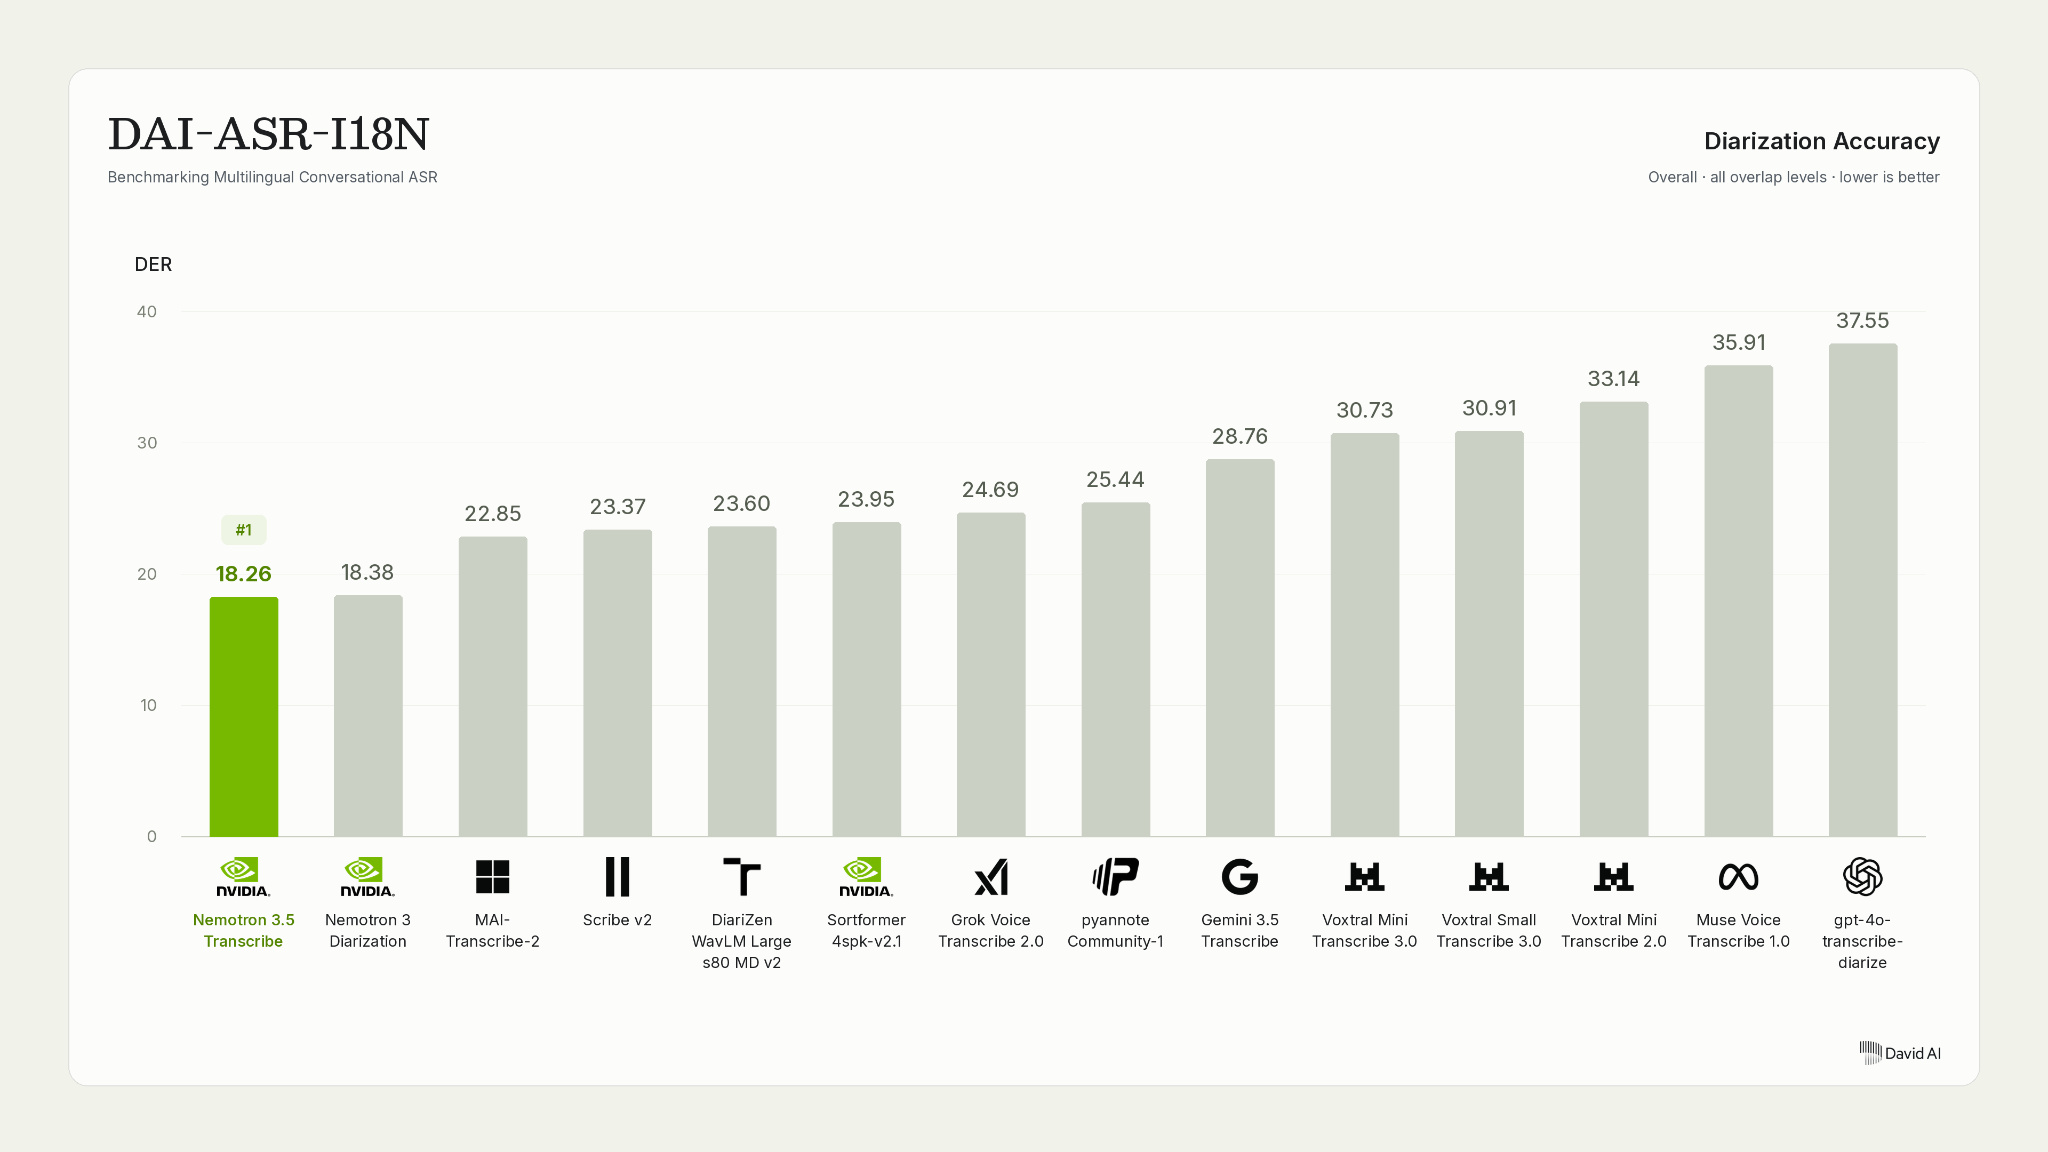
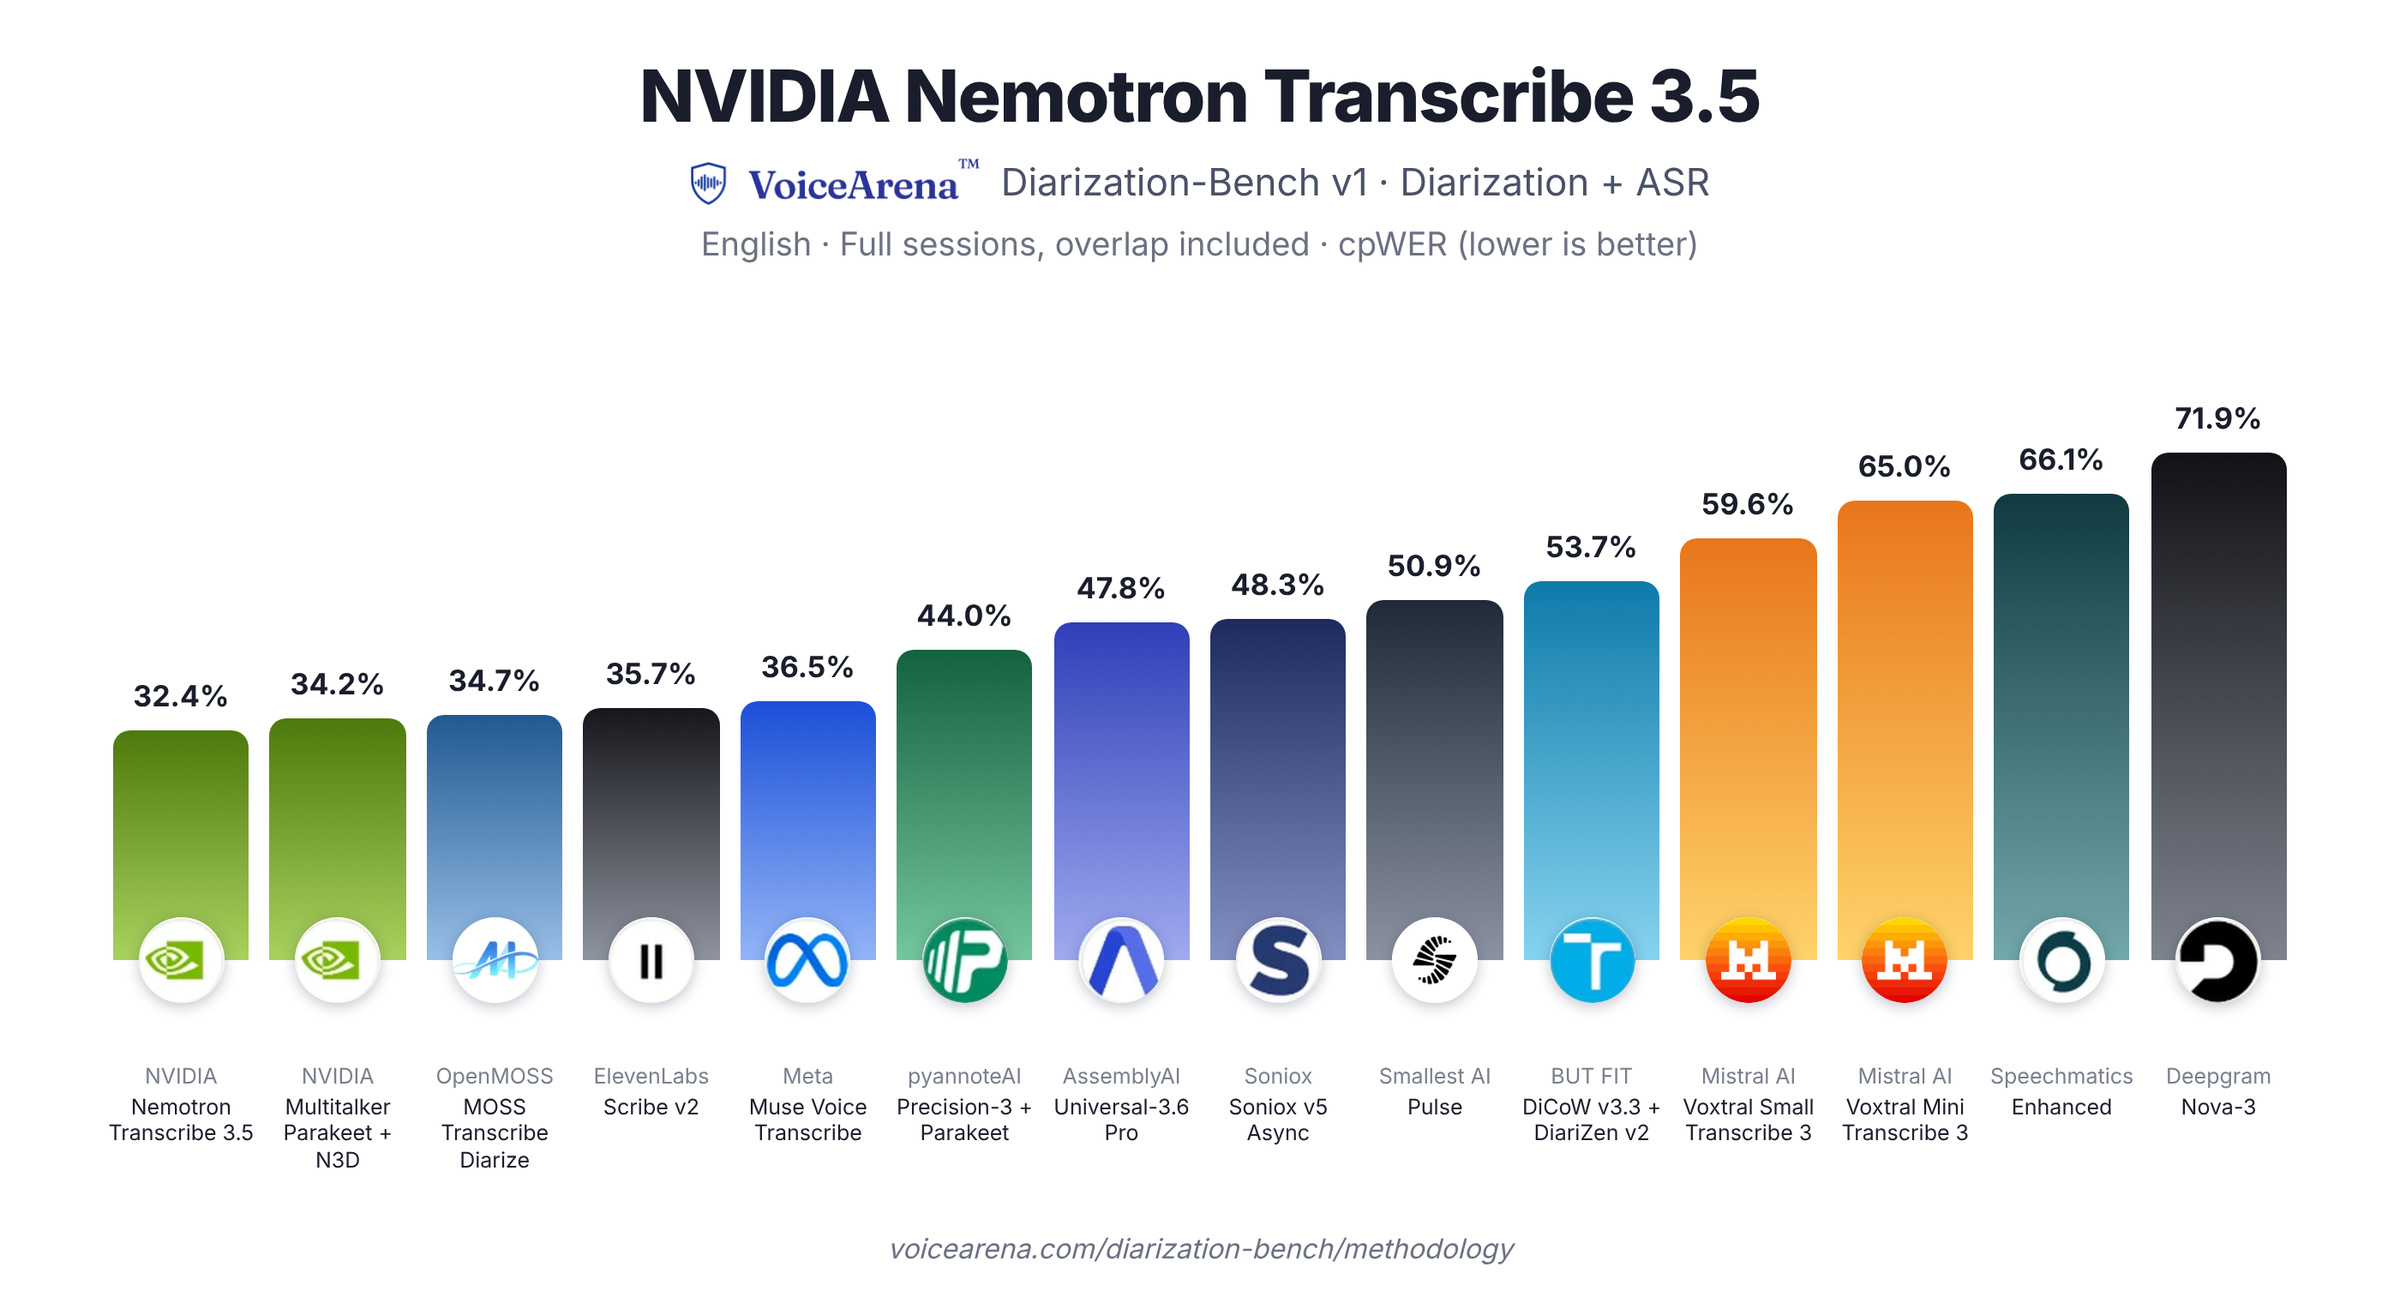
여러 사람이 말하는 녹음에서도 성적을 앞세웠다. 엔비디아에 따르면 David AI의 21개 언어 평가에서 시험한 14개 시스템 가운데 화자 구분 오류율이 가장 낮았다. 영어 회의 전체를 평가한 VoiceArena에서도 14개 시스템 중 1위였다. 처리 속도 시험에서는 GPU 한 대로 100시간 분량을 3분 안에 처리했다고 밝혔다. 출시 예정인 가벼운 버전으로 30초짜리 음성을 한꺼번에 많이 돌린 결과다.
전문 용어에 맞춰 바꿀 수 있나
개발자는 허깅페이스와 ModelScope에서 모델을 내려받아 원하는 환경에서 돌릴 수 있다. 함께 공개한 Granary v2는 48개 언어, 46만3062시간 분량의 데이터 목록을 담았다. 이전 버전인 Granary v1의 25개 언어보다 범위가 넓어졌다. 원본 음성은 각 데이터의 이용허락 조건에 따라 따로 내려받아야 한다.
이미지: huggingface.co
전문 분야의 말투와 표기법에 맞추려면 NeMo Speech 도구로 추가 학습을 시키면 된다. 엔비디아는 의료 음성 사례에서 학습에 쓰지 않은 화자들을 평가한 결과, 가장 좋은 지시문을 썼을 때보다 단어 오류율이 45.8% 줄었다고 밝혔다. 이번 공개로 녹음을 글로 옮기는 데서 나아가 용어와 출력 형식을 업무에 맞출 길이 넓어졌다. 남은 과제는 쓰는 사람의 언어와 녹음 환경에서도 이런 성능이 그대로 나오느냐다.