지시문 바꾸자 AI 독창성 심사 정확도 93%→41%
Ai2가 연구 아이디어의 독창성을 평가하는 AI가 얼마나 믿을 만한지 시험했다. GPT-5.4는 같은 아이디어를 놓고도 지시문에 따라 정확도가 93.5%에서 40.9%로 떨어졌다.
Ai2가 10월 27일(현지시간) 연구 ‘Old Ideas, Novel Problems’를 공개했다. AI가 연구 아이디어의 독창성을 얼마나 일관되게 가려내는지 살핀 연구다. 성능 시험용 데이터와 코드, 새 평가 자료를 자동으로 만드는 도구도 함께 내놓았다. 연구진은 AI에게 주는 지시문인 프롬프트가 조금만 달라져도 같은 아이디어에 대한 평가가 크게 달라졌다고 밝혔다.
지시문 바꾸면 판정도 바뀔까
연구진은 GPT-5.1, GPT-5.2, GPT-5.4와 Claude Sonnet 4.5, Claude Opus 4.5, Claude Opus 4.6을 시험했다. 아이디어 하나에 독창성 점수를 매기게 하거나, 두 아이디어 중 더 새로운 쪽을 고르게 했다. 지시문, 생각에 들이는 자원, 관련 논문을 함께 주는지 여부를 하나씩 바꿔 가며 판정이 얼마나 흔들리는지 봤다.
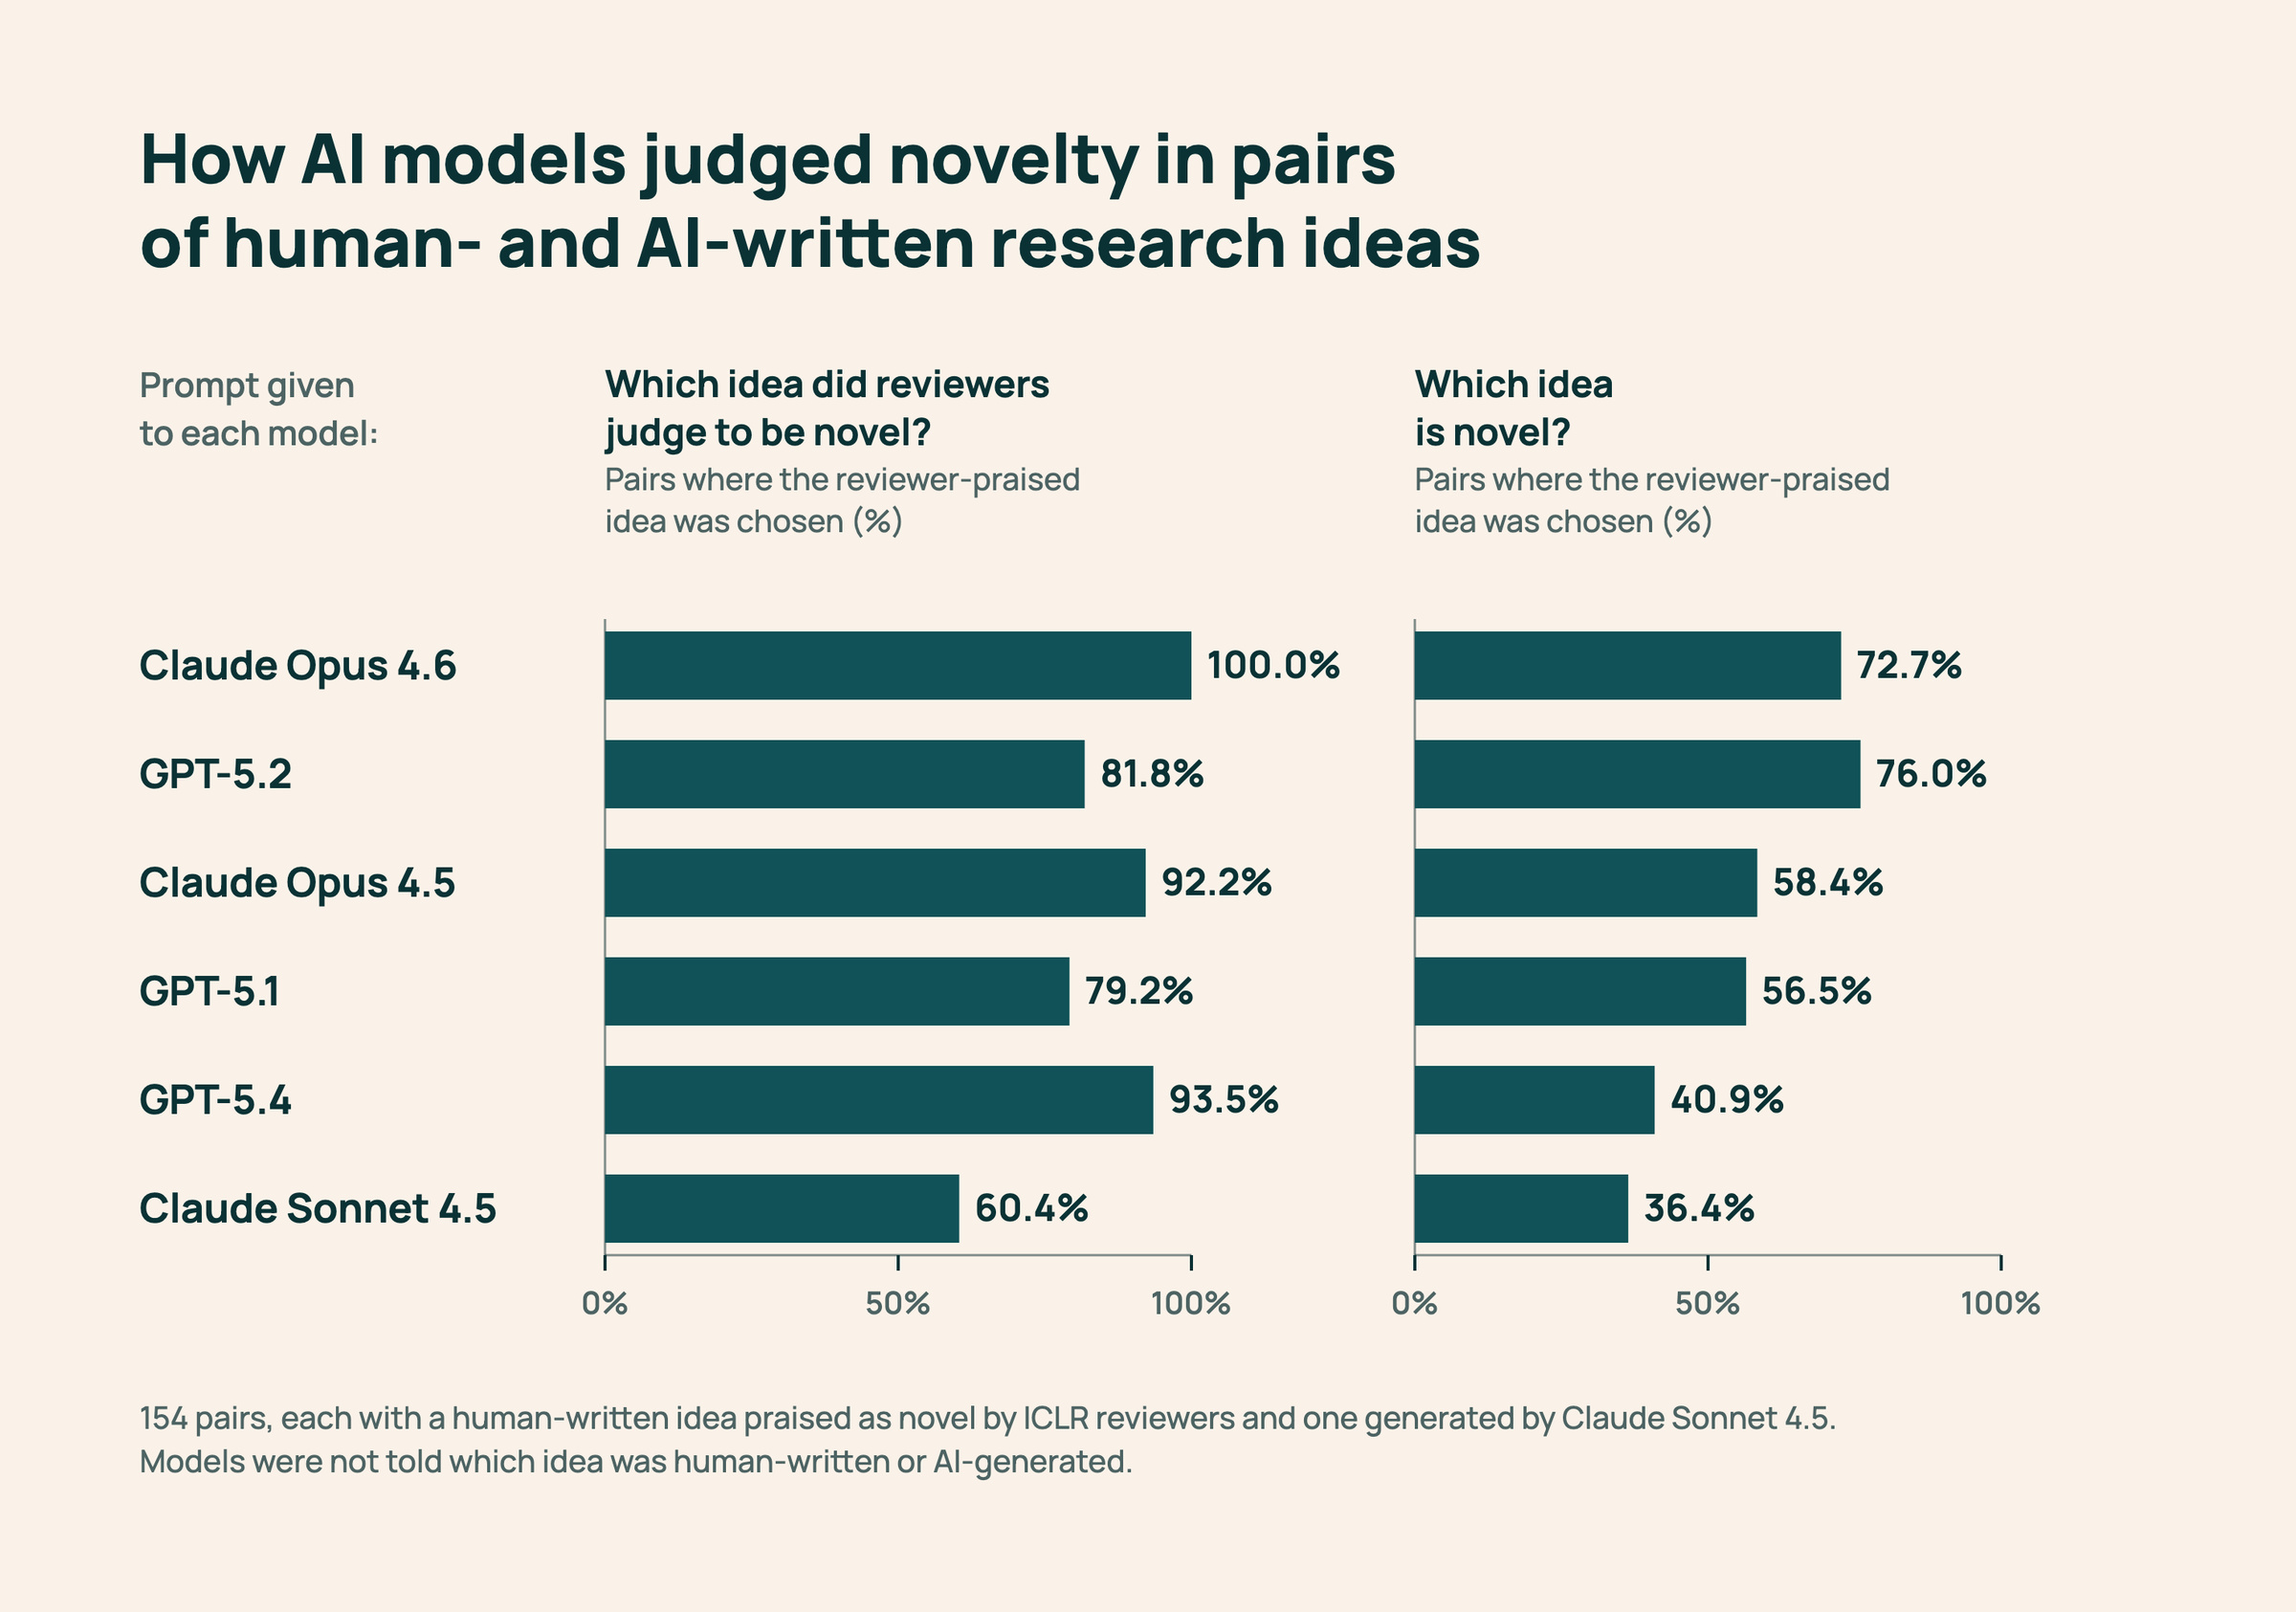
GPT-5.4는 사람이 낸 아이디어와 AI가 낸 아이디어를 비교할 때 지시문에 특히 민감했다. ‘심사자가 둘 중 정확히 하나를 독창적이라고 평가했다’는 조건을 붙이면 정확도가 93.5%였다. 반면 어느 아이디어가 독창적인지만 물으면 40.9%로 떨어졌다. 52.6%포인트 차이다. 같은 쌍의 절반 이상에서 선택이 뒤집혔다. 사람의 아이디어끼리 비교했을 때는 같은 변경에도 차이가 약 7%포인트에 그쳤다.
정답은 어떻게 정했나
평가 기준은 ICLR 2026 논문 심사평에서 뽑았다. 독창성이 높은 쪽으로는 분야별 평가 상위 10%에 든 채택 논문에서 아이디어 154개를 골랐다. 심사자가 독창성을 칭찬하고, 다른 심사자가 이를 반박하지 않은 경우다. 반대쪽에는 하위 10%의 탈락 논문 가운데 독창성에 의문이 제기되고 긍정적인 평가가 없었던 아이디어 145개를 모았다.
이미지: huggingface.co
AI가 만든 아이디어를 평가하는 시험에서는 앞서 고른 사람의 아이디어 154개와 AI의 아이디어 154개를 맞붙였다. AI에는 연구 분야와 새 아이디어를 내라는 지시만 주고, 논문 검색이나 고쳐 쓸 기회는 주지 않았다. 연구진은 이렇게 나온 AI 아이디어가 덜 독창적이라고 가정했고, 하나하나 검증하지는 않았다고 밝혔다. 별도로 전문가가 검토한 30쌍에서는 모두 사람의 아이디어를 더 높게 봤다. 다만 이 표본은 가장 성적이 좋은 평가 모델이 틀린 사례에 치우쳐 있었다.
더 비싼 평가가 더 정확할까
검색과 생각에 자원을 더 써도 결과가 일관되게 나아지지는 않았다. 연구진은 GPT-5.6 Sol에 넉넉한 사고 자원과 논문 사이트 arXiv를 반복 검색하는 기능을 줬다. 독창적인 아이디어와 그렇지 않은 아이디어를 가려내는 종합 점수는 0.78이었다. 미리 검색해 둔 초록 다섯 개만 읽은 Claude Opus 4.6은 0.89로 더 높았다. 연구진에 따르면 당시 개발자용 서비스 가격 기준으로 판정 한 번에 드는 비용은 약 10배였다.
이미지: huggingface.co
다른 비교에서는 간단한 지시만 받은 Claude Opus 4.6이 세 번의 답을 다수결로 모아 0.854점을 기록했다. 전체 평가 비용은 2.59달러였다. 같은 모델을 쓴 전용 평가 도구 Idea Novelty Checker는 0.642점에 30.66달러, Sakana AI의 AI Scientist는 0.772점에 82.05달러였다. 전용 도구들은 판정마다 한 번씩 돌렸다. 이 시험에서는 간단한 방식이 정확도와 비용 모두 앞섰다.
AI에게 연구 주제를 골라 달라고 할 때는 어떤 지시문을 쓰는지, 무엇을 평가하게 하는지가 결과를 좌우한다는 뜻이다. 사람의 논문에서 안정적으로 보이던 평가가 AI 아이디어에서는 이어지지 않았다고 연구진은 설명했다. 연구진은 공개한 도구를 다른 학술 공동체와 새로운 심사평에도 쓸 수 있다고 밝혔다.