리퀴드AI, 기기에서 보고 듣고 답하는 LFM3 공개
글, 이미지, 음성을 다루는 20억 규모 모델 6종이다. GPU 한 대로 자기 데이터를 추가 학습하고, 서비스가 돌아가는 기기에서 바로 실행하도록 만들었다.
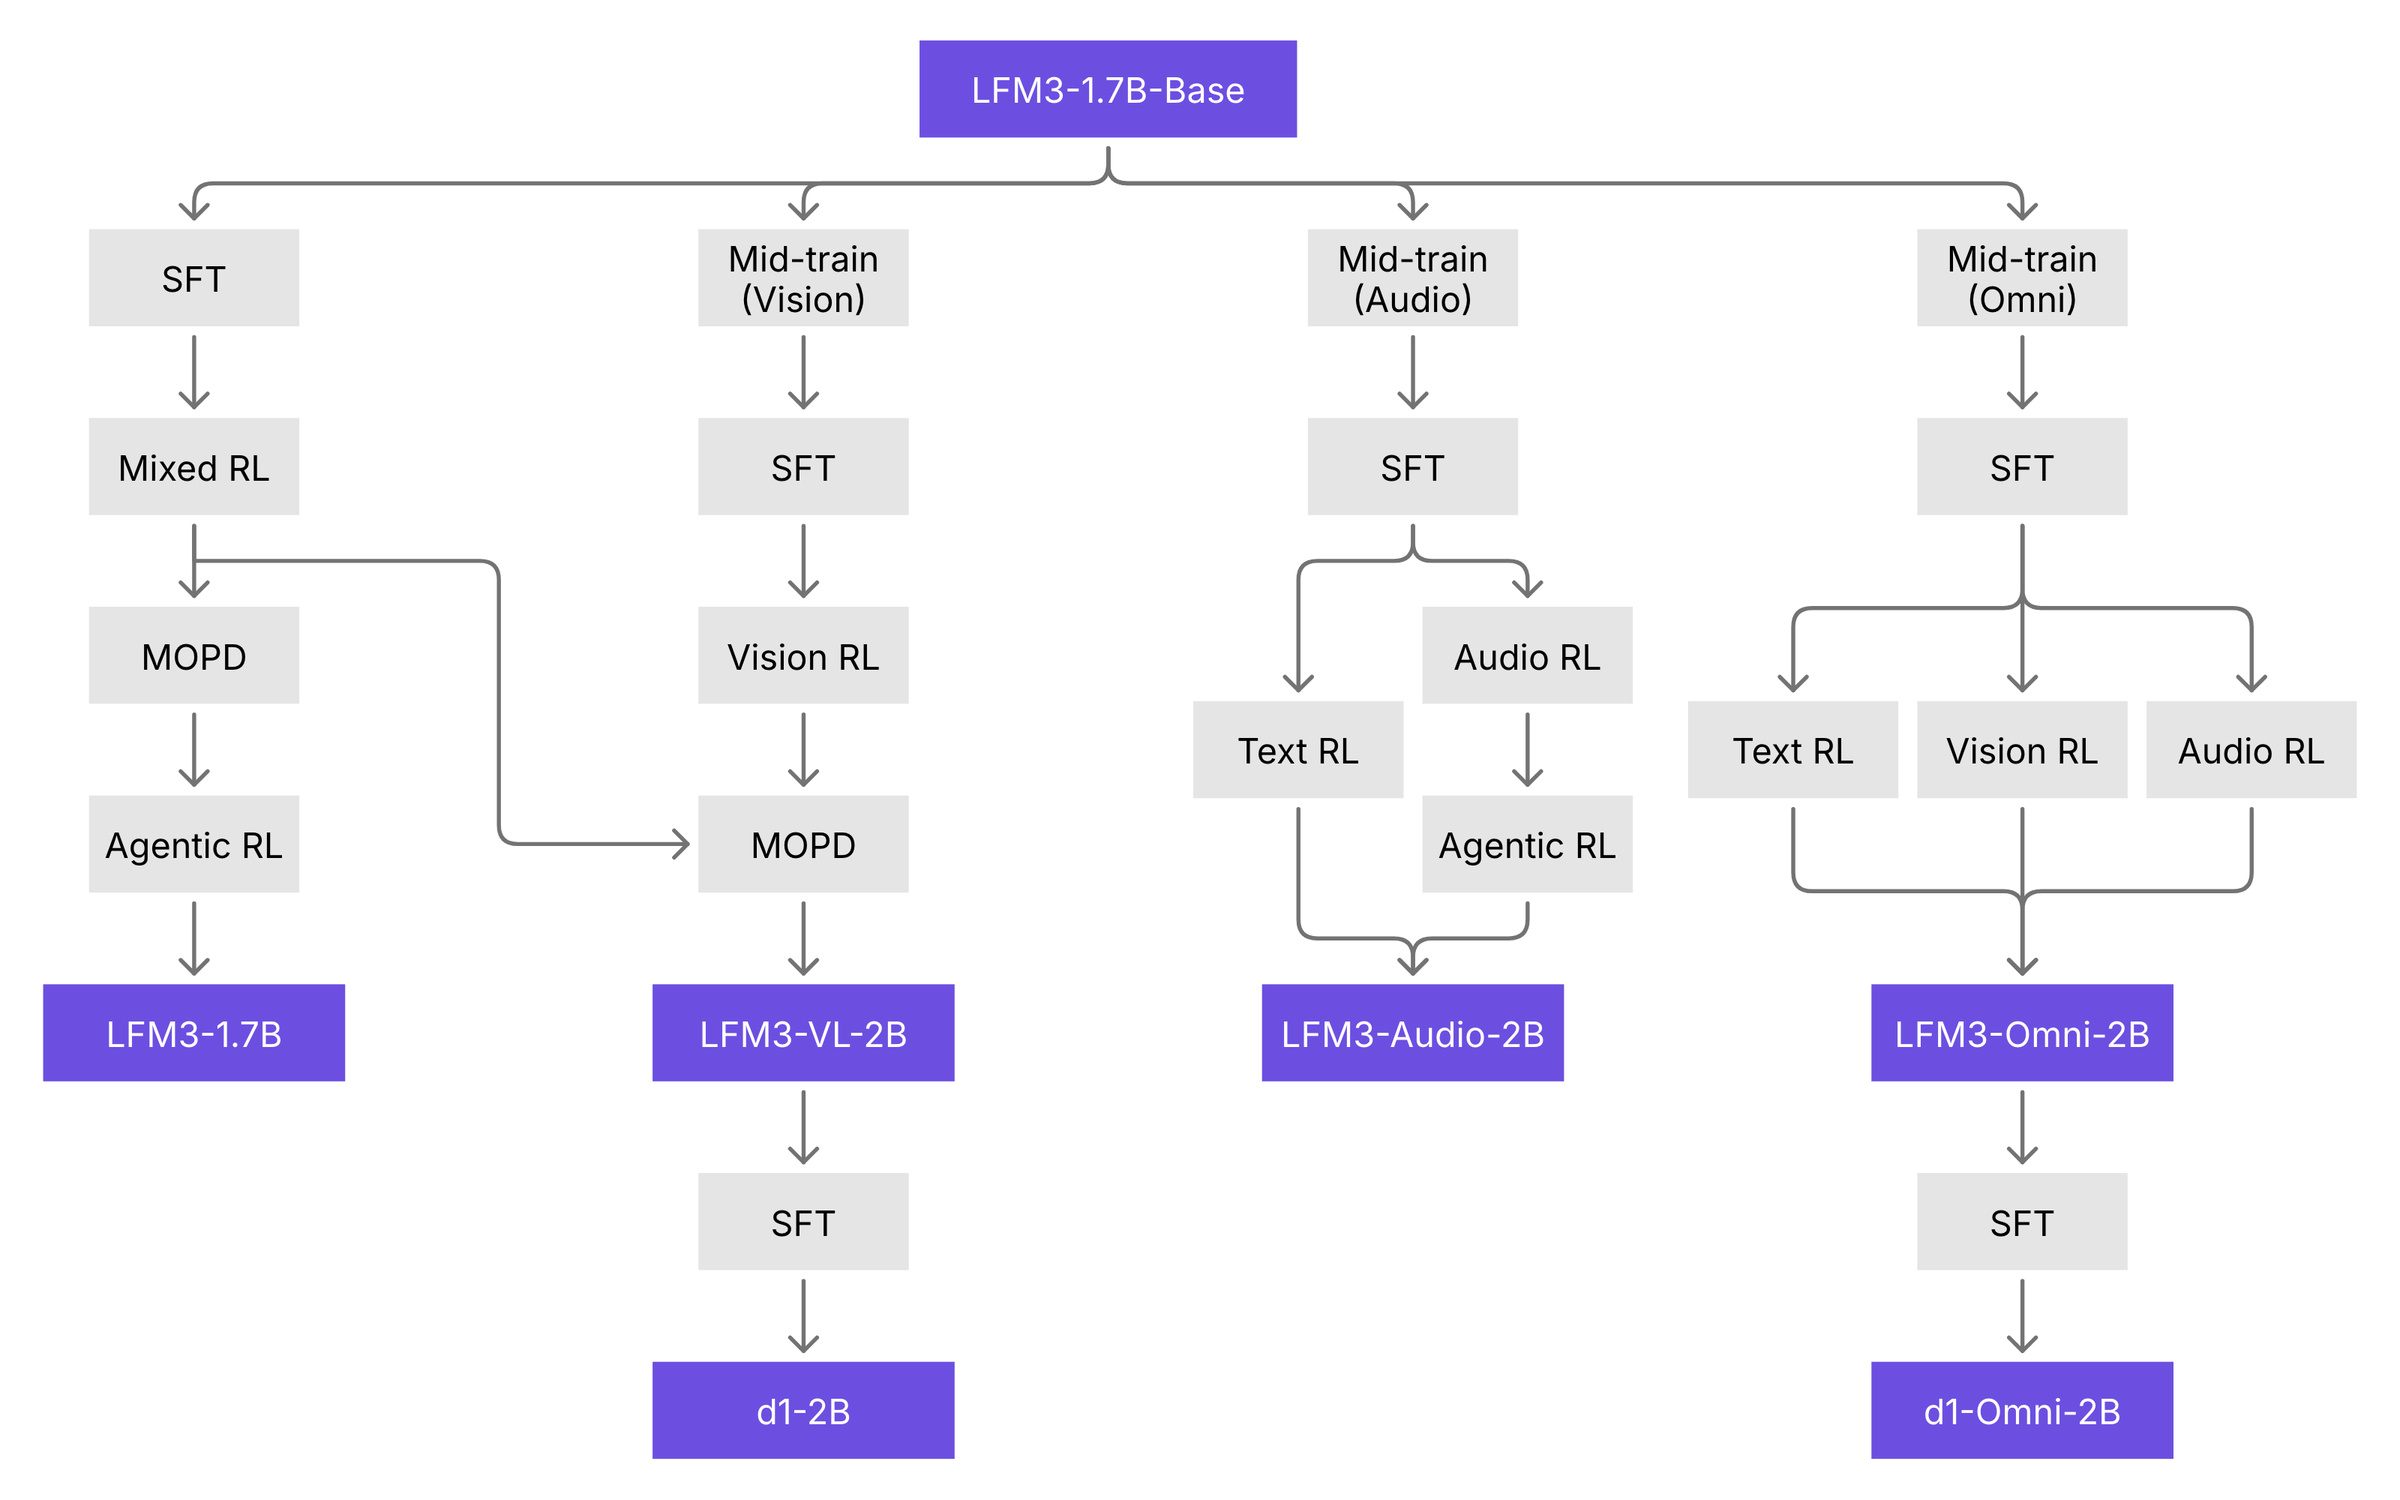
리퀴드AI(LiquidAI)가 10월 27일(현지시간) 기기에서 바로 돌아가는 맞춤형 AI 모델군 LFM3를 공개했다. 글, 이미지, 음성, 판단 작업을 각각 맡는 20억 규모 모델 6종이 같은 기반 모델에서 출발한다. 리퀴드AI는 모든 모델을 GPU 한 대로 추가 학습해 회사마다 쓰는 데이터와 업무 용어에 맞출 수 있다고 밝혔다.
작은 모델 6종, 어떻게 골라 쓰나
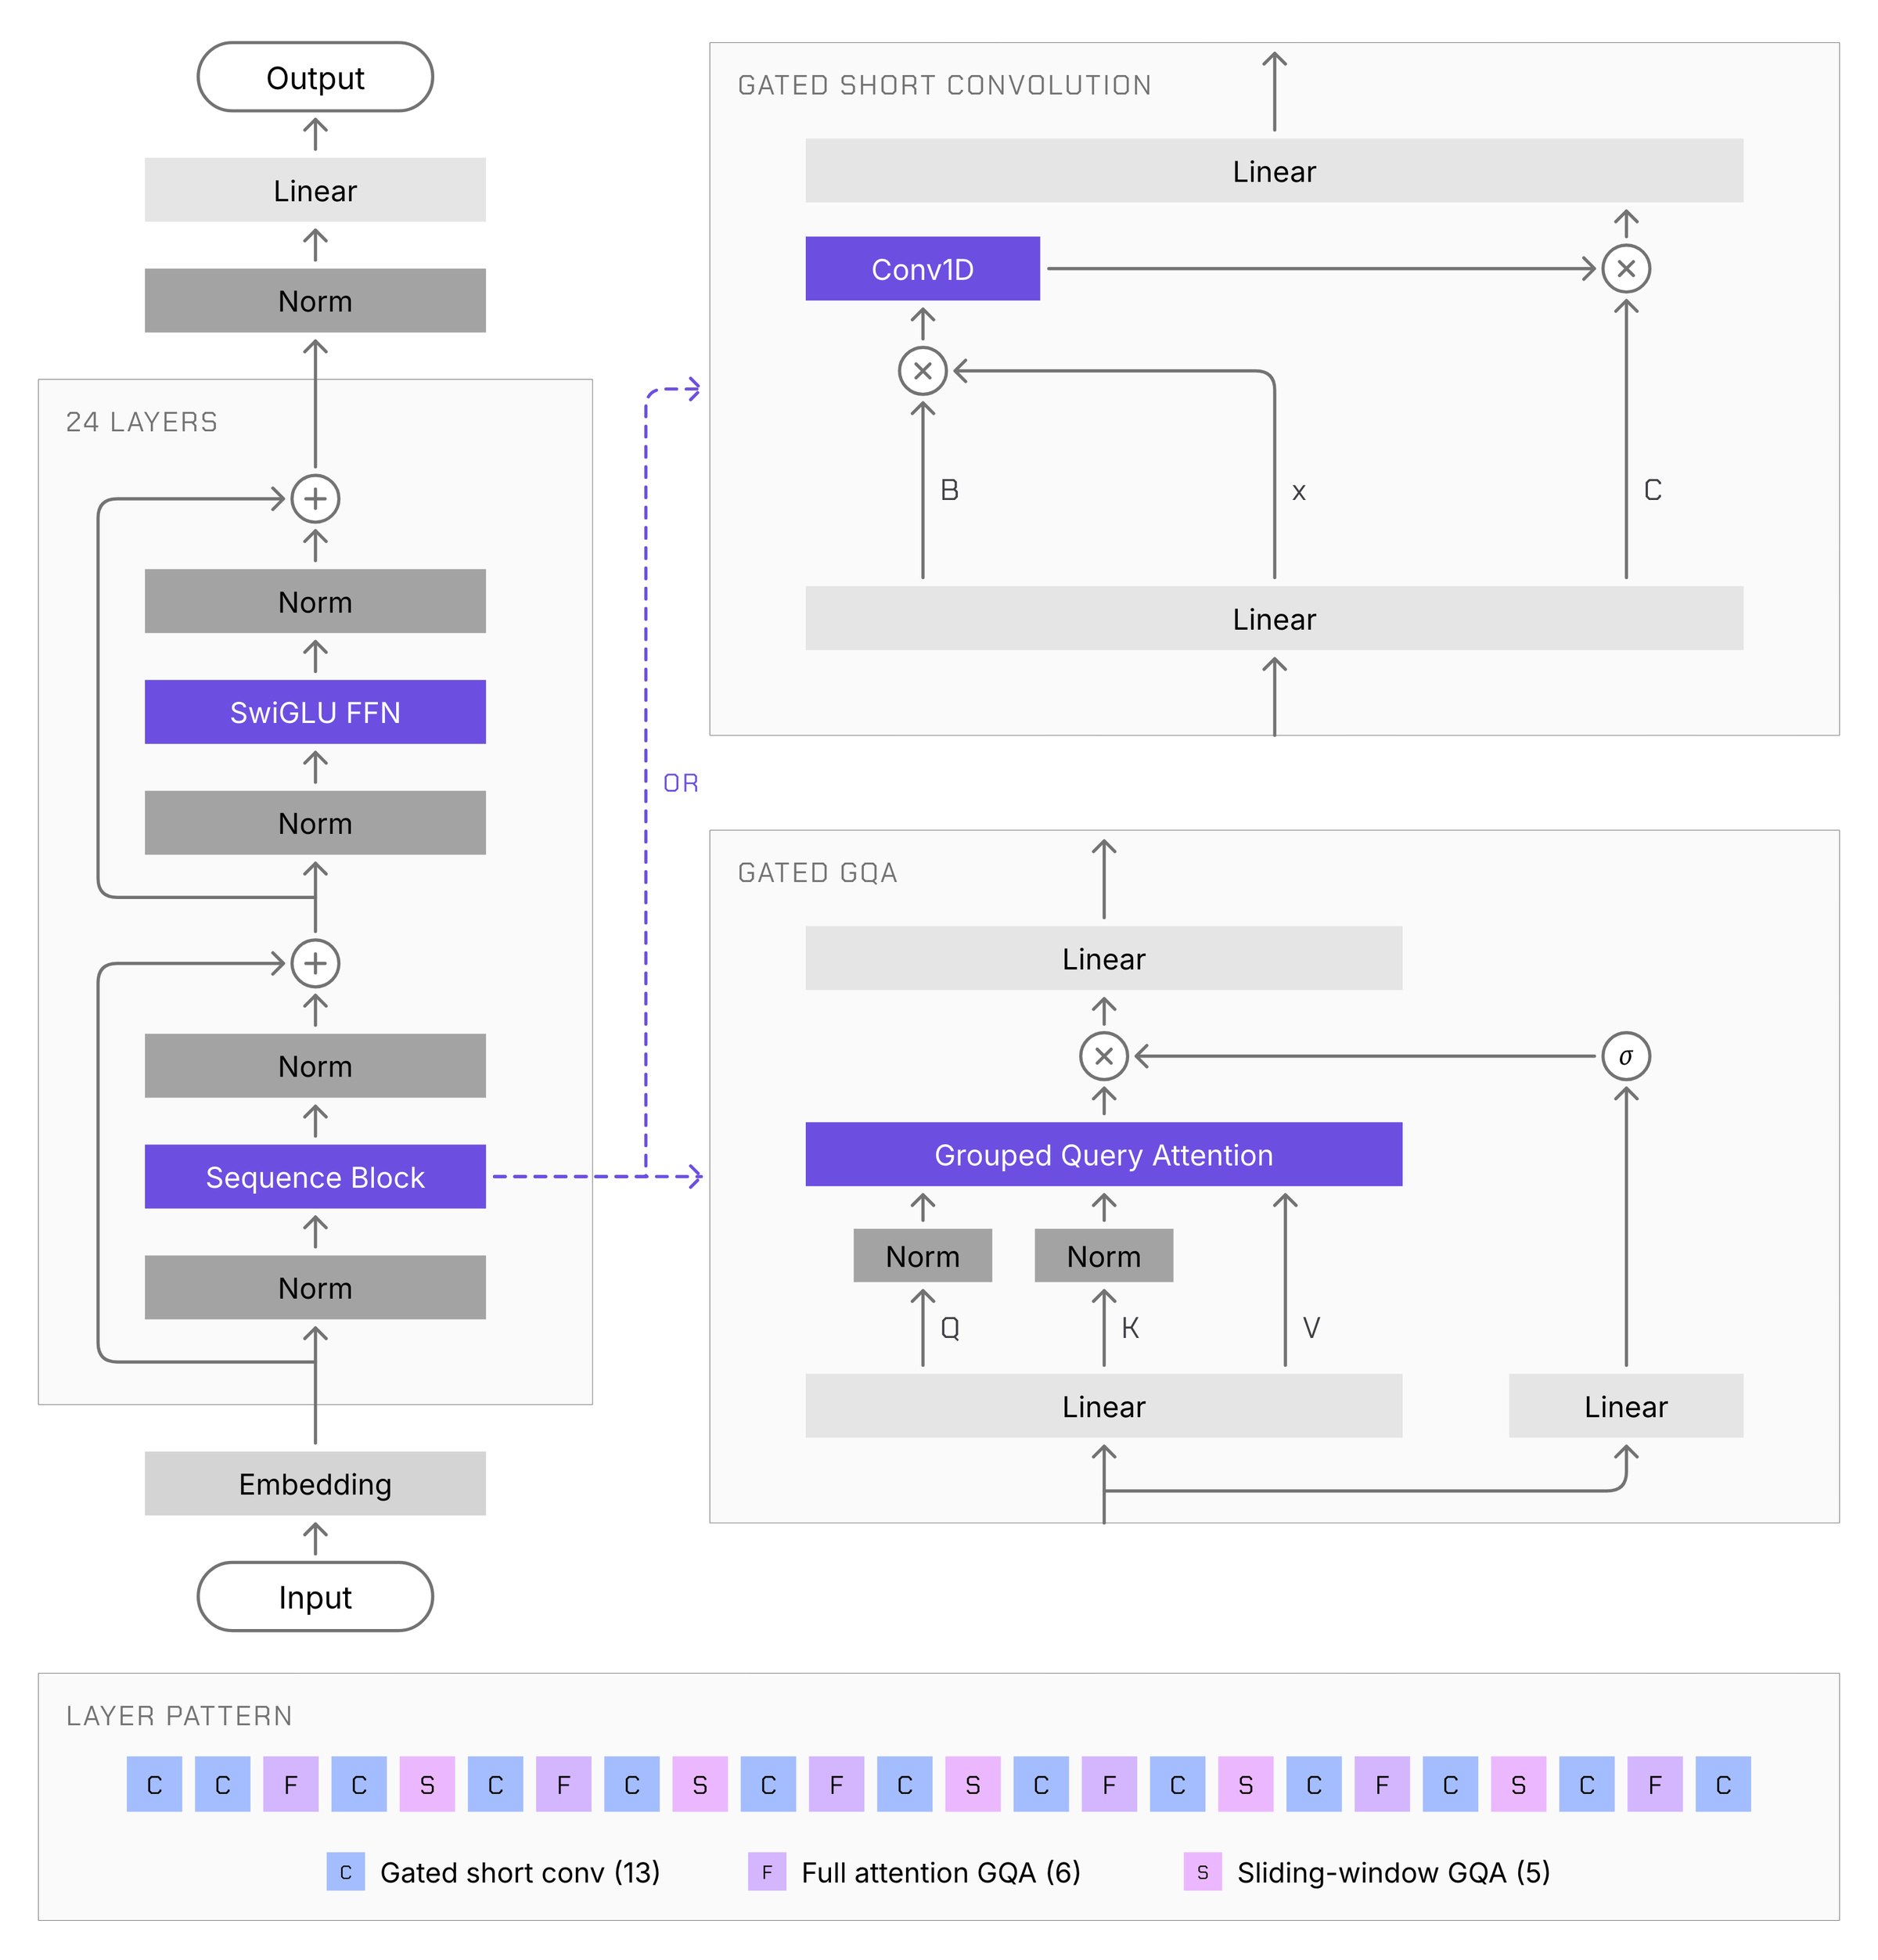
입력 자료와 하려는 일에 맞는 모델을 골라 쓰는 방식이다. 문서를 읽거나 도구를 다루는 일에는 텍스트 모델을 쓰고, 화면이나 영상을 이해하는 일에는 시각 모델을 쓴다. 리퀴드AI는 스마트폰부터 노트북, 클라우드까지 14가지 기기와 실행 환경 조합을 놓고 모델 구조를 찾았다고 설명했다.
텍스트 모델 LFM3-1.7B는 스스로 일을 처리하는 AI(에이전트)를 겨냥했다. 외부 도구를 불러오거나 정해진 형식으로 답하는 기능을 갖췄다. 리퀴드AI에 따르면 모델을 4비트로 압축하면 용량이 약 1GB로 줄어든다. 한 번에 읽을 수 있는 분량도 늘려, 긴 자료를 다루는 일까지 기기 안에서 처리하도록 설계했다.
이전 모델보다 얼마나 나아졌나
리퀴드AI는 텍스트 모델의 크기를 줄이면서 일 처리 성능은 높였다고 밝혔다. LFM3-1.7B는 이전 모델인 LFM2.5-2.6B보다 크기가 35% 작다. 웹에서 주어진 일을 해내는 능력을 재는 성능 시험 WebArena-Verified에서는 점수가 3.02에서 38.42로 올랐다고 제시했다. 브라우저와 업무용 앱에서 오래 걸리는 작업을 맡겼을 때는 Qwen3.5-9B보다 좋은 결과를 냈다고 주장했다.
이미지: huggingface.co
시각 모델 LFM3-VL-2B는 LFM 시각 모델 가운데 처음으로 동영상을 입력받는다. 사물을 찾아내고 어디에 놓였는지 파악하는 기능도 들어갔다. 리퀴드AI는 이전 모델인 LFM2.5-VL-3B의 31억 규모를 19억으로 줄였다고 설명했다. 그러면서 시각 성능 시험 62개의 평균 점수는 57.6에서 71.4로 올랐고, 6배 이상 큰 Gemma 4 12B와 비슷한 수준이라고 밝혔다.
사진을 보여주며 말로 묻는다
LFM3-Audio-2B는 노트북이나 기기에서 음성 대화, 음성 인식, 음성 합성, 18개 언어 사이의 번역을 맡는 모델이다. 글이나 소리를 받아 글과 음성으로 답하고, 말로 받은 요청을 도구 호출로 바꿀 수 있다. 리퀴드AI는 이전 버전보다 음성 품질을 높였고, 소리의 내용을 이해해 판단하는 기능을 새로 넣었다고 설명했다.
이미지: huggingface.co
리퀴드AI의 첫 Omni 모델인 LFM3-Omni-2B는 보고 듣고 말하는 기능을 한 모델에 모았다. 사진을 보여주며 말로 묻거나, 동영상의 화면과 소리를 함께 이해하는 데 쓴다. 음성 인식, 이미지 이해, 답변 작성, 음성 합성에 각각 다른 모델을 붙여 쓰던 구성을 하나로 대신할 수 있다는 것이 리퀴드AI의 설명이다. 음성 답변은 만들어지는 대로 바로 들을 수 있다.
LFM3의 핵심은 필요한 기능만 골라 각자 업무에 맞추고, 그 모델을 실제 서비스가 돌아가는 기기에서 실행하는 방식이다. 개발팀에는 GPU 한 대로 추가 학습하는 길을, 이용자에게는 사진과 음성을 함께 쓰는 대화를 내놓았다. 국내 활용 가능성은 한국어 처리 품질과 이용 조건, 실제 기기에서의 속도와 메모리 사용량에 달렸다.