세레브라스, 조 단위 AI를 웨이퍼 여러 장에 나눠 돌리는 방식 공개
대형 모델의 각 층을 웨이퍼 여러 장에 나눠 올리고, 여러 이용자의 요청을 동시에 처리하는 구조다. Kimi K3를 예로 들면 웨이퍼 59장이 필요하다고 계산했다.
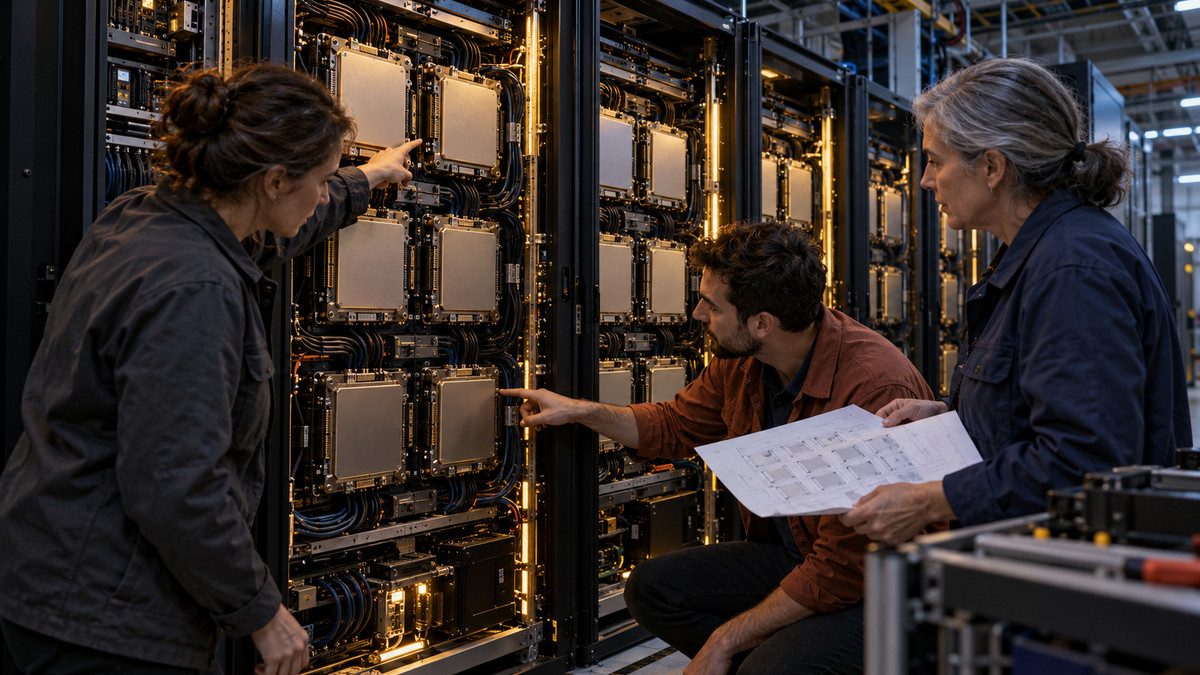
세레브라스가 10월 22일(현지시간) 조 단위 규모의 AI 모델을 여러 장의 웨이퍼에 나눠 실행하는 방식을 공개했다. 세레브라스의 칩인 WSE-3T 웨이퍼를 여러 장 묶어 쓰는 구조다. AI가 답을 만들 때 거치는 모델의 각 층을 웨이퍼마다 나눠 올려 둔다. 회사는 Kimi K3를 예로 들어 웨이퍼가 몇 장 필요한지 계산해 보였다.
큰 모델을 어떻게 나눠 돌리나
모델을 이루는 층과 학습된 수치인 가중치를 웨이퍼 내부 메모리에 올려 둔다. 층 사이에는 계산 결과만 주고받는다. 서로 다른 이용자의 요청은 처리 과정의 여러 단계에 나눠 동시에 진행한다. 회사는 한꺼번에 처리할 수 있는 요청 수가 주로 대화 내용을 저장하는 메모리 용량에 달려 있다고 설명했다.
웨이퍼 59장은 어떻게 나온 숫자인가
필요한 웨이퍼 수는 모델의 층 수와 층 종류에 따라 달라진다. 웨이퍼 한 장의 내부 메모리는 44GB다. 세레브라스가 내놓은 Kimi K3 예시는 가중치를 4비트로 압축하고, 대화 내용을 기억해 두는 캐시는 8비트로 저장하는 조건이다. 세레브라스는 층을 종류별로 웨이퍼에 나눠 배치해 모두 59장이 필요하다고 계산했다. 요청 하나의 평균 분량을 글자 조각 25만 6천 개로 잡은 가정은 동시에 처리할 수 있는 요청 수를 셀 때 쓴다.
초당 2,000개 속도, 어디까지 확인됐나
세레브라스는 수조 단위 규모의 모델에서 초당 글자 조각 1,000~2,000개 이상을 생성한다고 밝혔다. 실제 측정값이 공개된 사례는 그보다 작은 모델이다. 세레브라스는 2026년 5월 약 1조 규모의 Kimi K2.6을 기업 고객에게 시험 제공했다. 당시 외부에서 측정한 생성 속도는 초당 글자 조각 981개였다. GPU 기반 클라우드와 속도를 비교한 수치도 이 K2.6 시험에서 나왔다. 이번 글은 더 큰 모델의 층을 여러 웨이퍼에 배치하는 방법을 구체적으로 풀어 놓았다.
한국에서 언제 쓸 수 있나
세레브라스는 AI가 답을 만들어 주는 자사 클라우드에서 개발자가 서비스에 붙여 쓰는 방식을 무료로 시작할 수 있다고 안내한다. 무료 이용은 개발과 평가, 실험 용도이며 실제 서비스 운영용은 아니다. 기업이 따로 AI를 배포하려면 상담 창구를 이용하면 된다. 쓸 수 있는 모델과 용량, 성능은 이용 조건에 따라 달라진다고 밝혔다. Kimi K3의 이용 시작일이나 전용 가격은 밝히지 않았다.
한국 시장에서는 업스테이지와의 협력이 진행 방향으로 제시됐다. 세레브라스는 2026년 7월 업스테이지와 손잡고 한국에서 AI가 답을 만드는 기술의 활용을 추진한다고 발표했다. 이번에 설명한 Kimi K3 배치 방식의 한국 출시 일정이나 한국어 지원 조건은 밝히지 않았다.
큰 AI 모델을 돌리는 데 필요한 메모리와 장비 구성을 구체적인 숫자로 보여준 설명이다. AI를 업무에 붙여 쓰려는 기업이라면 모델 크기뿐 아니라 요청의 길이와 동시 처리량도 함께 따져볼 근거가 된다. 앞으로 볼 점은 이 방식이 실제 서비스에서 어떤 속도를 내는지, 이용 조건과 비용이 어떻게 정해지는지다.