업무 기록 채점해 AI 학습, 매번 성공한 과제 38개→107개
마이크로소프트와 허깅페이스가 "완료했다"는 답변 대신 데이터베이스에 남은 업무 기록이 맞는지를 보상으로 삼아 Qwen3.8-27B를 추가 학습했다. 과제 507개를 20번씩 시험한 결과, 20번 모두 성공한 과제가 38개에서 107개로 늘었다.
마이크로소프트와 허깅페이스가 10월 22일(현지시간) AI가 끝낸 작업 결과를 학습에 쓰는 ThinkingBox-Training을 깃허브에 공개했다. 두 회사는 데이터베이스에 남은 기록을 채점해 Qwen3.8-27B를 추가 학습했다. 그 결과 평균 성공률은 51.70%에서 60.78%로 9.08%포인트 올랐다.
“완료했다"는 답을 왜 믿지 않나
ThinkingBox는 스스로 일을 처리하는 AI(에이전트)가 작업을 마친 뒤, 데이터베이스 기록을 기대한 결과와 비교한다. 연구진이 앞서 소개한 사례에서는 AI가 고객 문의를 해결 처리했지만, 관련 배송 예외 사항은 미해결 상태로 남아 있었다. 도구를 그럴듯하게 썼는지보다 업무 기록이 실제로 맞는지가 평가 기준이다.
이번에는 이 채점 결과를 강화학습에 썼다. 강화학습은 성공한 행동에 보상을 줘 모델을 개선하는 방식이다. 연구진은 평가용 과제와 별도로 고른 187개 과제로 Qwen3.8-27B를 50단계 학습했다. 학습 전 모델의 성공 가능성을 살펴 연습할 과제를 정하고, 학습하는 동안에는 이 목록을 바꾸지 않았다. 모두 성공하거나 모두 실패하는 과제보다 성공과 실패가 섞인 과제에서 배울 거리가 많기 때문이라고 설명했다.
20번 모두 성공한 과제, 얼마나 늘었나
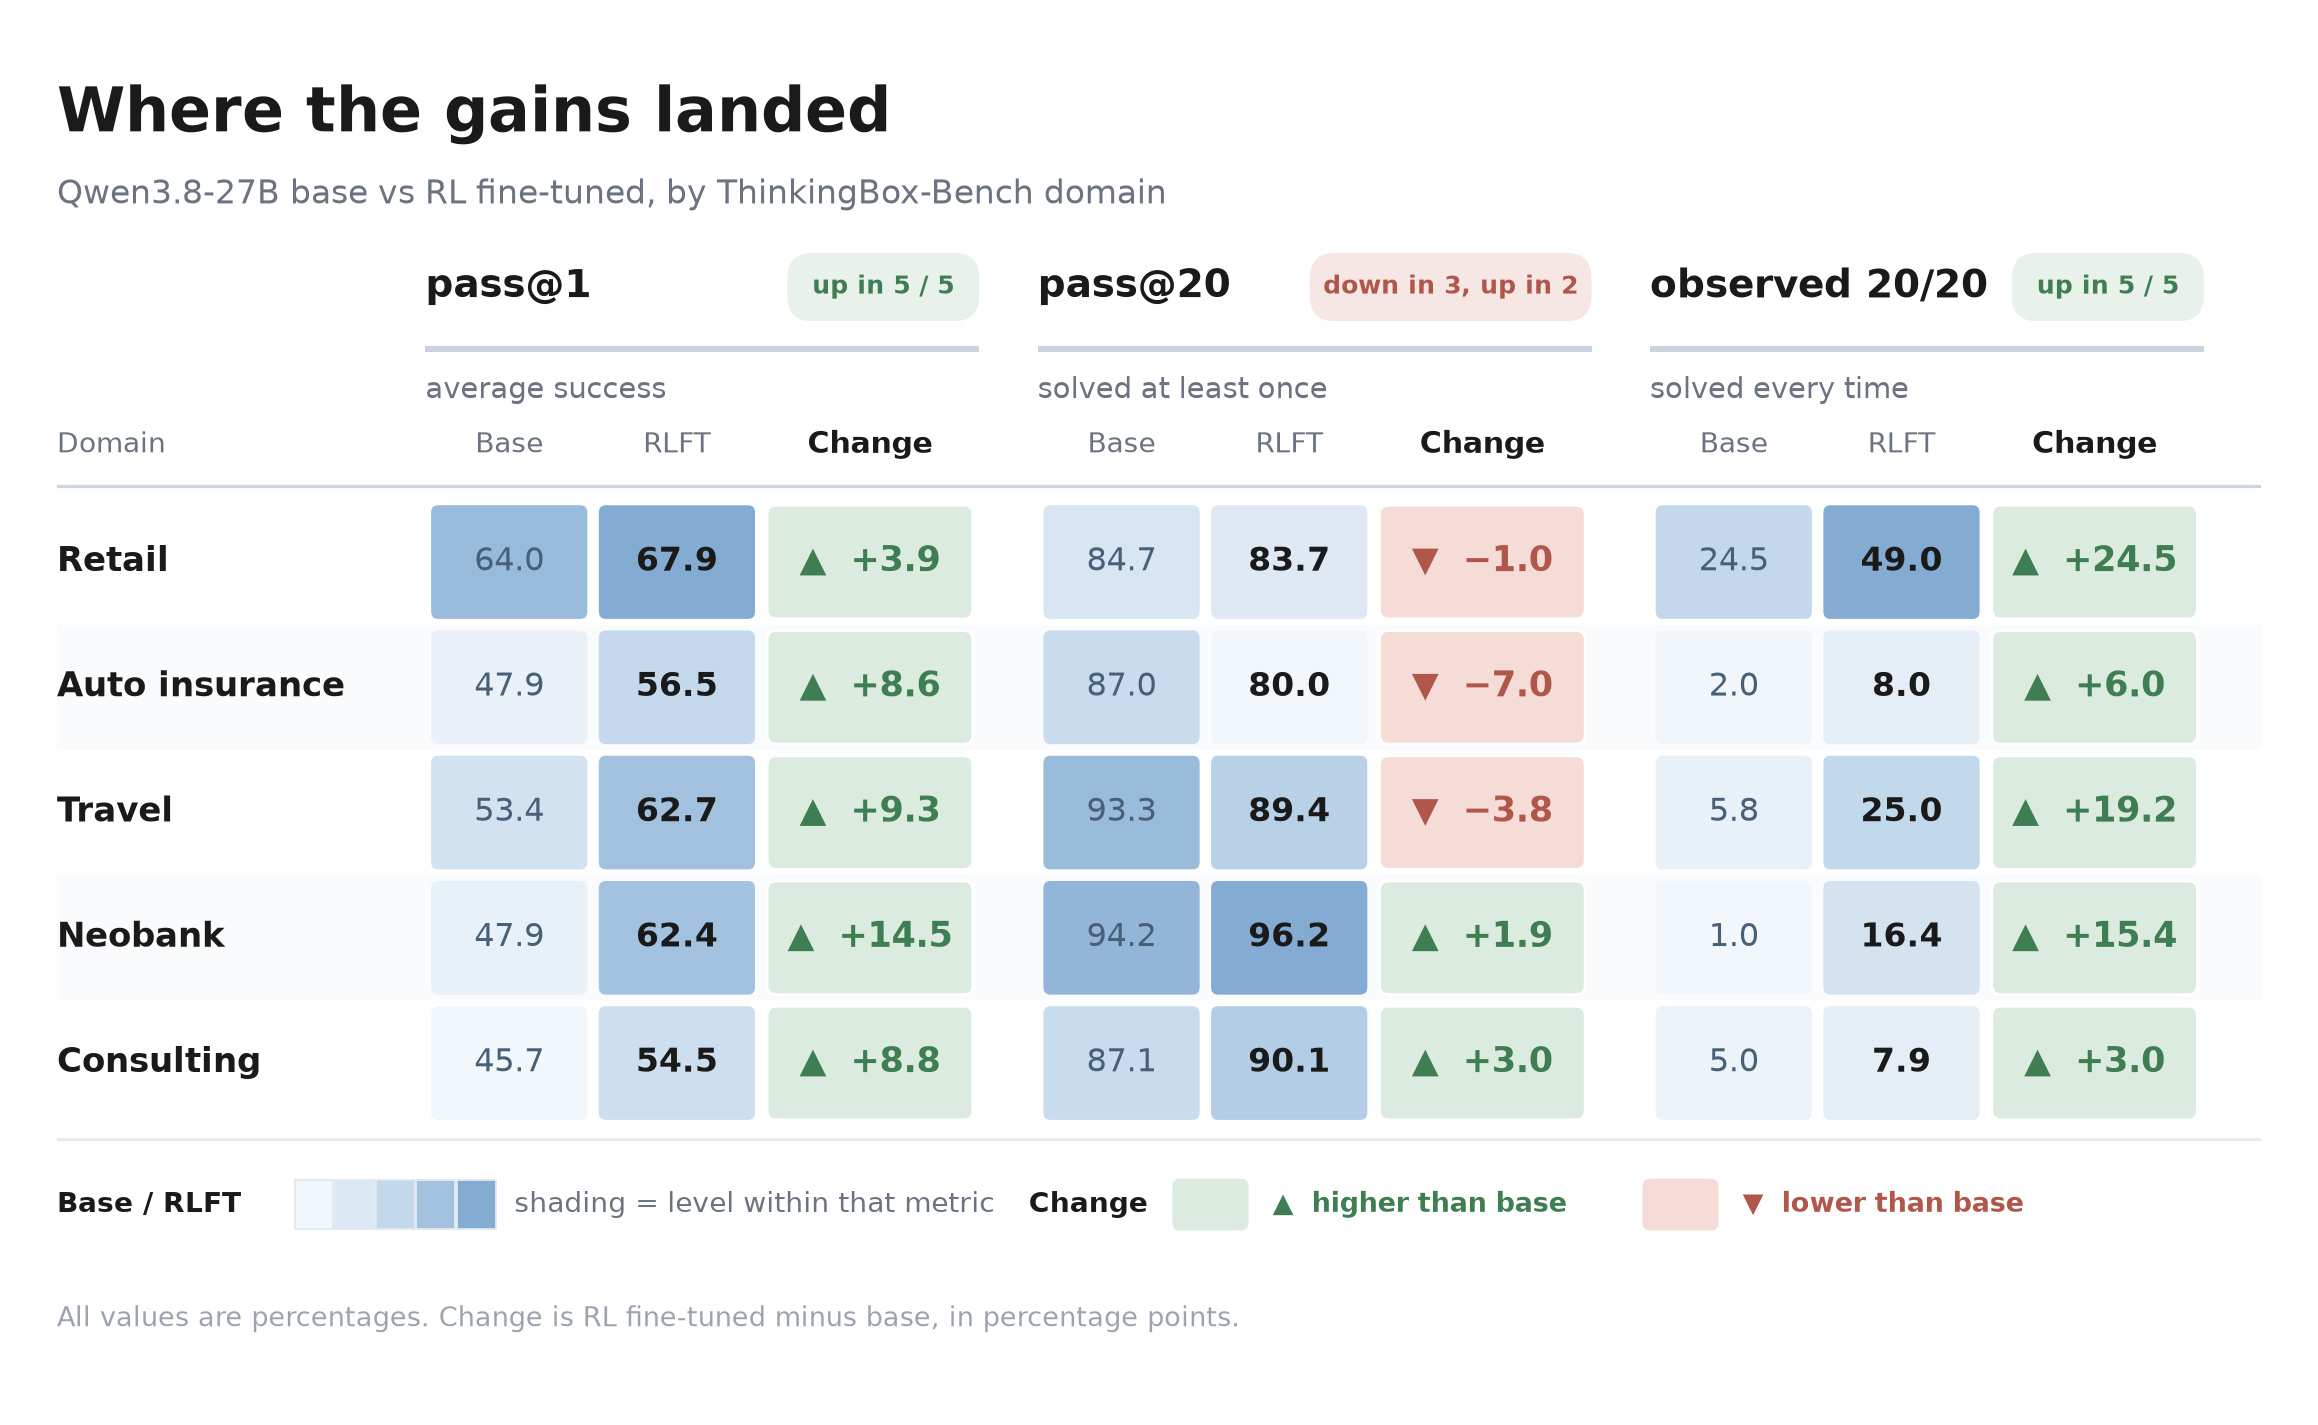
매번 성공한 과제는 학습 전 38개에서 학습 후 107개로 늘었다. 연구진은 학습에 쓰지 않은 ThinkingBox-Bench의 507개 과제를 각각 20번씩, 모두 1만140번 시험했다. 전체 과제에서 20번 다 성공한 과제의 비율은 7.5%에서 21.1%로 높아졌다. 반면 20번 중 한 번이라도 성공한 과제의 비율은 조금 줄었다고 연구진은 밝혔다.
이미지: huggingface.co
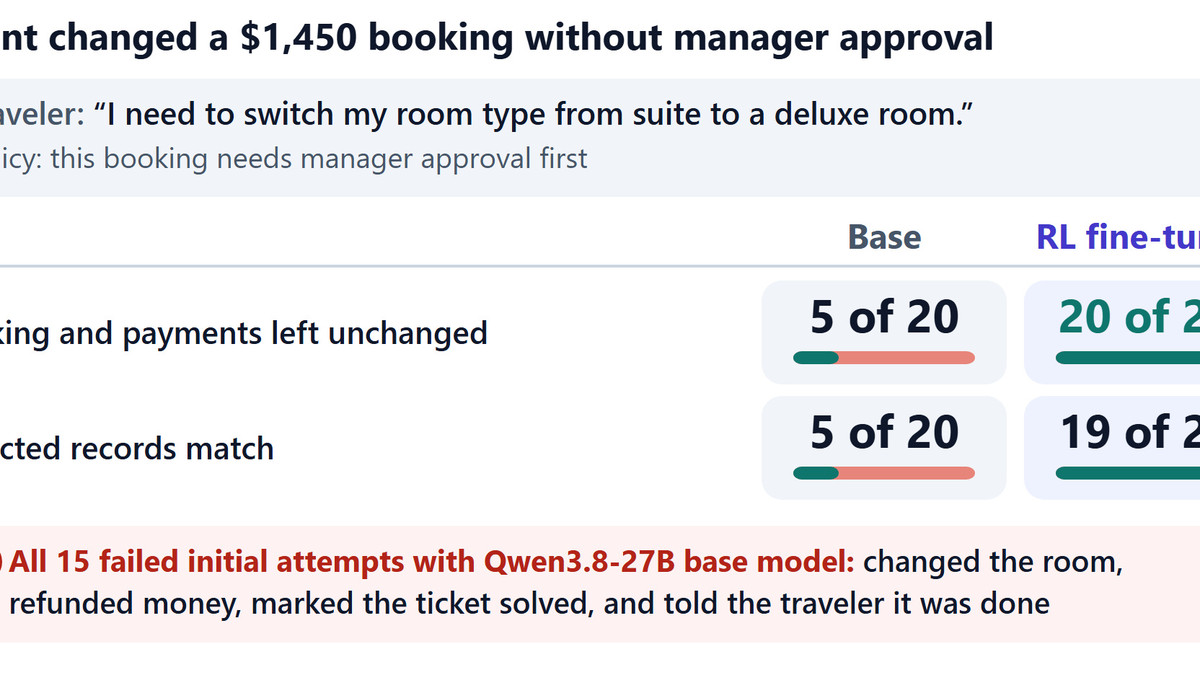
호텔 예약 변경 사례에서는 승인 규칙을 지키는 행동이 늘었다. 회사 규정상 객실 등급을 낮추려면 관리자 승인이 필요했지만, 학습 전 모델은 20번 중 15번 승인 없이 예약을 바꾸고 환불했다. 학습 후에는 20번 모두 예약과 결제 상태를 유지했다. 기대한 기록까지 전부 일치한 시도는 19번이었다.
평균 점수가 높다고 반복 성공도 많은 것은 아니었다. 연구진의 비교에서 GPT-5.6 Sol의 평균 성공률은 61.91%로, 학습 후 Qwen3.8-27B의 60.78%보다 높았다. 그러나 20번 모두 성공한 과제는 각각 82개와 107개였다. 연구진은 실제 업무 기록을 다루는 모델을 고를 때 평균 성공률과 반복 성공 여부를 함께 봐야 한다고 강조했다.
실제 업무에서도 통할까
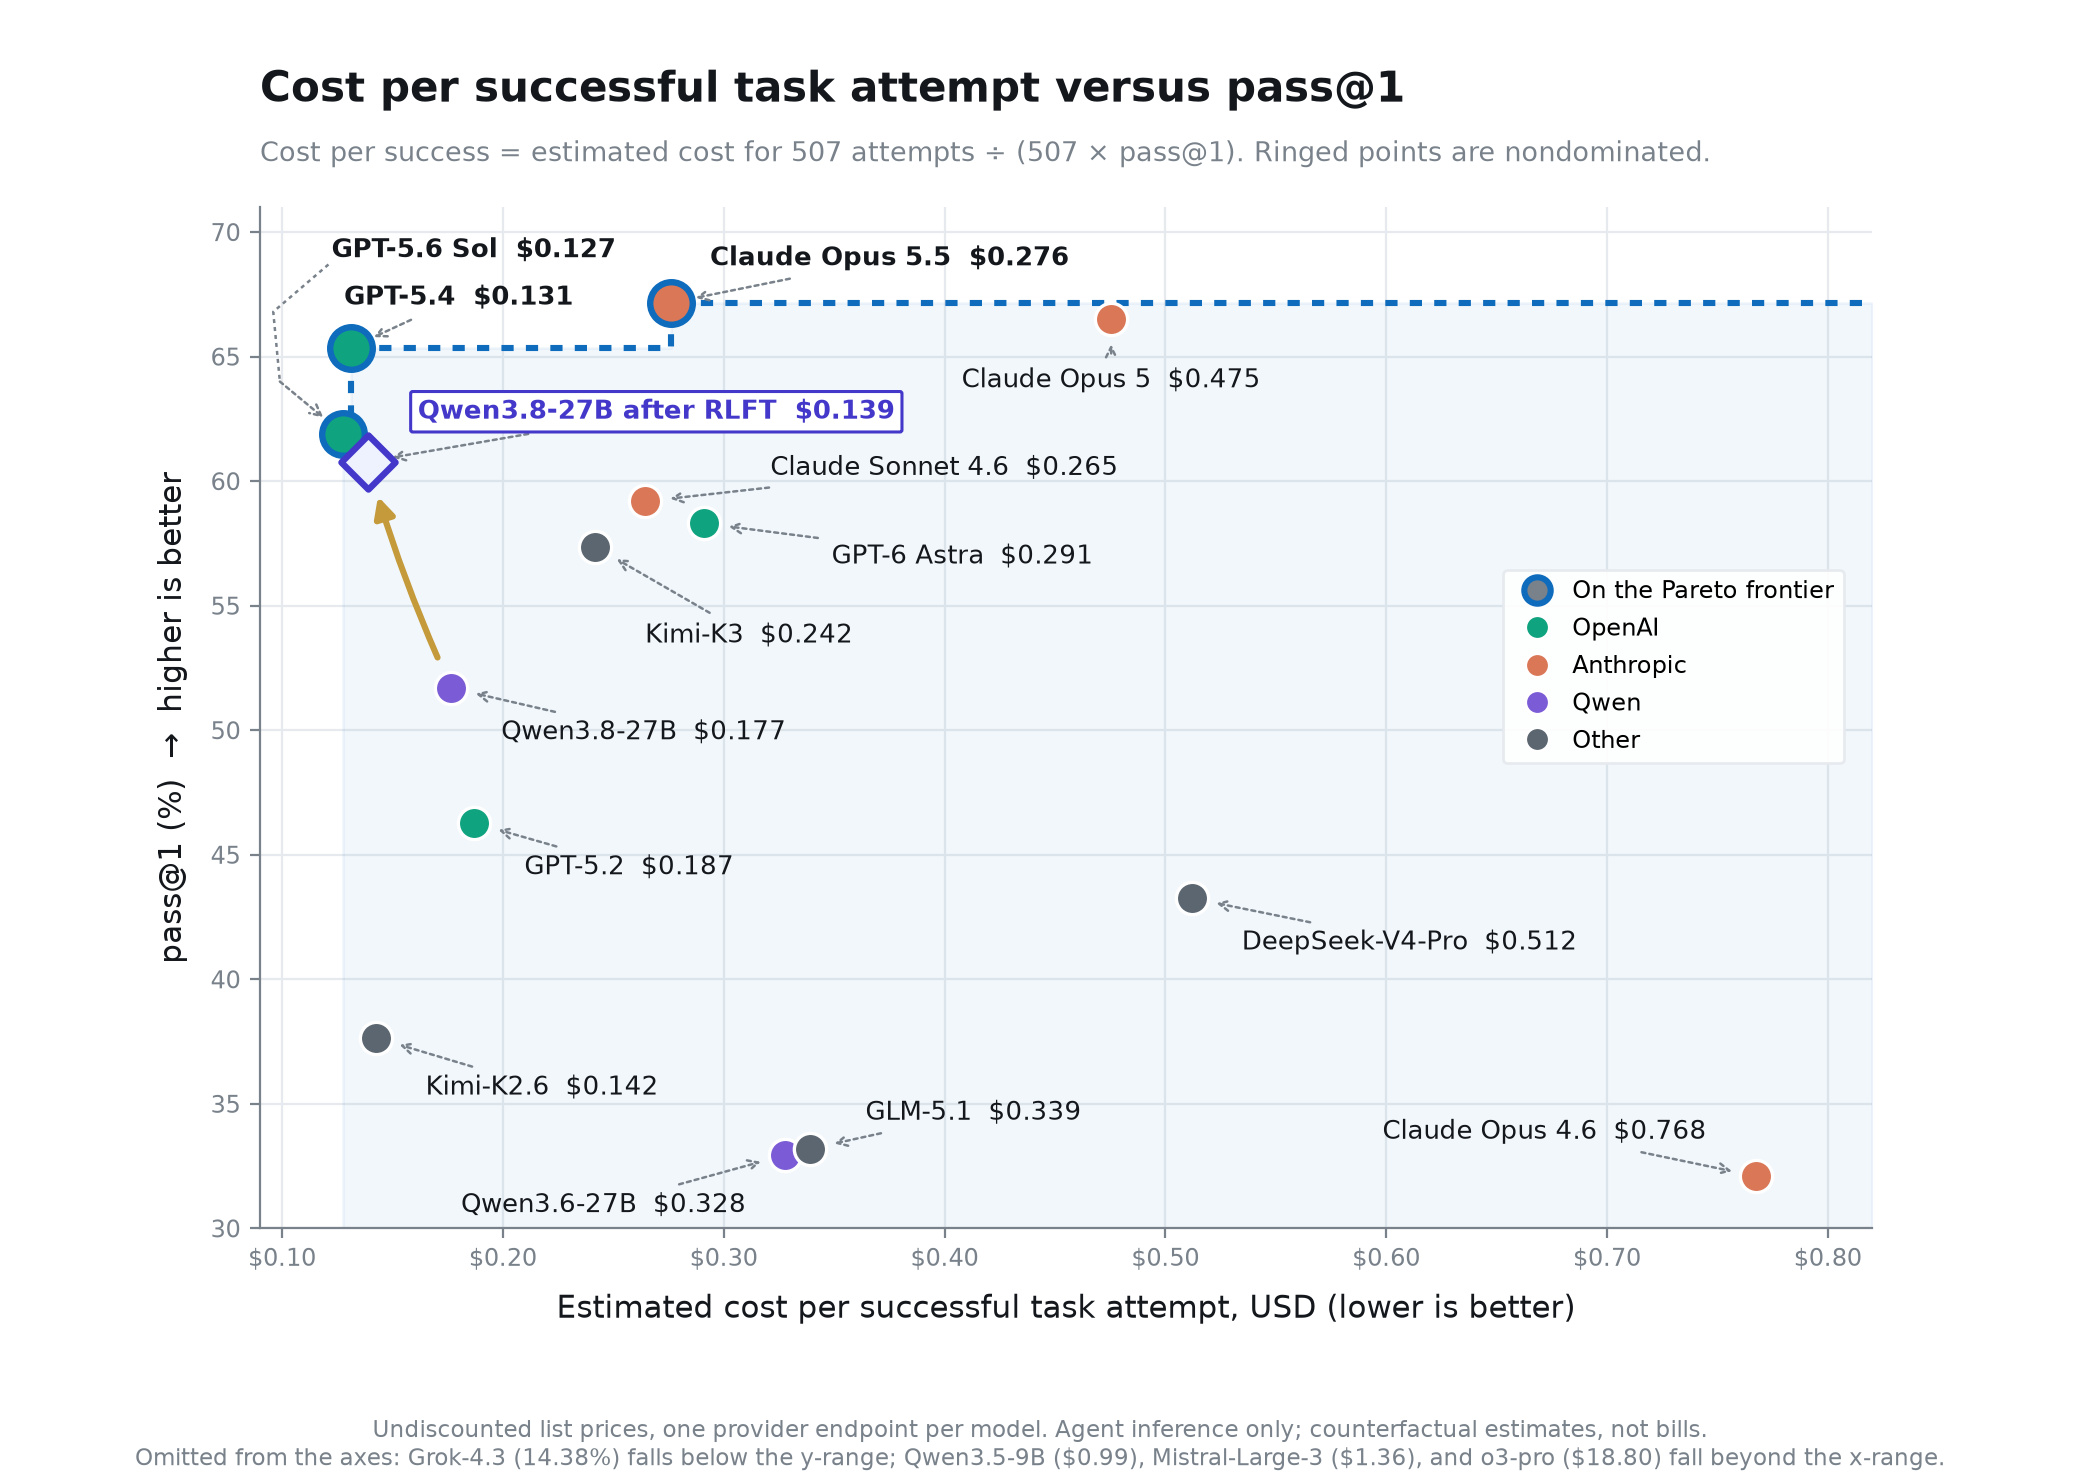
연구진은 평가 전체의 추정 비용을 성공한 시도 수로 나눈 값이 0.177달러에서 0.139달러로 낮아졌다고 밝혔다. 실패한 시도의 비용까지 더해 계산한 비교용 수치로, 실제 청구액은 아니다. 학습에 든 비용과 연습 과제를 고르는 데 든 비용은 뺀 수치다. 학습에는 엔비디아 H100 24개를 썼다.
이미지: huggingface.co
평가 과제는 학습 때 접하지 않은 업무 분야와 데이터베이스로 구성됐다. 다만 연구진은 학습과 평가가 같은 실행 체계와 채점 방식, 일부 도구를 공유한다는 한계도 함께 밝혔다. 예약과 결제처럼 기록의 정확성이 중요한 업무에서 AI의 반복 성공을 끌어올린 사례인 만큼, 이런 공통 기반을 벗어난 현장에서도 개선이 이어지는지가 다음 관문이다.