엔비디아 Kumo Relational, 업무별 학습 없이 고객 이탈 예측
여러 표로 나뉜 기업 데이터에서 고객 이탈과 수요를 바로 예측한다. 엔비디아는 15개 데이터베이스의 41개 과제에서 기존 예측 모델보다 높은 성능을 냈다고 밝혔다.
엔비디아가 10월 21일(현지시간) 기업 데이터베이스에서 바로 예측하는 AI 모델 Kumo Relational을 공개했다. 미리 학습해 둔 모델에 예측할 대상만 지정하면 고객 이탈, 수요, 사기 여부 등을 예측한다. 엔비디아는 업무마다 모델을 새로 학습시킬 필요가 없고, 사람이 예측에 쓸 항목을 일일이 만들 필요도 없다고 설명했다.
표를 합치는 작업이 왜 사라졌나
기업 데이터는 고객, 주문, 상품처럼 서로 연결된 여러 표에 나뉘어 있다. 지금까지 예측 작업에서는 이를 하나의 표로 합치고, ‘최근 30일 평균 주문액’ 같은 항목을 사람이 직접 만들어야 했다. 엔비디아는 이 과정에 상당한 노력이 들고, 데이터 사이의 세밀한 관계도 사라질 수 있다고 설명했다.
Kumo Relational은 표 사이의 연결과 시간 정보를 그대로 유지한 채 데이터를 다룬다. 실제 데이터베이스를 본뜬 가짜 데이터로 미리 학습했다. 새 업무에서는 결과를 이미 아는 과거 사례를 최대 1만 개까지 참고해 예측한다. 정확도를 더 높여야 할 때는 특정 데이터와 업무에 맞춘 추가 학습도 할 수 있다.
기존 예측 모델보다 나을까
엔비디아는 전자상거래, 의료, 기업 업무 등 15개 데이터베이스의 41개 과제에서 모델을 시험했다고 밝혔다. 시험에 쓴 데이터는 미리 학습할 때 쓰지 않았다. 대상을 분류하거나 수치를 예측하는 시험에서, 정답 데이터를 학습한 기존 모델과 전문가가 예측 항목을 설계한 모델보다 높은 성능을 냈다고 설명했다.
이미지: huggingface.co
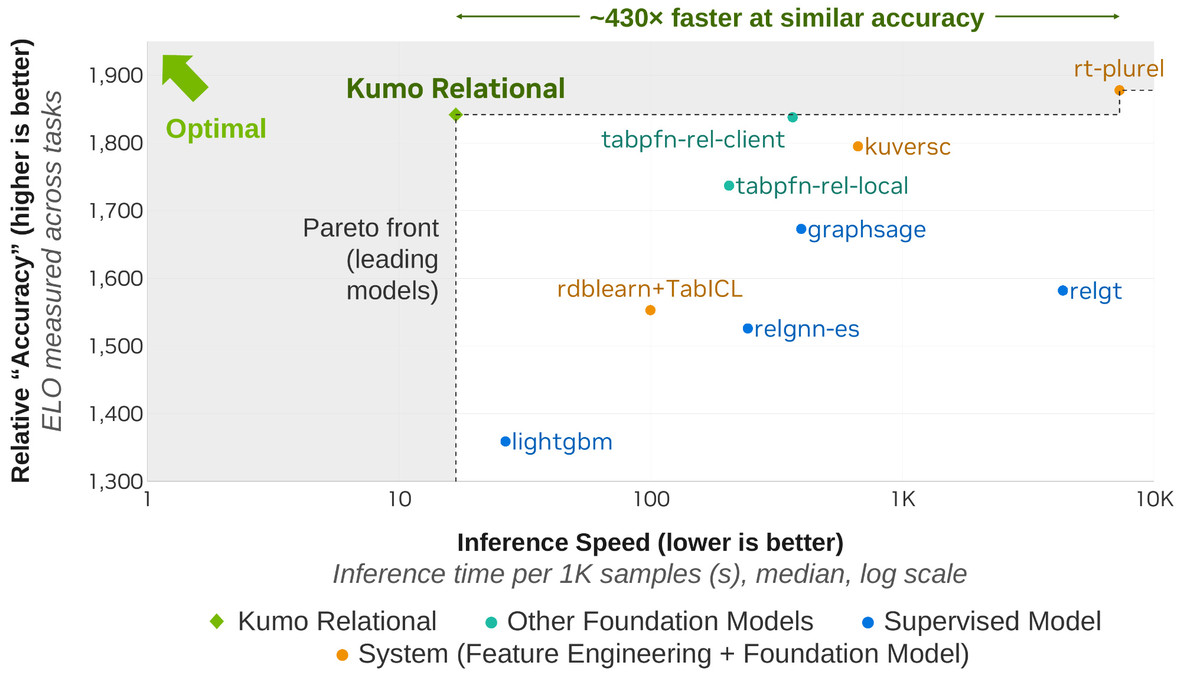
기업 데이터 시험인 SAP SALT에서는 정답을 얼마나 앞순위에 올리는지 보는 점수(MRR)로 비교했다. 엔비디아에 따르면 Kumo Relational의 점수는 여러 모델을 조합한 AutoGluon보다 8% 높았다. 추가 학습을 거친 뒤에는 격차가 16%로 벌어졌다. 다른 시험인 RelArena-α에서는 예측 대상 1000개를 처리하는 데 걸린 시간이 중앙값 기준 약 17초였다. 가장 높은 점수를 받은 모델은 약 7300초가 걸렸고, 정확도 점수는 Kumo Relational보다 높았다.
성능이 특히 잘 나오는 쪽은 시간에 따라 변하는 고객 행동처럼 관계와 변화가 중요한 데이터라고 회사는 설명했다. 학습 데이터가 매우 많은 과제에서는 그 업무에 맞춰 학습한 모델이 더 나을 수 있다고도 밝혔다. 예측에 필요한 정보가 표 사이에서 너무 멀리 떨어져 있으면 제약이 있어, 관련된 표 몇 개로 시작해 범위를 넓히라고 안내했다.
기업 업무에는 어떻게 쓰나
기업의 AI 담당자는 엔비디아가 공개한 오픈소스 소프트웨어에서 모델을 불러올 수 있다. NVIDIA NIM 형태로 별도 서비스를 구성하는 방법도 있다. 모델은 GPU 환경에서 실행하며, 처음 쓸 때 허깅페이스에서 내려받는다. 스스로 일을 처리하는 AI(에이전트)가 예측을 요청하도록 설계해, 고객별 향후 주문량 같은 질문을 업무 흐름에 붙일 수 있다는 설명이다.
이미지: huggingface.co
이번 공개는 새 예측 업무를 시작할 때 데이터 가공과 모델 학습 부담을 줄이는 데 초점을 맞췄다. 고객 이탈이나 수요를 예측하려는 팀은 업무마다 별도 모델을 만드는 과정을 줄일 수 있다. 남은 확인거리는 자사 데이터에서도 정확도와 처리 속도가 유지되는지, 필요한 GPU 자원과 운영 비용이 얼마나 되는지다.