IBM, Granite 예측 모델 4개 묶었다… 모델 고르는 부담 줄여
추가 학습 없이 미래 값과 예상 범위를 함께 내놓는다. 성능 시험에서 개별 모델보다 오차가 조금 낮았지만, 실행 시간과 메모리는 더 든다.
IBM이 10월 22일(현지시간) Granite 모델 4개를 하나로 묶은 ‘Granite Timeseries Ensemble’을 소개했다. 시간 순서로 쌓인 데이터를 보고 미래 값을 예측하는 도구다. 추가 학습 없이 예측값과 예상 범위를 함께 내놓는다. IBM은 데이터마다 어떤 모델을 골라야 할지 고민하는 부담을 줄이려는 것이 목적이라고 설명했다.
왜 모델 4개를 한꺼번에 쓰나
미리 학습해 둔 예측 모델도 데이터에 따라 성적이 달라진다. 매끄럽게 변하는 공장 설비 신호를 잘 다루는 모델이라고 해서 들쭉날쭉한 소매 수요까지 잘 맞히지는 않는다. 이번 도구는 추세와 계절 변화를 서로 다른 방식으로 읽는 모델 4개의 예측을 한데 모은다. 사용자가 처음부터 자기 데이터에 맞는 모델 하나를 골라야 하는 일을 덜어주는 방식이다.
기본 설정인 ‘Probabilistic Ensemble’은 모델 4개의 예측에 같은 비중을 준다. 새 데이터에 맞춰 모델별 비중을 따로 학습할 필요가 없다. 다른 선택지인 ‘IQR Ensemble’은 예상 범위를 좁게 내놓는 모델에 더 큰 비중을 둔다. IBM은 범위가 좁다고 해서 정확한 것은 아니며, 이 방식이 지나치게 확신하는 모델을 우대할 수 있다고 설명했다.
정확도는 얼마나 좋아졌을까
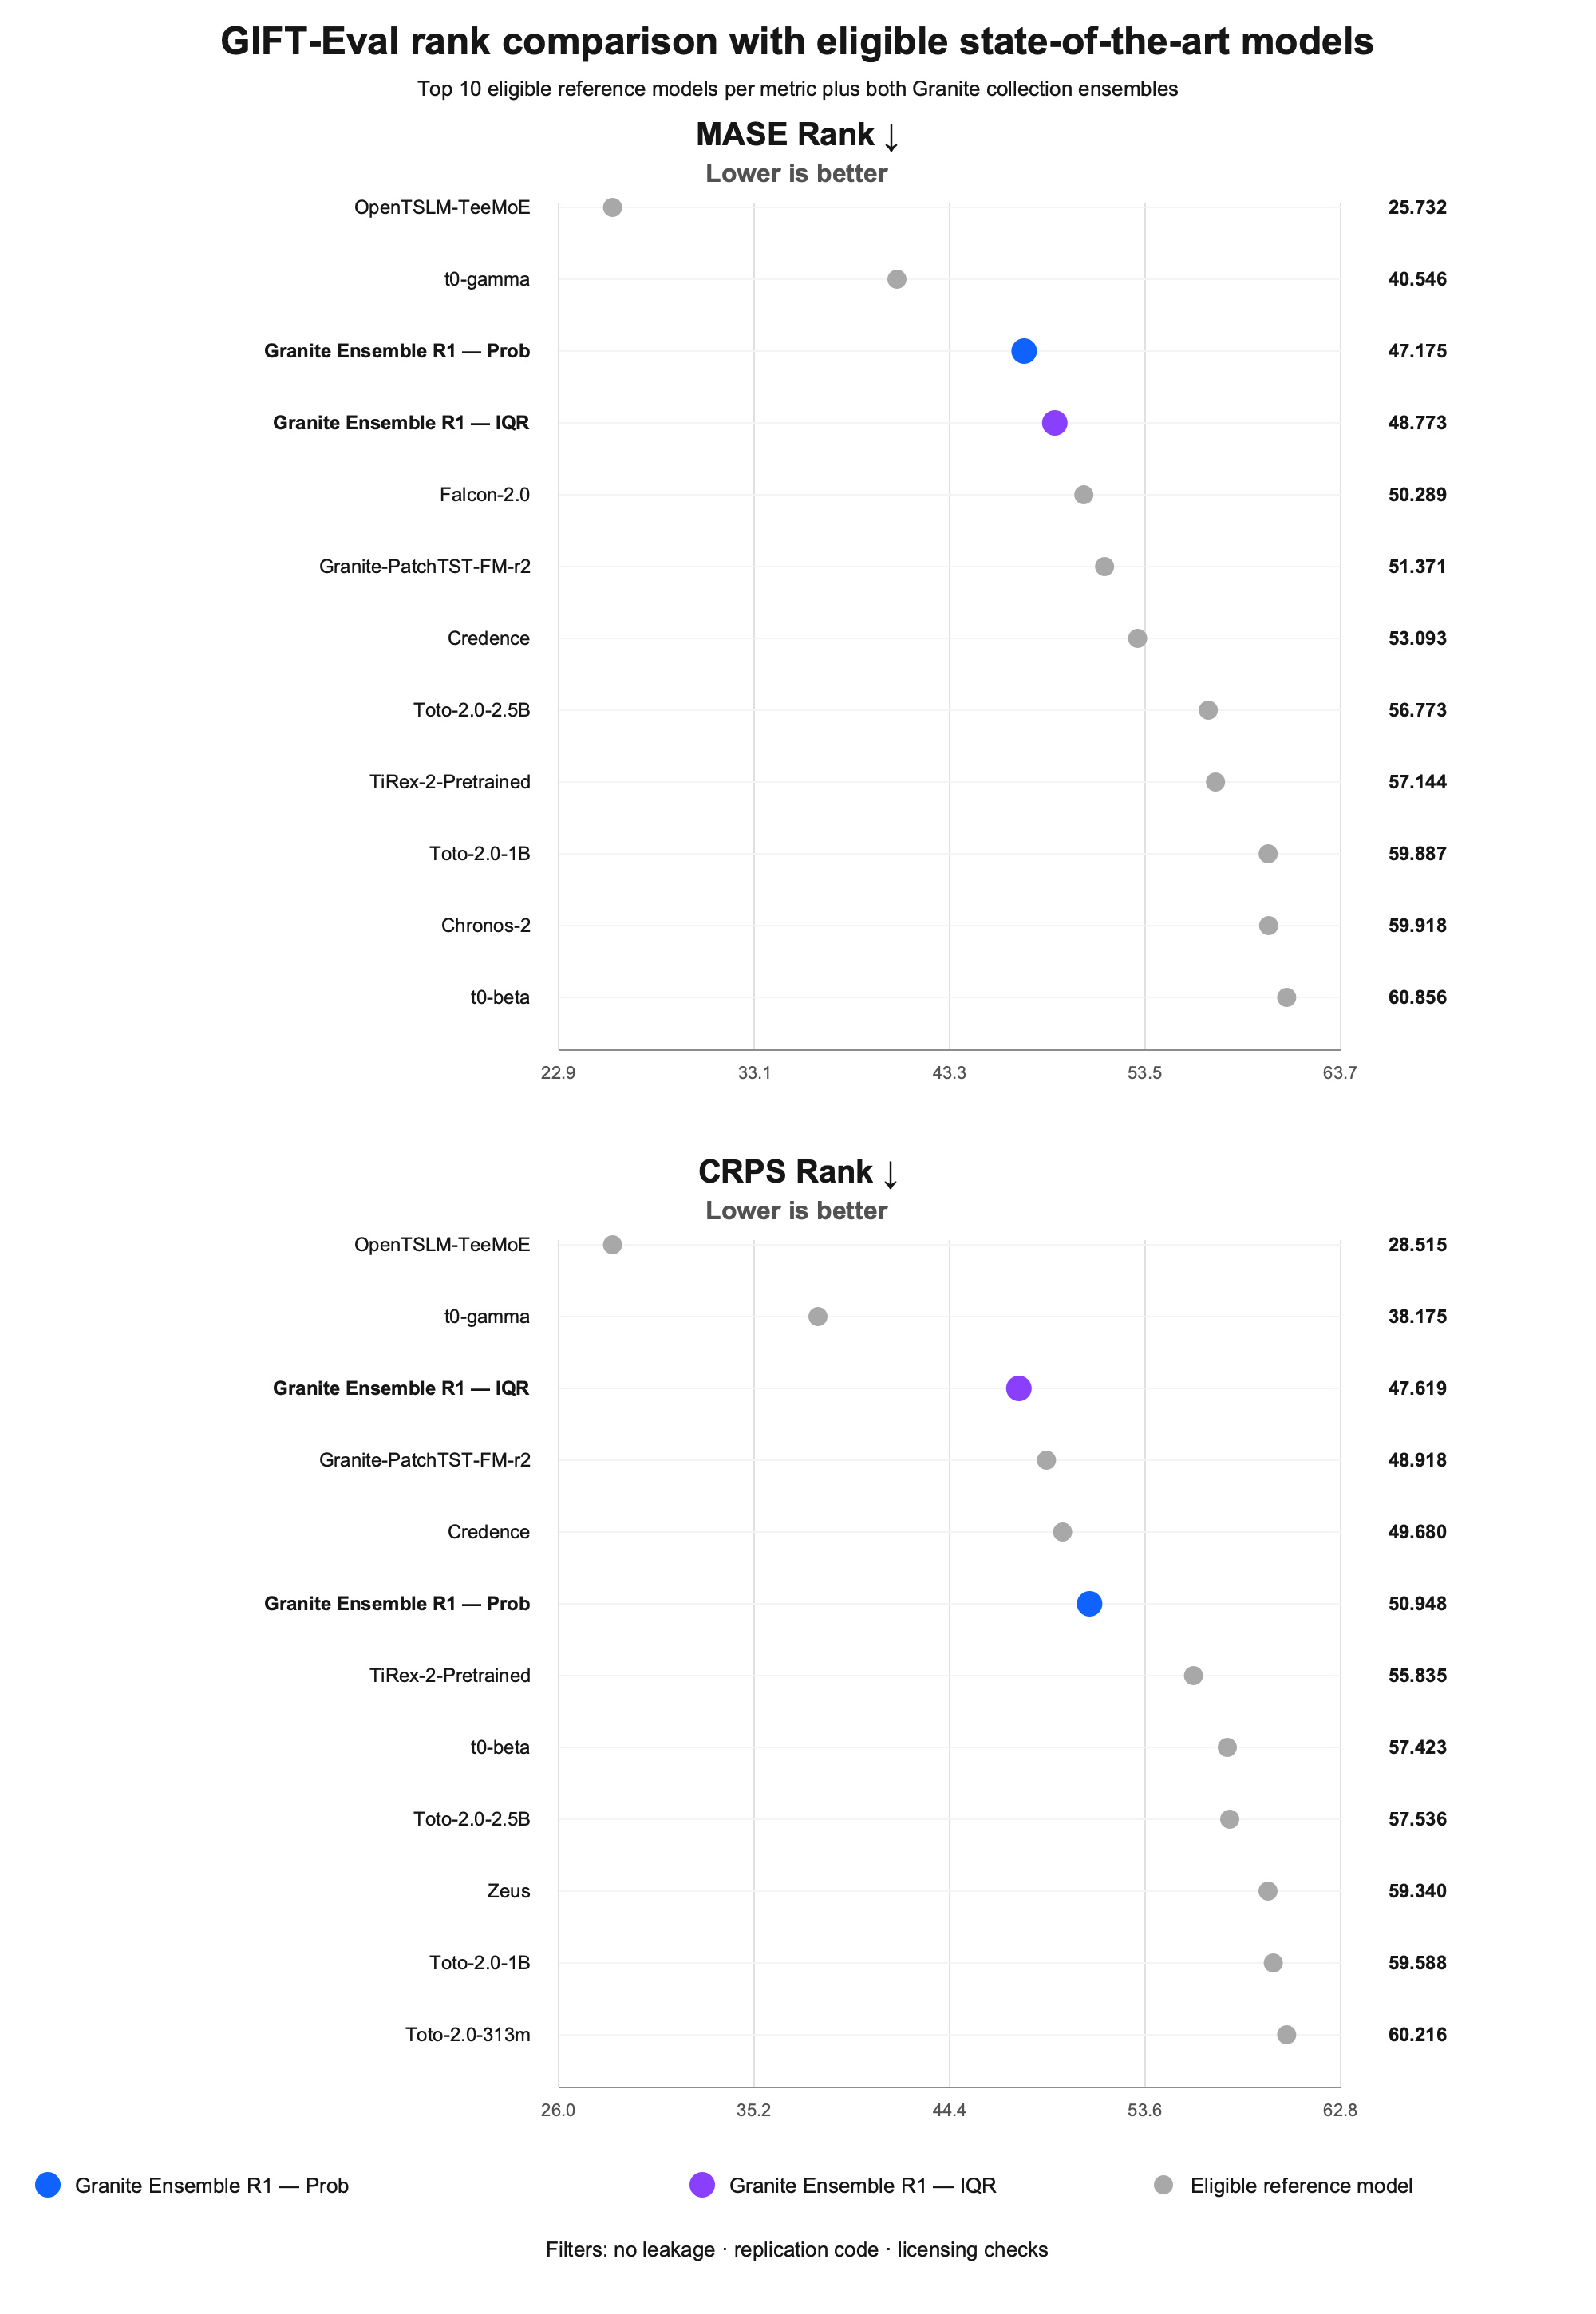
IBM은 GIFT-Eval 성능 시험의 데이터 구성 97개로 두 방식을 평가했다. 추가 학습은 하지 않았고, 시험의 정답 데이터를 결합 방식 선택이나 학습에 쓰지 않았다고 밝혔다. 10월 20일 기준 결과에서 두 결합 방식 모두 개별 모델 4개보다 예측값의 종합 오차와 평균 순위가 좋았다. 기본 방식의 오차는 MASE 기준 0.683이었다. 개별 모델 가운데 가장 좋았던 PatchTST-FM-r2의 0.685보다 조금 낮다. 이 숫자는 낮을수록 정확하다.
이미지: huggingface.co
예상 범위까지 함께 따지면 순위가 바뀐다. 범위를 포함한 종합 오차는 PatchTST-FM-r2가 가장 낮았다. 반면 데이터 구성별 순위를 평균 낸 값에서는 IQR Ensemble이 비교 대상 6개 중 가장 좋았다. IBM은 개별 모델 대비 예측값 오차가 줄어든 폭이 작다고 설명했다. 대신 어떤 모델이 잘 맞을지 미리 몰라도 여러 데이터에서 비슷하거나 더 나은 정확도를 얻는 데 의미를 뒀다.
그래서 업무에 써도 될까
이 도구는 예측값 하나만 보는 대신 틀릴 가능성의 폭까지 함께 살피는 데 쓸 수 있다. 기본 출력에는 예상 분포의 10% 지점부터 90% 지점까지에 해당하는 값이 담긴다. 10%와 90% 사이가 가운데 80% 구간이다. IBM은 실제 결과가 이 범위 안에 들어오는 비율을 과거 데이터로 점검해 보라고 권했다.
이미지: huggingface.co
기본 구성은 허깅페이스에서 내려받아 실행할 수 있다. 처음 실행할 때 모델 4개를 각각 내려받고, 답을 만드는 시간과 메모리도 모델 하나를 쓸 때보다 더 든다. 현재는 데이터 항목을 각각 따로 예측하며, 항목 사이의 관계는 쓰지 않는다. 기본 구성과 여기 포함된 모델에는 쓰임새 제한이 적은 라이선스가 적용된다. 따로 마련된 확장 구성에는 비상업적 이용이나 연구 용도로만 쓸 수 있는 모델도 들어 있다.
호환되는 외부 모델을 더하거나 결합 방식을 바꿔도 결과 형식은 그대로 유지된다. 도입을 검토한다면 자기 회사의 과거 데이터로 정확도와 예상 범위가 얼마나 믿을 만한지 비교해 보는 일이 먼저다. 모델 4개를 함께 돌리는 데 드는 시간과 메모리가 그만한 정확도 향상에 값하는지도 따져볼 대목이다.