작업 도중 AI의 선택을 시험했더니, 최고 점수 59.7%
Taste-Bench는 개발과 연구 도중 AI가 더 나은 방향을 고르는지 잰다. 선택의 결과가 한참 뒤에 드러나는 문항에서는 점수가 크게 떨어졌다.
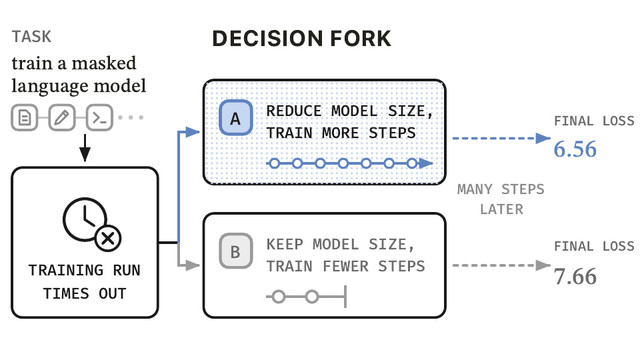
홍콩시립대와 마이크로소프트 소속 연구진, 독립 연구자가 지난 9월 논문에서 새 성능 시험 Taste-Bench를 공개했다. 스스로 일을 처리하는 AI(에이전트)가 긴 작업 도중 더 나은 방향을 고르는지 재는 시험이다. 평가한 14개 모델 가운데 GPT-5.6 Sol이 59.7%로 가장 높은 점수를 받았다. 연구진은 논문과 함께 평가 코드, 데이터셋도 공개했다.
작업을 끝냈는지 말고, 도중에 뭘 골랐나
Taste-Bench는 작업을 마쳤는지보다 도중에 어떤 선택을 했는지를 본다. 널리 쓰이는 SWE-bench 계열 시험이 과제의 최종 완료 여부를 따졌다면, 이번 시험은 진행 과정의 갈림길을 따로 살핀다. 문항은 AI가 소프트웨어 개발과 기계학습 연구를 실제로 수행한 기록에서 뽑았다.
평가받는 모델은 선택 시점까지의 작업 기록과 두 갈래 선택지를 받는다. 그리고 나중에 나온 작업 결과를 기준으로 정해 둔 더 나은 선택을 골라야 한다. 연구진은 서로 다른 두 시도가 방향이 갈린 사례, 한 시도에서 잘못된 길로 갔다가 되돌린 사례를 썼다. 후보 4,657건을 걸러 개발 390문항과 연구 112문항, 모두 502문항을 만들었다.
59.7%는 어떻게 매긴 점수인가
두 선택지 중 한 번 맞혔다고 정답으로 쳐주지 않는다. 같은 문항에서 선택지 순서를 바꿔 다시 물었을 때도 맞혀야 한다. 그래서 아무렇게나 찍었을 때 나오는 기준 점수는 50%가 아니라 25%다. 이 방식으로 GPT-5.6 Sol이 59.7%, GPT-5.5가 59.5%를 기록했다.
정답의 단서가 언제 드러나는지에 따라 점수 차이가 컸다. 선택 이전 기록에 이미 단서가 있는 문항에서는 14개 모델의 평균이 62.3%였다. 반면 뒤이어 상당한 작업을 더 해야 결과가 드러나는 문항에서는 평균이 21.0%로 떨어졌다. 당장 보이는 기록만으로는 판단하기 어려운 선택에서 모델들이 특히 약했다.
선택을 돕는 AI는 효과가 있었나
연구진은 선택 능력을 추가 학습으로 끌어올리는 실험도 했다. 따로 학습시킨 Qwen3.6-27B는 학습 때 보지 못한 문항에서 점수가 30.0%에서 47.9%로 올랐다. 이 모델이 내놓은 조언을 실제로 일을 수행하는 AI에게 전달하는 실험도 이어 갔다. SWE-bench Pro의 41개 과제에서 성공률은 14.6%에서 33.7%로 높아졌다.
직접 시험해 보려는 개발자는 공개된 코드와 데이터셋을 쓸 수 있다. 코드에는 MIT 라이선스가, 데이터셋 본문에는 CC BY 4.0이 적용됐다. 데이터 파일을 받으려면 허깅페이스에 로그인하고 재게시 제한 조건에 동의해야 한다. 데이터셋에 표시된 언어는 영어다.
평가를 한 번 돌리는 데 드는 모델 사용량도 적지 않다. 저장소 안내를 보면 전체 평가에는 모델에 1,004회 요청이 들어간다. 입력 분량은 약 800만 토큰(글자 조각 단위)이다.
개발이나 연구를 AI에 맡기는 이용자에게 이번 시험은 작업 도중의 판단력을 들여다볼 잣대가 된다. 일을 끝냈는지만이 아니라 어느 갈림길에서 선택이 어긋났는지도 볼 수 있어서다. 남은 숙제는 조언을 받은 AI의 성공률 개선이 더 많은 과제에서도 이어지는지, 한국어 작업에서도 같은 효과가 나타나는지다.