엔비디아, 인도 22개 언어 AI 학습 데이터 공개… 만드는 절차도 함께
약 2조8000억 글자 조각 단위의 학습 데이터와 만드는 절차를 함께 내놓는다. 영어 기술 자료를 인도 언어로 옮겨, 그 언어로 설명하고 문제를 푸는 AI 개발을 돕겠다는 목표다.
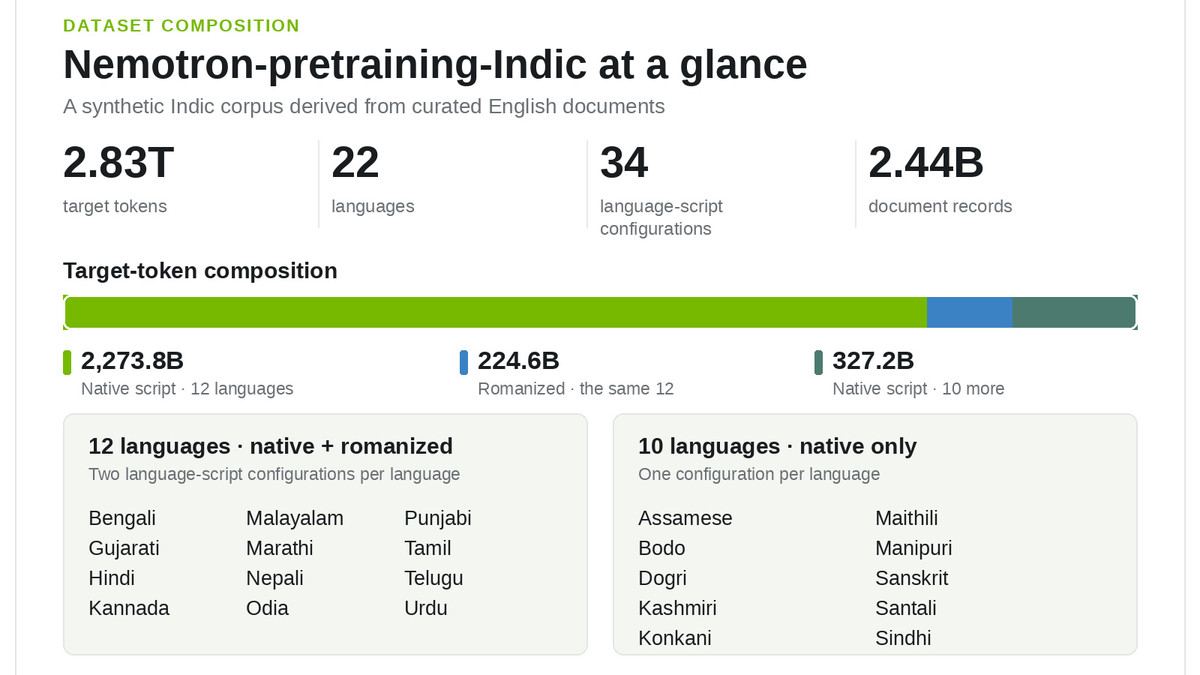
엔비디아가 인도 22개 언어로 된 AI 학습 데이터 ‘Nemotron-pretraining-Indic-v1’을 공개하겠다고 밝혔다. IIT 마드라스와 산하 연구실 AI4Bharat가 함께 만들었다. 분량은 약 2조8000억 글자 조각 단위다. 데이터를 만드는 데 쓴 도구와 작업 절차도 같이 공개한다.
어떤 자료를 담았나
영어로 된 수학, 코드, 질문과 답변 자료를 인도 언어로 옮긴 것이 핵심이다. 엔비디아는 기술 개념을 설명하고 문제를 풀며 질문에 답하는 모델을 만들 수 있도록 학습 자료를 늘렸다고 밝혔다. 대상은 인도 헌법에 명시된 22개 언어다. 2011년 인구조사 기준으로 인도인의 97%, 약 12억 명이 이 언어들을 모어로 쓴다.
22개 언어는 모두 고유 문자로 적은 자료를 담았다. 힌디어와 타밀어 등 12개 언어에는 로마자로 적은 자료를 더했다. 인도 언어의 발음을 라틴 문자로 옮겨 적은 자료다. 같은 원문에서 여러 언어와 문자 형태가 만들어지는 만큼, 전체 분량에는 내용이 겹치는 기록도 들어 있다.
번역 품질은 어떻게 걸렀나
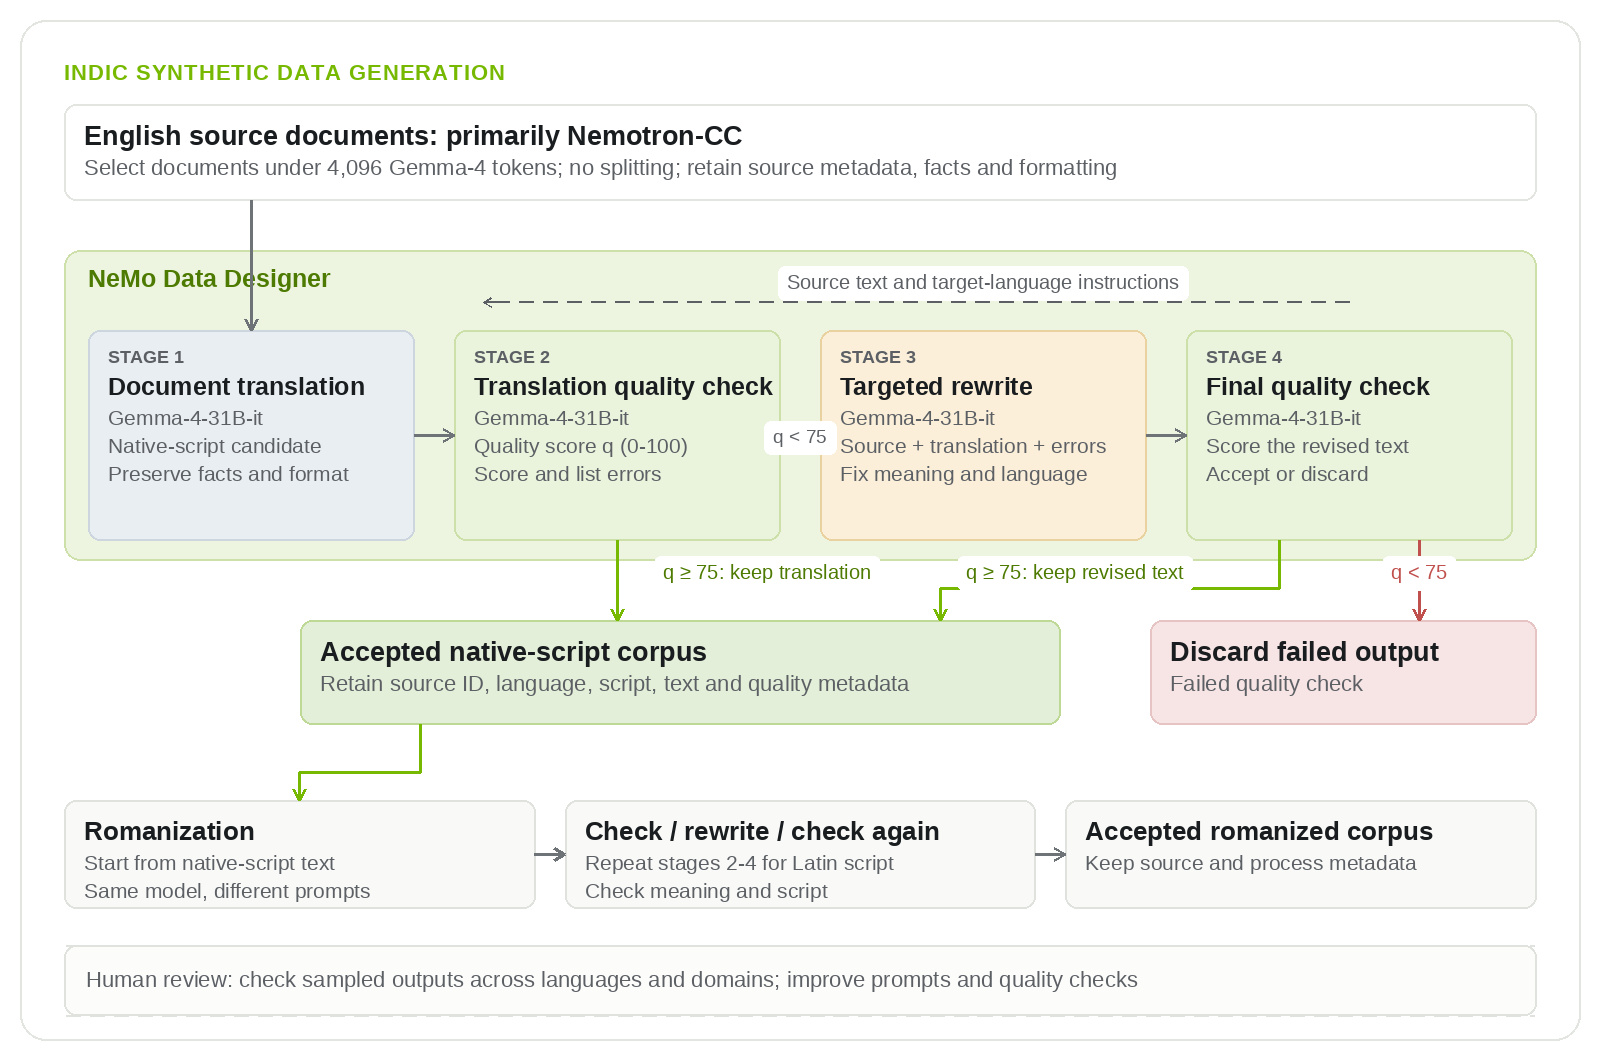
개발팀은 문서를 통째로 번역하면서 코드, 수식, 표는 원래 모습대로 남기도록 작업을 설계했다. 12개 언어는 Gemma-4-31B-it으로 번역하고 품질 평가까지 맡겼다. 100점 만점에 75점 이상인 결과만 남겼고, 기준에 못 미치면 오류를 고친 뒤 다시 평가했다.
이미지: huggingface.co
나머지 10개 언어에는 Bodhan AI의 문서 번역 모델 Indic Translate를 적용했다. 산탈리어처럼 문서가 긴 경우에는 나눠 번역한 뒤 합치는 식으로, 언어별 사정에 맞춰 절차를 달리했다. 결과마다 원문 출처를 추적할 수 있는 식별 번호를 남겼다. 개발자는 공개될 절차에 자기 원문을 넣거나 품질 검사 기준을 바꿔 쓸 수 있다.
모델 성능도 좋아졌나
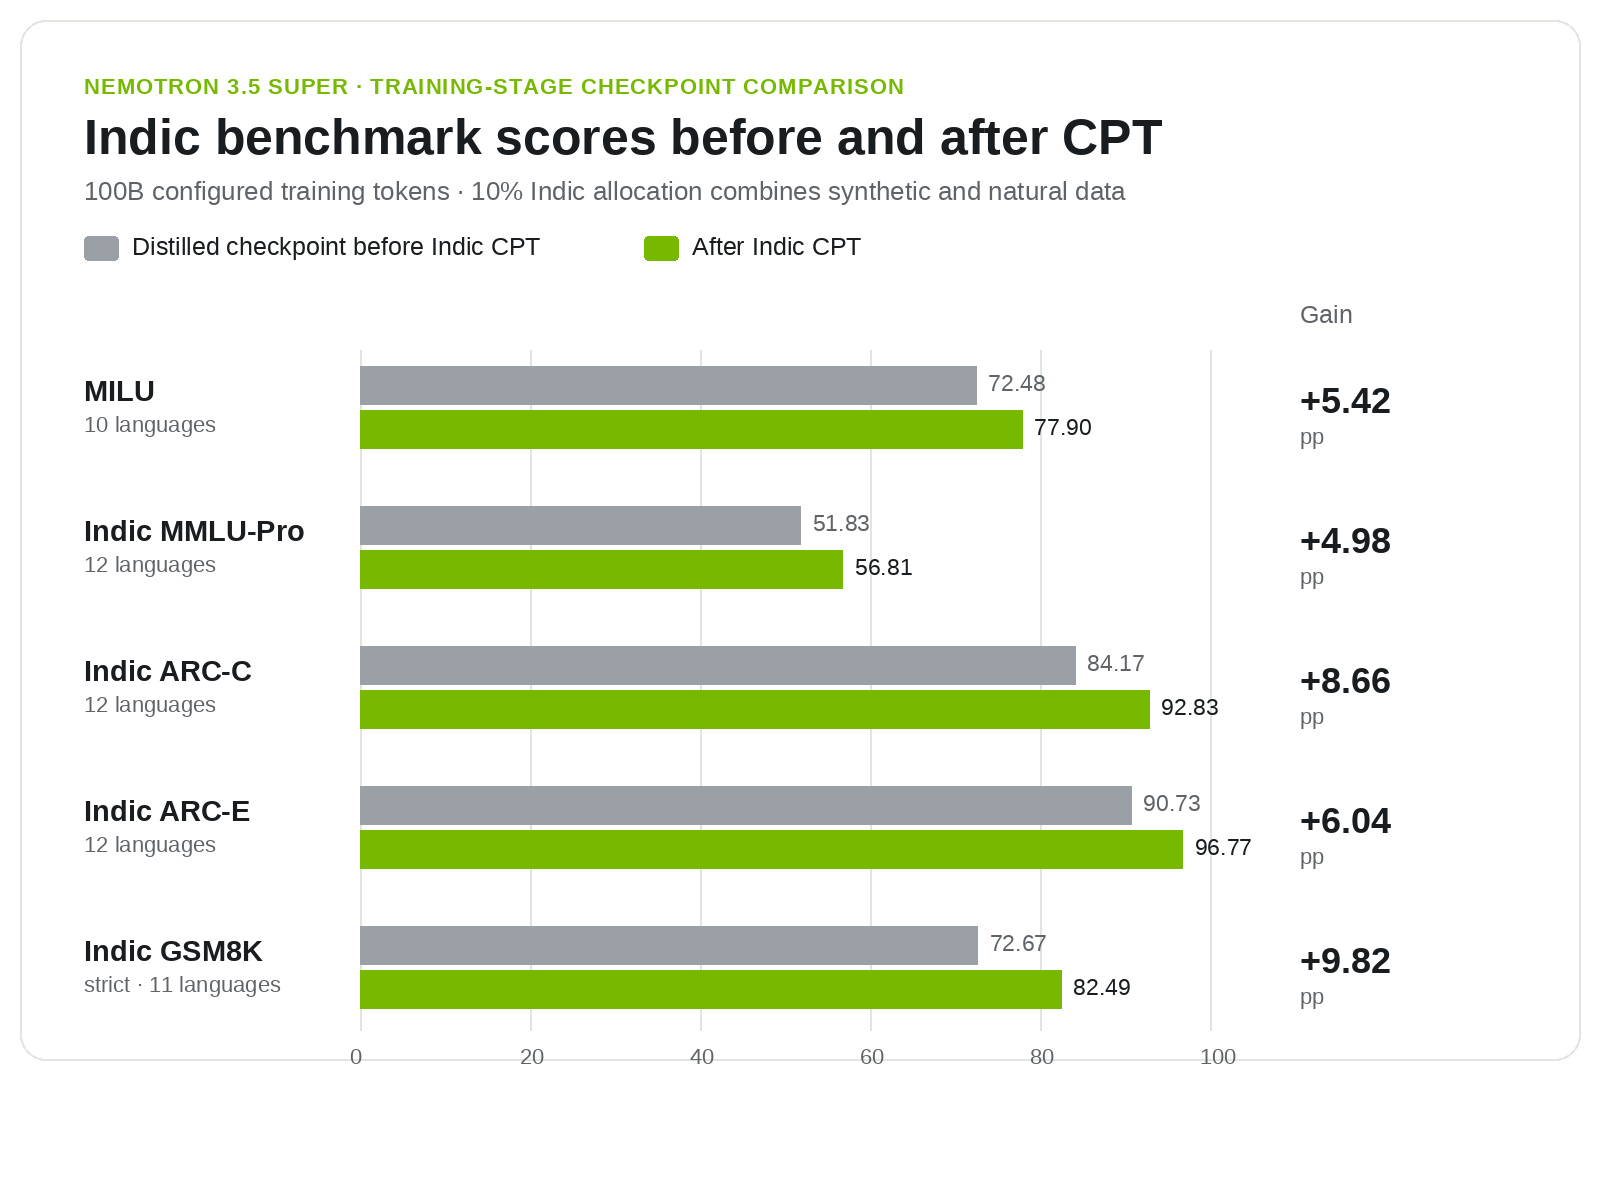
Nemotron 3.5 Super VL을 추가 학습할 때 이 데이터의 12개 언어 자료와 사람이 직접 쓴 인도 언어 자료를 함께 썼다. 추가 학습 분량 1000억 글자 조각 단위 가운데 10%인 100억 단위다. 엔비디아는 이 단계를 거치기 전과 후를 비교하면 지식과 추론을 본 성능 시험 다섯 개에서 모두 점수가 올랐다고 밝혔다. 상승폭은 4.98~9.82%포인트다.
이미지: huggingface.co
이전 세대 Nemotron 3 Super와 비교하면 과제 성능 시험 여섯 개 중 다섯 개에서 점수가 올랐다. 지시를 따르는 능력을 보는 IFEval 1.5에서는 2.04점 낮아졌다.
이번 데이터를 당장 쓸 곳은 인도 언어 AI를 만드는 개발팀이다. 공개되면 허깅페이스에서 전체를 내려받지 않고 일부 기록만 먼저 살펴볼 수 있다. 엔비디아는 사람이 쓴 현지 언어 자료가 지역 지식과 문화적 맥락을 담는 데 여전히 필수라고 강조했다. 기계로 만든 자료를 얼마나 섞어야 효과적인지, 수정된 번역과 나머지 10개 언어까지 더한 전체 데이터가 어떤 성능을 내는지는 아직 남은 숙제다.