표 읽고 계산하기, 가벼운 GPT-6 Luna도 3문제 다 맞혔다
GPT-6 Luna는 표 비교와 합계, 증가율 계산을 모두 맞혀 상위 모델과 같은 정답 수를 기록했다. 준비 시간을 뺀 평균 응답 시간은 0.1초였다.
표 계산, 가벼운 모델로도 될까
숫자가 담긴 표를 주면 AI는 제대로 읽고 계산할까. 10월 15일 진행한 비교에서는 매출표로 만든 세 문제를 가벼운 모델 GPT-6 Luna와 상위 모델 세 개가 모두 맞혔다. 매출이 줄어든 지점을 찾거나 증가율을 계산하는 일이라면 가벼운 모델로도 충분한지가 이번 질문이다.
이렇게 시험했다
앤트로픽의 상위 모델 Claude Opus 5.5와 가벼운 모델 Claude Haiku 4.5, 오픈AI의 상위 모델 GPT-6 Astra와 가벼운 모델 GPT-6 Luna를 비교했다. 구글의 가벼운 모델 Gemini 3.5 Flash와 xAI의 상위 모델 Grok 4.5도 넣었다. 이 두 모델은 GitHub Copilot으로 실행했다.
시험일은 2026년 10월 15일이다. 모든 모델에 같은 지시문(프롬프트)을 넣고 기본 설정으로 문제마다 한 번씩 실행했다. 채점은 Claude Opus 5와 GPT-6 Sol이 맡았다. 두 심사위원은 어느 모델의 답인지 모르는 상태에서 각각 1~10점을 줬다. 둘 다 맞았다고 보면 정답으로 인정하고, 의견이 갈리면 ‘판정 갈림’으로 처리했다.
응답 시간은 각 모델이 OK 한마디를 답하는 데 걸린 준비 시간을 먼저 재고, 문제별 소요 시간에서 그 값을 뺀 것이다. 출력 속도는 답변 글자 수를 이 시간으로 나눈 값이다. 모델마다 실행 경로가 달라 속도를 그대로 맞대어 보기는 어렵다.
문제 1: 매출이 줄어든 지점
여러 칸의 숫자를 비교해 조건에 맞는 지점을 고르는지 보는 문제다.
지점별 월 매출(단위: 만 원)
| 지점 | 7월 | 8월 | 9월 |
|---|---|---|---|
| 강남 | 1250 | 1410 | 1380 |
| 홍대 | 980 | 1020 | 1150 |
| 판교 | 1100 | 1050 | 990 |

9월 매출이 7월보다 줄어든 지점은 어디인가? 지점 이름만 답해.
답변을 낸 다섯 모델은 모두 “판교"라고 답했다. 판교 매출은 7월 1100만 원에서 9월 990만 원으로 줄었다. 강남은 8월보다 9월 매출이 적지만, 비교 기준인 7월보다는 많다. 다섯 모델 모두 비교할 달을 정확히 골랐고, 지점 이름만 쓰라는 조건도 지켜 10점을 받았다.
Gemini 3.5 Flash는 실행에 실패해 답변이 없었다. 이 모델은 뒤의 두 문제에서도 실행에 실패했다. 이 문제에서는 나머지 모델 사이에 정답이나 답변 형식의 차이가 없었다.
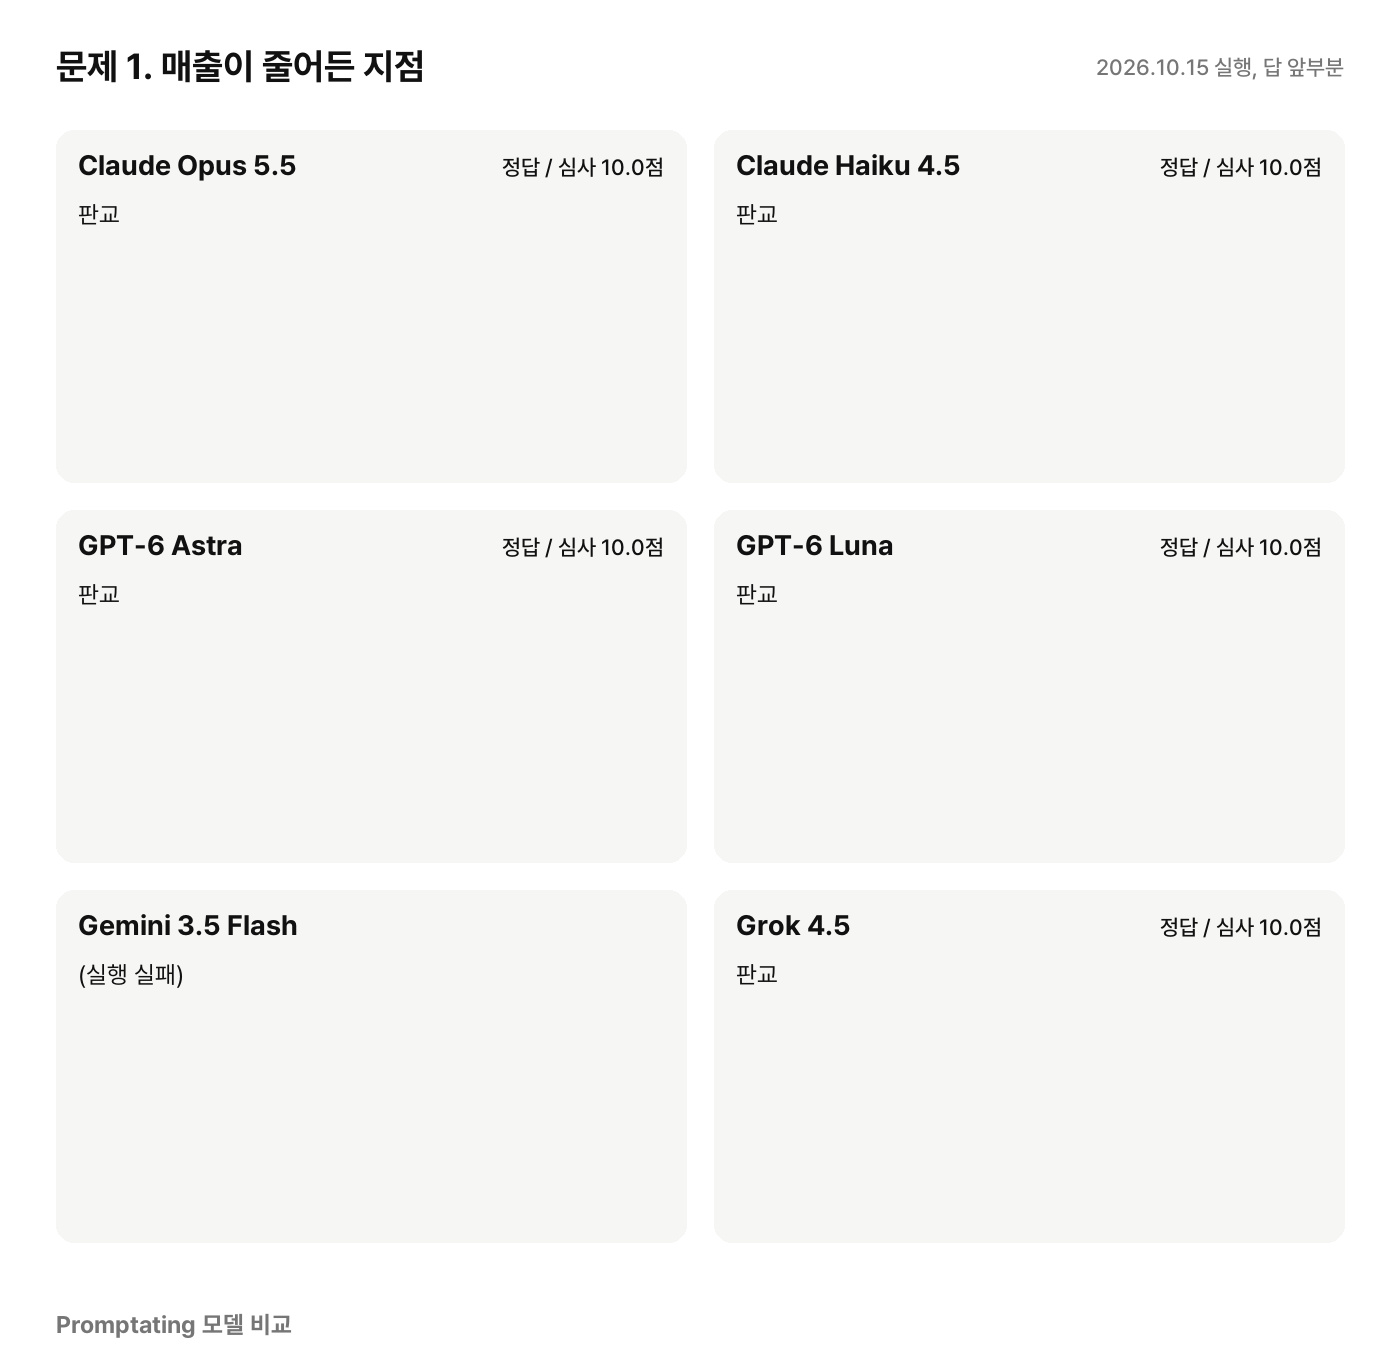
문제 1에 대한 모델별 실제 답 (2026년 10월 15일 실행, 앞부분만)
문제 2: 석 달 합계 1위
각 지점의 세 달 매출을 더하고, 그 합계를 비교하는지 보는 문제다.
지점별 월 매출(단위: 만 원)
| 지점 | 7월 | 8월 | 9월 |
|---|---|---|---|
| 강남 | 1250 | 1410 | 1380 |
| 홍대 | 980 | 1020 | 1150 |
| 판교 | 1100 | 1050 | 990 |

7~9월 합계가 가장 큰 지점과 그 합계는? '지점, 합계'처럼 쉼표 없는 숫자로 답해 (예: 강남, 1234).
이번에도 답변을 낸 다섯 모델 모두 정답이었다. 강남의 합계는 4040만 원으로 홍대 3150만 원, 판교 3140만 원보다 컸다. GPT-6 Astra, GPT-6 Luna, Grok 4.5는 “강남, 4040"이라고 답해 요청한 형식까지 맞췄고, 각각 10점을 받았다.
차이는 군더더기 설명에서 생겼다. Claude Opus 5.5는 다른 지점의 합계와 계산 과정을 덧붙여 8점이었다. Claude Haiku 4.5는 목록과 굵은 글씨를 써서 더 길게 설명했고 7점을 받았다. 두 심사위원 모두 계산은 맞았지만 간단히 답하라는 요구에서 벗어났다고 봤다. 답을 그대로 복사해 다른 문서에 옮기려면 이 차이가 걸림돌이 된다.
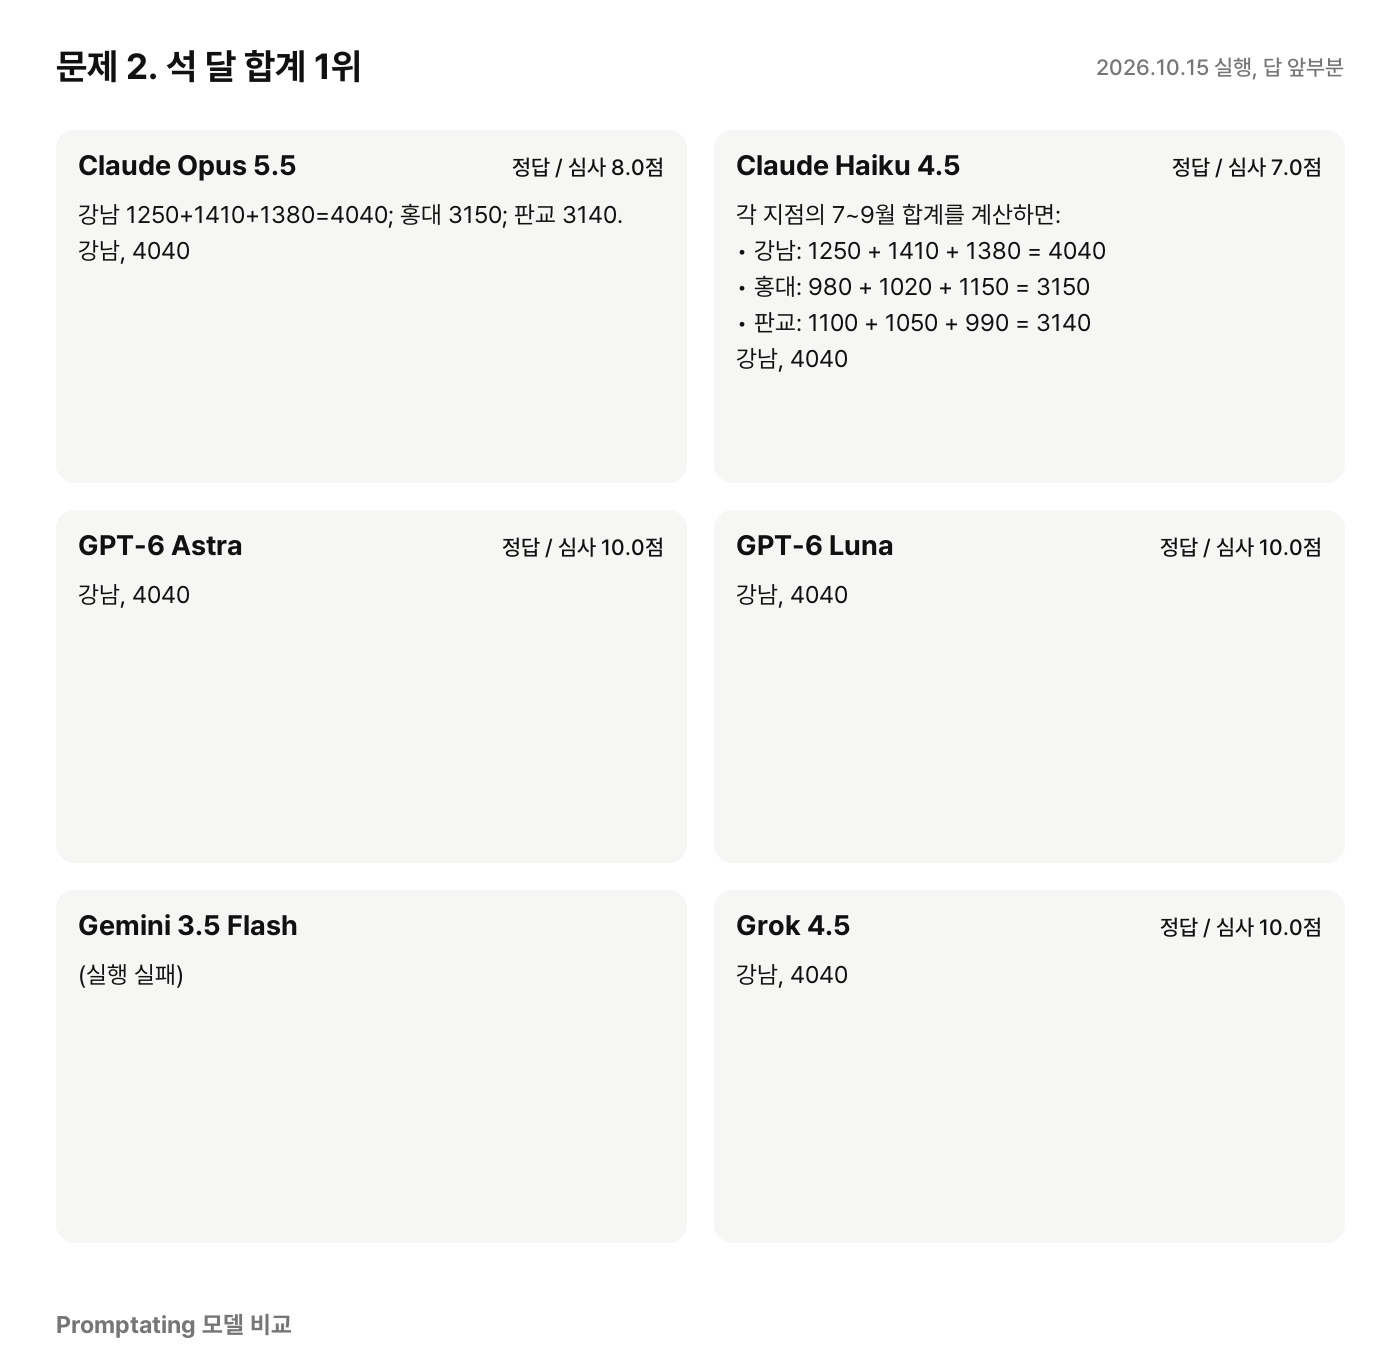
문제 2에 대한 모델별 실제 답 (2026년 10월 15일 실행, 앞부분만)
문제 3: 매출 증가율 계산
증가율을 구한 뒤, 요청한 소수 자릿수에 맞춰 반올림하는지 보는 문제다.
지점별 월 매출(단위: 만 원)
| 지점 | 7월 | 8월 | 9월 |
|---|---|---|---|
| 강남 | 1250 | 1410 | 1380 |
| 홍대 | 980 | 1020 | 1150 |
| 판교 | 1100 | 1050 | 990 |

8월보다 9월 매출 증가율이 가장 큰 지점과 그 증가율(%)은? 소수 둘째 자리에서 반올림해 '지점, 12.3%'처럼 답해.
Claude Opus 5.5, GPT-6 Astra, GPT-6 Luna, Grok 4.5가 홍대와 12.7%를 제시해 정답 판정을 받았다. 홍대의 매출 증가분 130만 원을 8월 매출 1020만 원으로 나누고 100을 곱하면 약 12.745%다. 소수 둘째 자리에서 반올림하면 12.7%가 된다.
Claude Haiku 4.5는 “홍대, 12.75%“라고 답해 오답 처리됐다. 지점은 맞았지만 소수 첫째 자리까지 쓰라는 조건을 지키지 못했다. 두 심사위원 모두 오답으로 봤고 평균 점수는 4.5점이었다. 준비 시간을 뺀 응답도 4.6초로 이 문제에서 가장 오래 걸렸다. 길게 풀고 오래 기다렸지만 최종 답은 틀렸다.
정답을 낸 네 모델은 모두 평균 9.5점이었다. 다만 설명을 보는 눈은 심사위원마다 달랐다. Claude Opus 5는 Claude Opus 5.5의 풀이가 답을 확인하는 데 도움이 된다며 10점을 줬다. GPT-6 Sol은 간단한 답을 요구했는데 풀이가 붙었다며 9점을 줬다. 심사 점수는 계산 정확성만이 아니라 답변 형식까지 반영한 값이다.
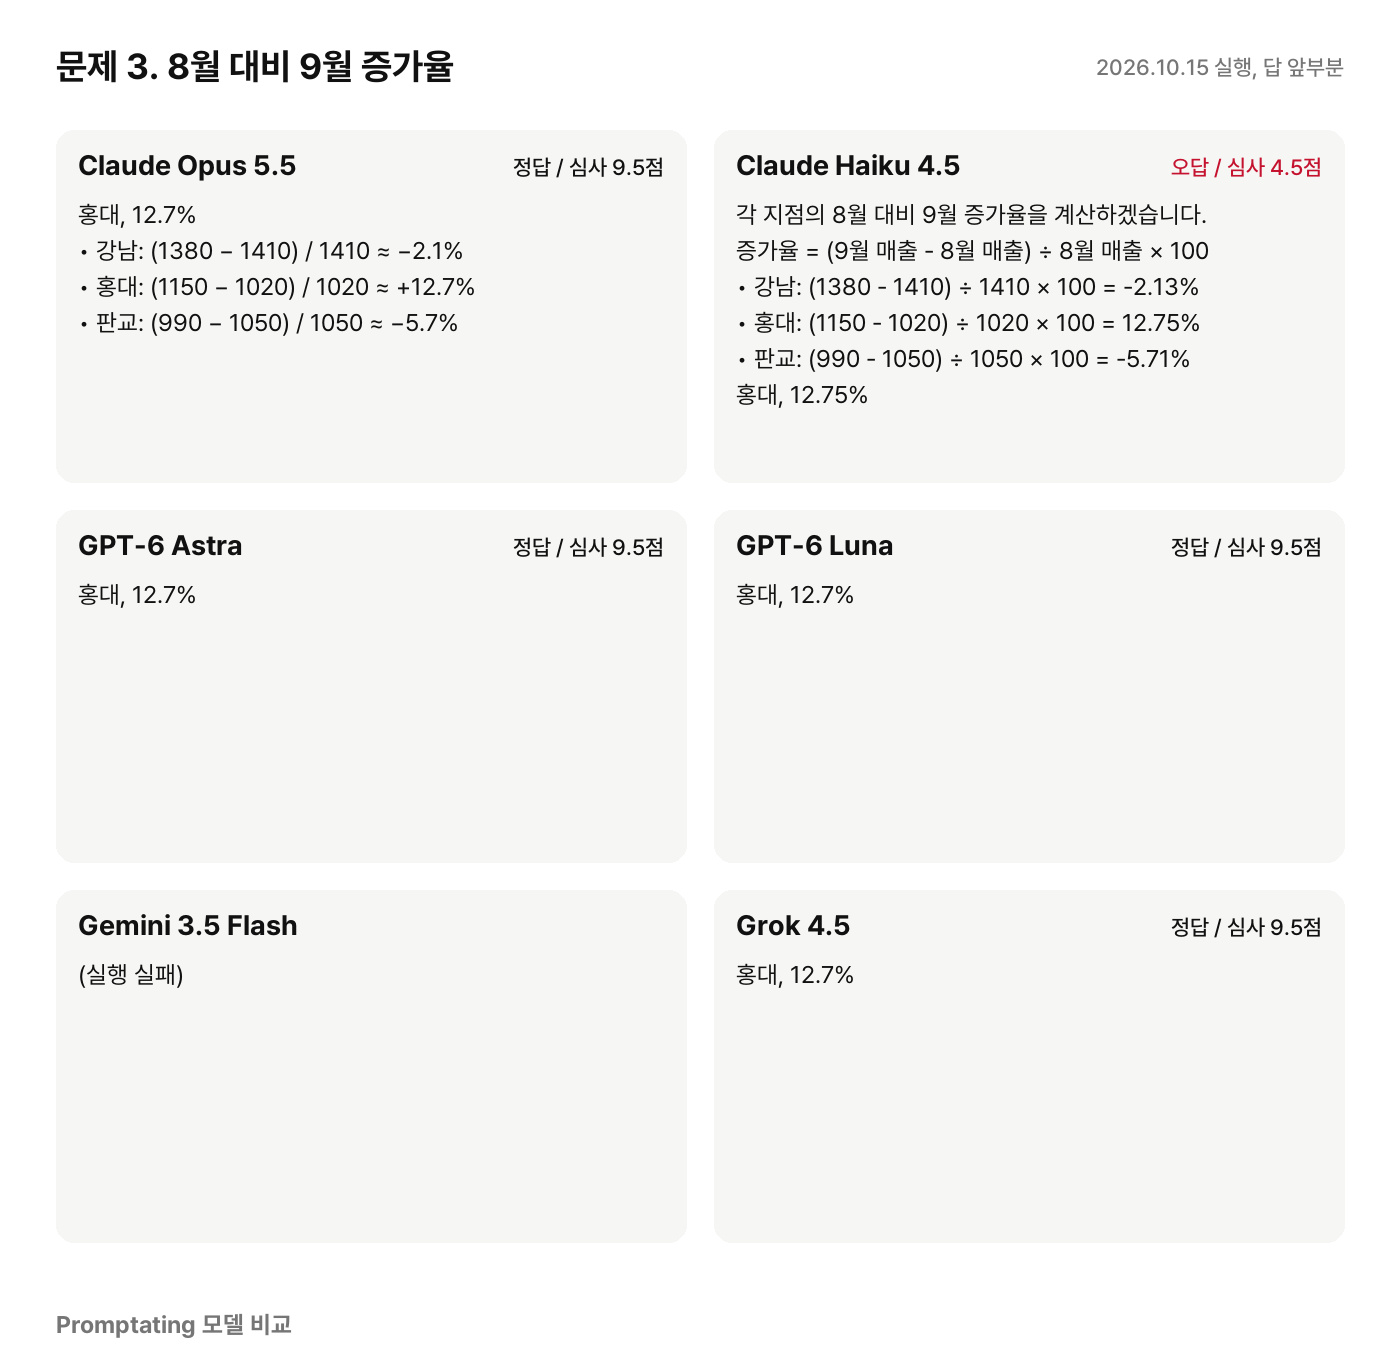
문제 3에 대한 모델별 실제 답 (2026년 10월 15일 실행, 앞부분만)
라운드 성적표
| 모델 | 평균 심사 점수 | 정답 | 평균 응답 시간 | 출력 속도(초당 글자) |
|---|---|---|---|---|
| Claude Opus 5.5 | 9.2점 | 3/3 | 0.8초 | 55 |
| Claude Haiku 4.5 | 7.2점 | 2/3 | 2.4초 | 44 |
| GPT-6 Astra | 9.8점 | 3/3 | 0.9초 | 33 |
| GPT-6 Luna | 9.8점 | 3/3 | 0.1초 | 59 |
| Gemini 3.5 Flash | — | 0/0 | — | — |
| Grok 4.5 | 9.8점 | 3/3 | 1.1초 | 9 |
응답 시간은 도구 준비 시간을 뺀 값이다. Gemini 3.5 Flash는 세 문제 모두 실행에 실패해 채점할 답변 자체가 없었다.
그래서 뭘 쓰면 될까
이런 작은 표에서 비교와 계산을 할 때는 가벼운 GPT-6 Luna로도 충분했다. 세 문제를 모두 맞혔고, 평균 9.8점으로 GPT-6 Astra와 Grok 4.5와 같았다.
빨리 답이 필요하다면 이번 측정에서 평균 0.1초였던 GPT-6 Luna를 먼저 고려할 만하다. 상위 모델 세 개는 평균 0.8~1.1초였고, 더 기다린 만큼 정답 수가 늘지는 않았다.
지금까지 쌓인 정답 기록까지 보려면 GPT-6 Astra, Claude Opus 5.5, Grok 4.5가 후보다. 세 모델은 누적 39문제를 모두 맞혔고, GPT-6 Luna는 39문제 중 32문제를 맞혔다.
지금까지 누적 순위
20개 라운드의 평균 심사 점수로 보면 GPT-6 Astra가 9.3점으로 앞섰다. Grok 4.5와 Claude Opus 5.5는 8.7점으로 같았다.
| 순위 | 모델 | 평균 심사 점수 | 정답 | 평균 응답 시간 |
|---|---|---|---|---|
| 1 | GPT-6 Astra | 9.3점 | 39/39 | 3.9초 |
| 공동 2 | Grok 4.5 | 8.7점 | 39/39 | 5.8초 |
| 공동 2 | Claude Opus 5.5 | 8.7점 | 39/39 | 3.9초 |
| 4 | Gemini 3.5 Flash | 8.2점 | 32/33 | 3.5초 |
| 5 | GPT-6 Luna | 8.0점 | 32/39 | 1.9초 |
| 6 | Claude Haiku 4.5 | 7.1점 | 38/39 | 8.4초 |
이번 비교의 한계
같은 표를 쓴 세 문제를 모델마다 한 번씩 실행한 결과다. 채점을 AI가 맡은 만큼 점수는 참고 값이고, 풀이를 덧붙인 답변을 두고도 두 심사위원의 평가가 갈렸다. 더 큰 표에서도 정확성과 형식이 지켜지는지, 같은 문제를 다시 풀려도 같은 결과가 나오는지는 다음 비교에서 확인할 점이다. 그래도 작은 표의 계산이라면 가벼운 모델을 한번 써볼 근거는 나왔다.