리퀴드AI, 내 기기에서 도구 쓰는 LFM2.5 공개
LFM2.5-24B-A2B는 한 번에 읽는 분량을 이전 모델보다 늘리고 도구 사용과 지시 수행에 초점을 맞췄다. 모델 파일을 내려받아 개인 기기에서 돌릴 수 있다.
리퀴드AI가 10월 13일(현지시간) LFM2.5-24B-A2B를 공개했다. 개인 기기에서 스스로 일을 처리하는 AI(에이전트)를 겨냥한 모델이다. 바로 쓸 수 있는 완성 모델과 추가 학습의 바탕이 되는 Base 모델을 허깅페이스에 함께 올렸다. 사용자는 모델을 내려받아 자기 기기에서 실행하거나 자신의 업무에 맞게 추가 학습할 수 있다.
한 번에 읽는 분량, 얼마나 늘었나
이번 모델은 이전 모델 LFM2-24B-A2B의 기본 구조를 이어받으면서 한 번에 읽을 수 있는 분량을 늘렸다. 글자 조각 단위인 토큰 기준으로 이전에는 3만2000개였지만, 새 모델은 약 13만1000개를 처리한다. 긴 자료를 참고하는 작업에 쓸 수 있도록 읽기 범위를 넓혔다.
답을 만드는 방식도 바뀌었다. 새 모델은 최종 답변을 내놓기 전에 풀이 과정을 먼저 쓴다. 이때 매 단계마다 전체 모델 가운데 일부만 작동한다. 리퀴드AI는 이 방식으로 풀이 과정에 드는 계산 부담을 줄였다고 설명했다. 학습에는 수학, 코드, 지시 수행과 여러 언어의 글을 반영했고 도구를 불러 쓰며 여러 차례 작업을 이어가는 과정도 넣었다.
도구 쓰는 일, 큰 모델보다 잘할까
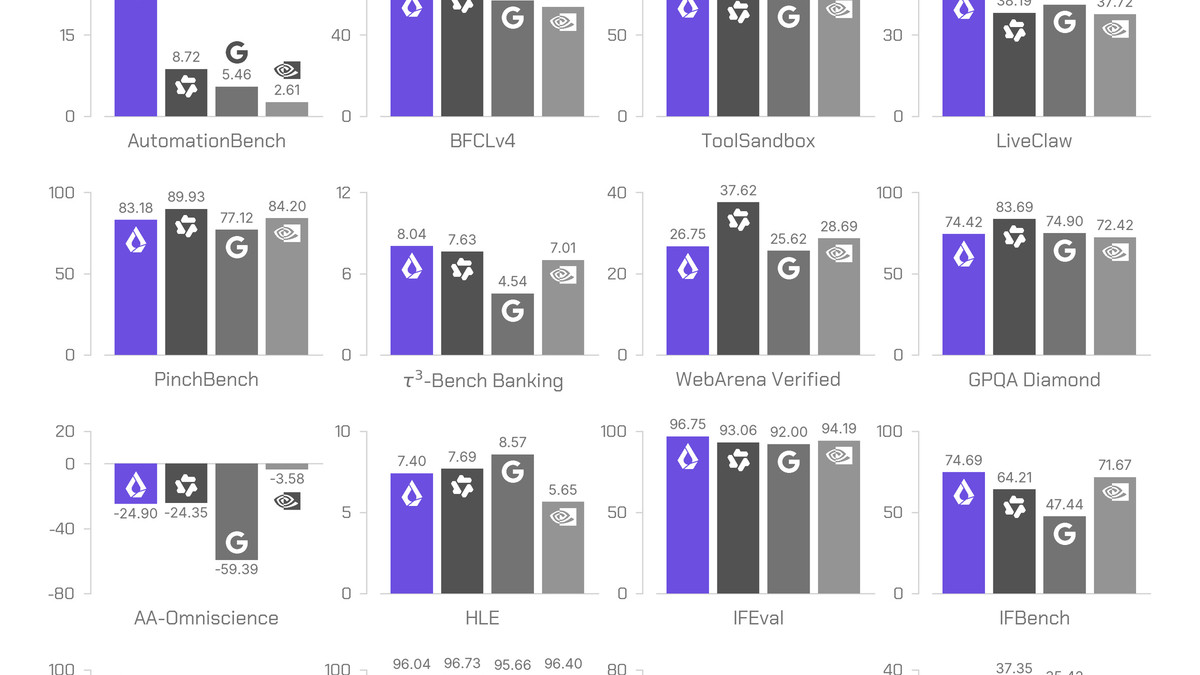
리퀴드AI는 도구 사용부터 지식, 수학, 코딩까지 성능 시험 16개에서 경쟁 모델과 비교했다. 비교 대상은 Qwen3.6-35B-A3B, Gemma-4-26B-A4B-it, Nemotron-3.5-Lightning이다. 각 시험이 권장하는 답변 생성 설정을 적용했다고 회사는 밝혔다.
이미지: huggingface.co
리퀴드AI에 따르면 LFM2.5-24B-A2B는 도구 사용과 에이전트 관련 시험 8개 중 5개에서 비교 모델보다 앞서거나 대등했다. LiveClaw 점수는 48.09로 Qwen3.6-35B-A3B의 38.19보다 높았다. 지시 수행 시험 3개에서는 모두 앞섰다. 사용자의 요구에 따라 도구를 골라 작업을 진행하는 능력을 주요 강점으로 내세웠다.
지식과 코딩에서는 더 큰 모델이 앞선 영역도 있었다. 리퀴드AI는 GPQA Diamond 같은 지식 중심 시험과 SWE-Bench Verified 같은 코딩 시험에서 큰 모델이 더 좋은 성적을 냈다고 설명했다. 그러면서 지식이 많이 필요한 업무에는 자료 검색이나 웹 검색을 함께 쓰라고 권했다.
내 기기에서는 얼마나 빠를까
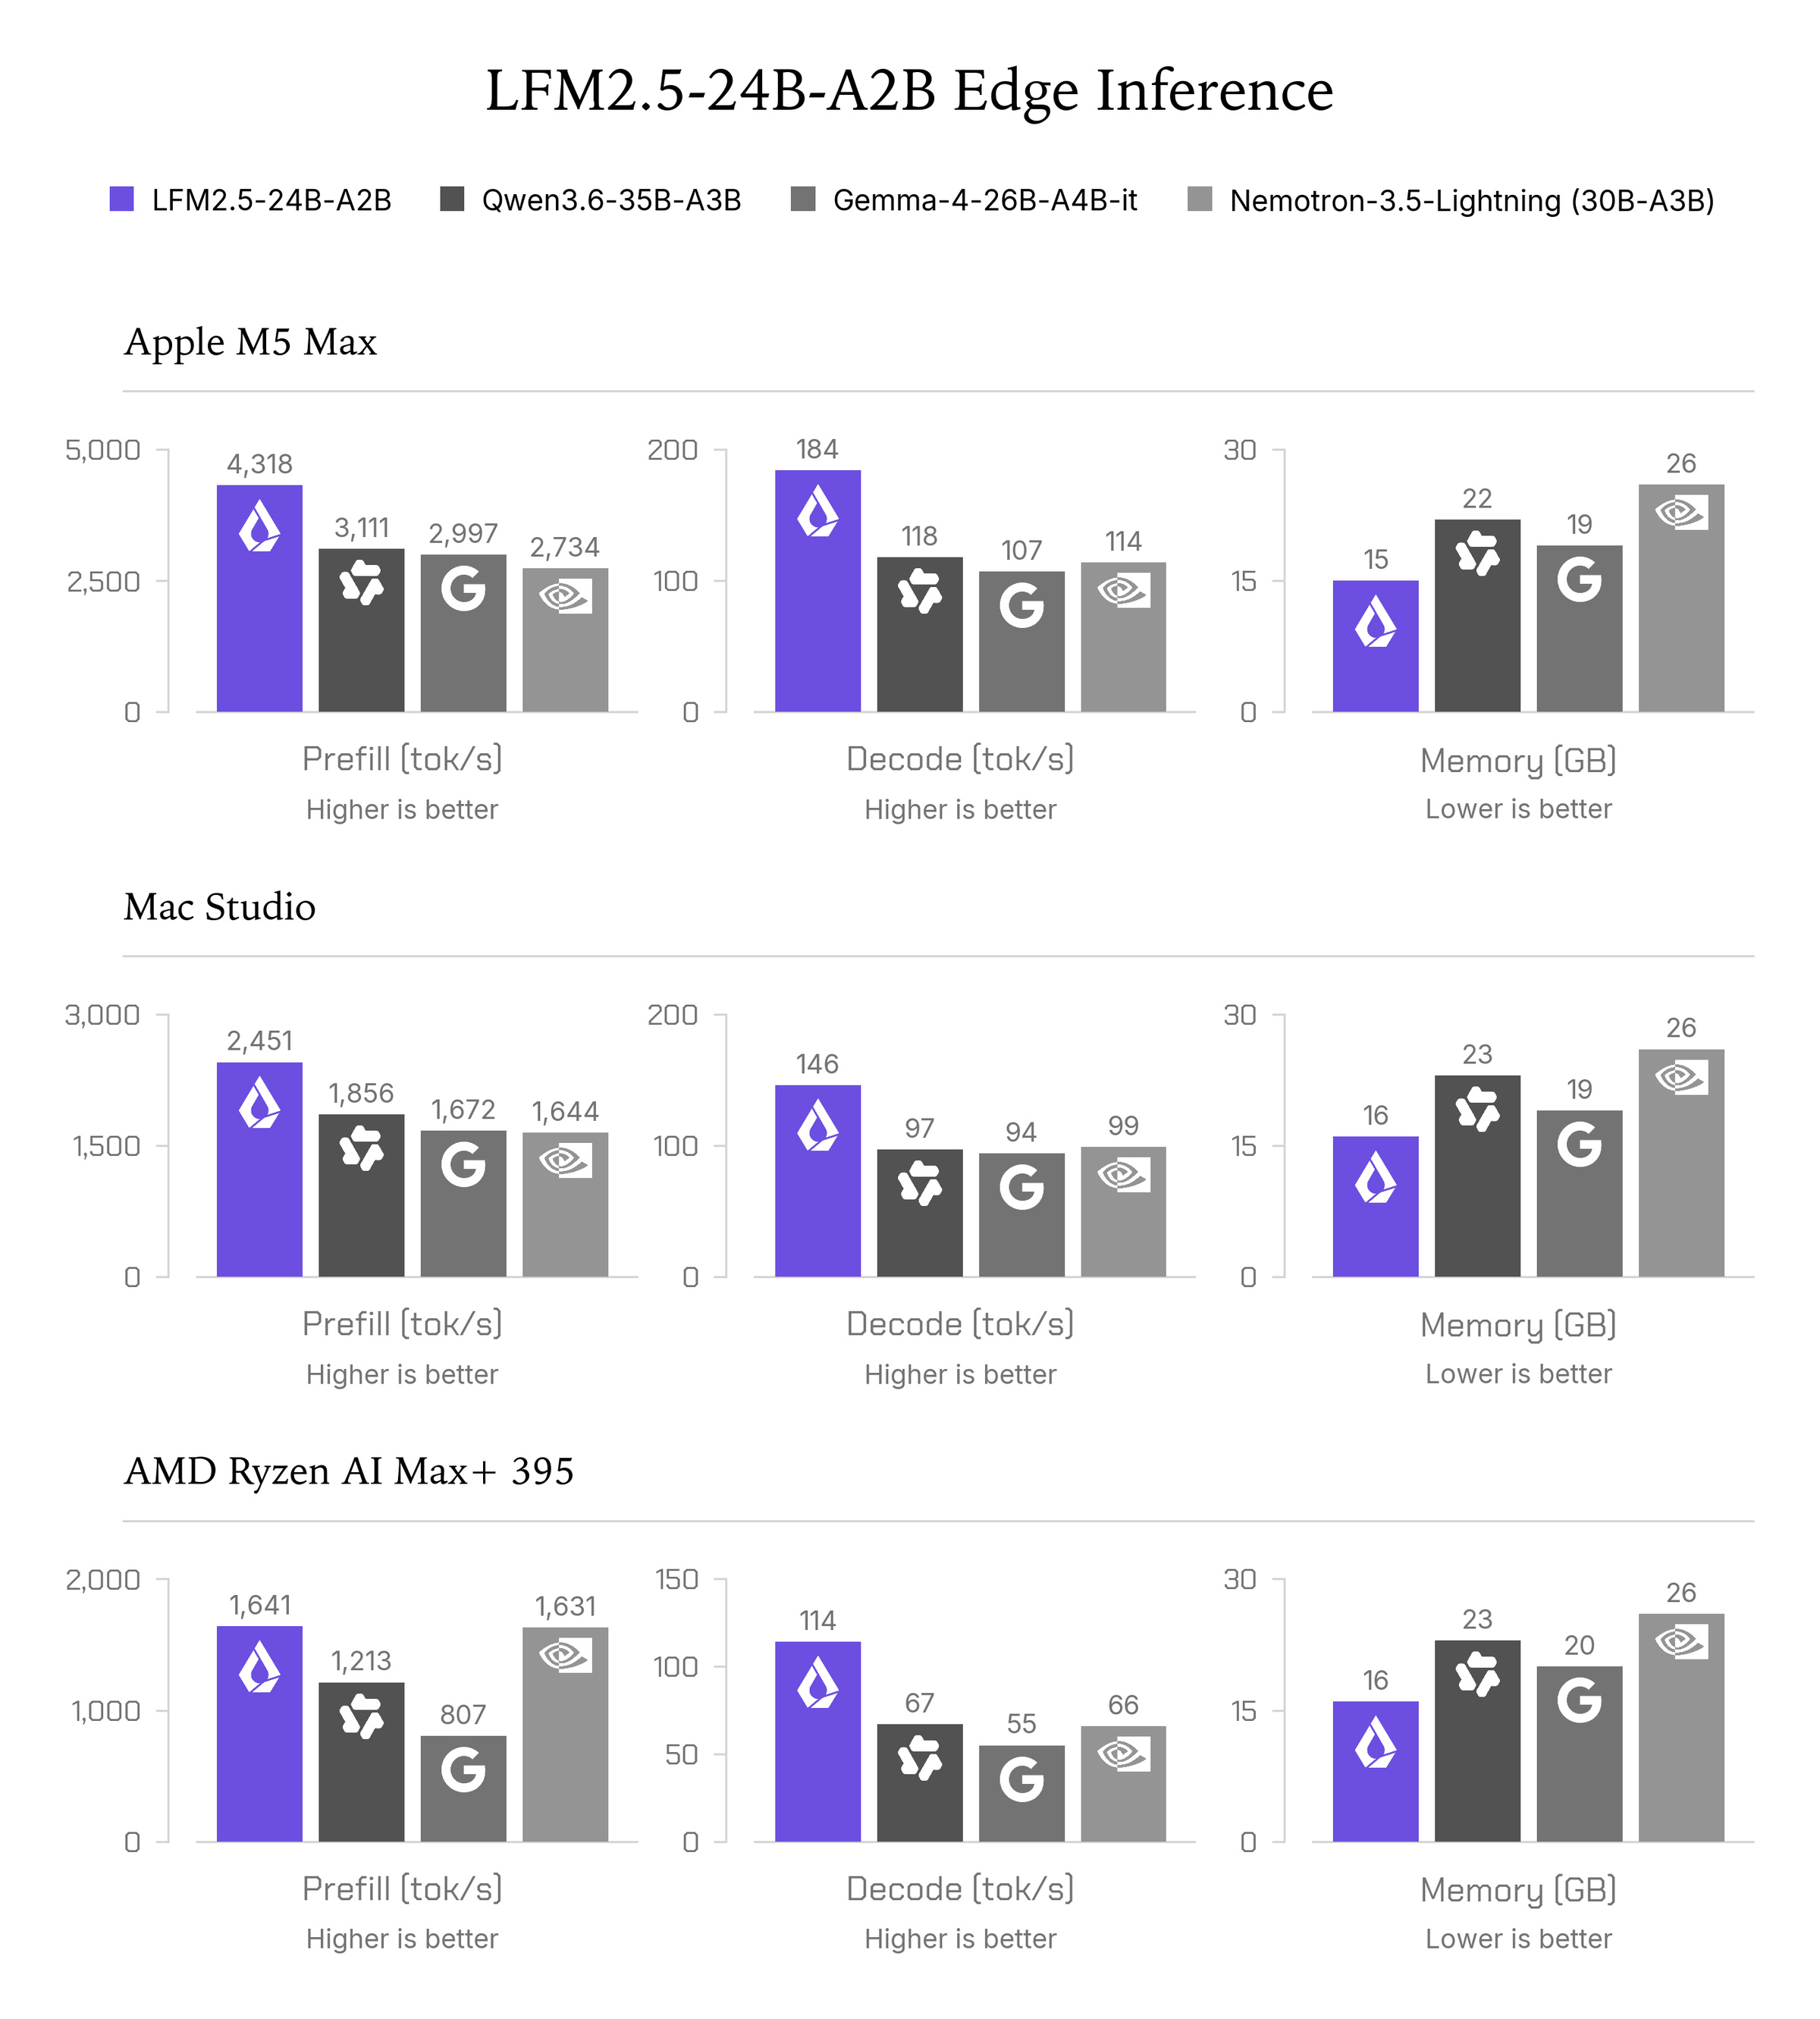
리퀴드AI는 애플 M5 Max에서 초당 184개, Ryzen AI Max+ 395에서 초당 114개의 글자 조각을 만들었다고 밝혔다. 비교 대상 가운데 다음으로 빠른 모델보다 최대 1.7배 빠르고 메모리 사용량도 가장 적었다는 설명이다.
이미지: huggingface.co
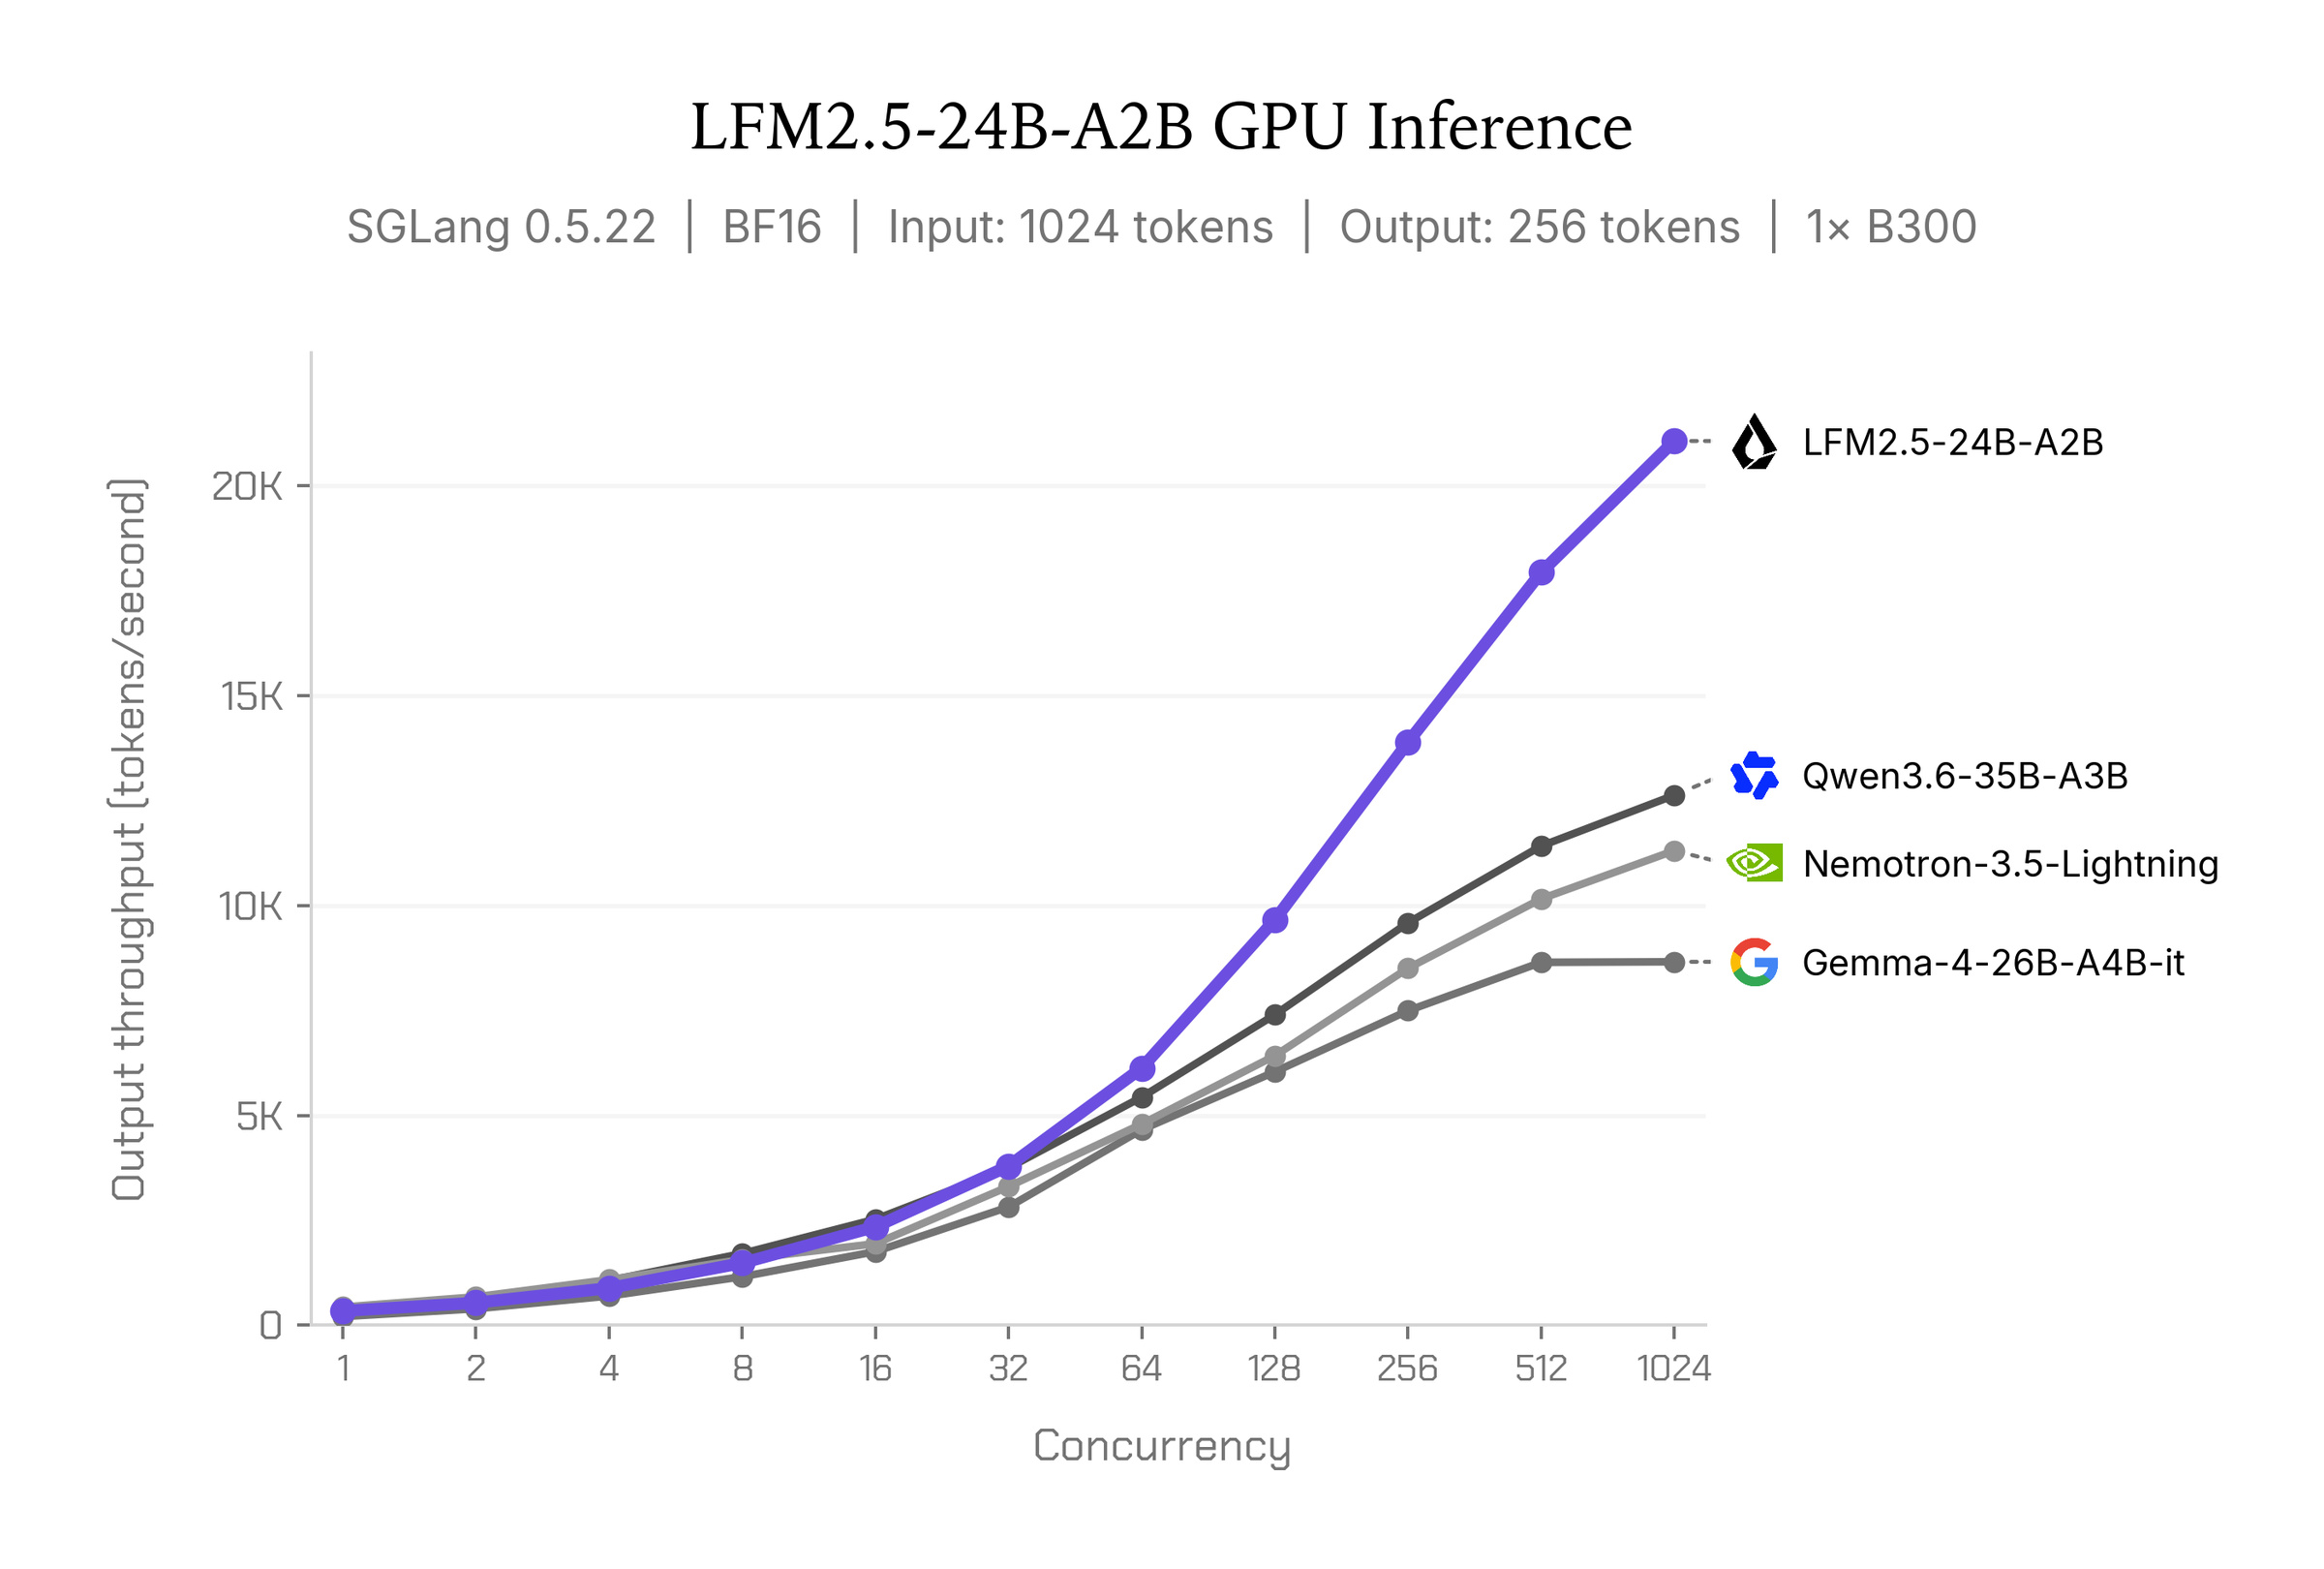
여러 요청을 동시에 처리하는 환경에서는 엔비디아 B300 한 대로 초당 2만1000개가 넘는 글자 조각을 내놓았다고 회사는 밝혔다. 공개 첫날부터 여러 모델 실행 도구를 지원하고, 기기에서 모델을 띄운 뒤 Hermes Agent 같은 작업용 프로그램에 연결하는 방법도 안내했다.
이번 공개로 직접 내려받아 도구 사용 작업에 붙여 쓸 수 있는 모델이 하나 늘었다. 한국 이용자라면 한국어 지시를 얼마나 잘 따르는지, 가진 기기의 메모리로 무리 없이 돌아가는지를 먼저 따져봐야 한다. 회사가 직접 잰 속도와 함께 한국어 작업 성능, 필요한 장비와 이용 조건을 확인한 뒤 도입을 판단할 일이다.