날짜 계산 3문제, 가벼운 Claude Haiku 4.5도 다 맞혔다
가벼운 Claude Haiku 4.5도 세 문제를 모두 맞혔다. 반면 가장 빨랐던 GPT-6 Luna는 영업일 계산에서 하루를 틀렸다.
시차와 마감일, AI에 맡겨도 될까
10월 8일 날짜 계산 문제 세 개를 여섯 모델에 똑같이 던졌다. 네 모델이 세 문제를 모두 맞혔다. 해외 동료와 약속을 잡거나 계약 마감을 정할 때는 한 시간, 하루 차이가 중요하다. 그래서 정답뿐 아니라 답하는 속도도 함께 봤다.
가벼운 모델도 전부 맞힐 수 있었다. Claude Haiku 4.5는 세 문제 모두 정답이었다. 반면 가장 빨랐던 GPT-6 Luna는 평균 0.2초에 답하면서 마감일을 하루 늦게 잡았다. 상위 모델 GPT-6 Astra는 평균 1.7초에 세 문제를 모두 맞혔다.
어떻게 시험했나
비교 대상은 여섯 모델이다. 앤트로픽은 상위 모델 Claude Opus 5.5와 가벼운 Claude Haiku 4.5, 오픈AI는 상위 모델 GPT-6 Astra와 가벼운 GPT-6 Luna를 넣었다. 여기에 구글의 가벼운 모델 Gemini 3.5 Flash와 xAI의 상위 모델 Grok 4.5를 더했다. 뒤의 두 모델은 GitHub Copilot으로 실행했다.
2026년 10월 8일 모든 모델에 같은 프롬프트, 즉 AI에게 주는 지시문을 넣었다. 기본 설정으로 문제마다 한 번씩 실행했다. 채점은 Claude Opus 5와 GPT-6 Sol이 맡았다. 답변을 쓴 모델이 어디인지 모르는 상태에서 각각 1~10점을 매겼다. 두 심사위원이 모두 맞다고 본 답만 정답으로 인정했고, 의견이 갈리면 ‘판정 갈림’으로 처리했다.
문제 1: 뉴욕에서는 몇 시일까
서머타임을 반영하고, 시차 때문에 날짜까지 바뀌는지 보는 문제다.
서울에서 2026년 10월 15일 오전 9시에 화상 회의를 연다. 이때 미국 뉴욕 현지 시각은? '10월 14일 20:00'처럼 날짜와 24시간제 시각으로 마지막 줄에 답만 적어.
답을 낸 다섯 모델은 모두 정답인 뉴욕 10월 14일 20:00을 제시했다. Gemini 3.5 Flash는 실행에 실패했다. GPT-6 Astra, GPT-6 Luna, Grok 4.5는 날짜와 시각만 적어 각각 10점을 받았다. 이 문제에서 GPT-6 Luna의 응답 시간은 0.1초였다.
정답이 같아도 설명의 정확성은 달랐다. Claude Haiku 4.5는 “뉴욕에서 14시간 뒤로"라고 답하면서 계산 과정에서는 시차를 13시간으로 적었다. 최종 시각은 맞았지만 설명이 서로 어긋나 6점에 그쳤다. Claude Opus 5.5는 시차 설명도 정확하다는 평가를 받았으나, 설명이 길다는 이유로 8점을 받았다.
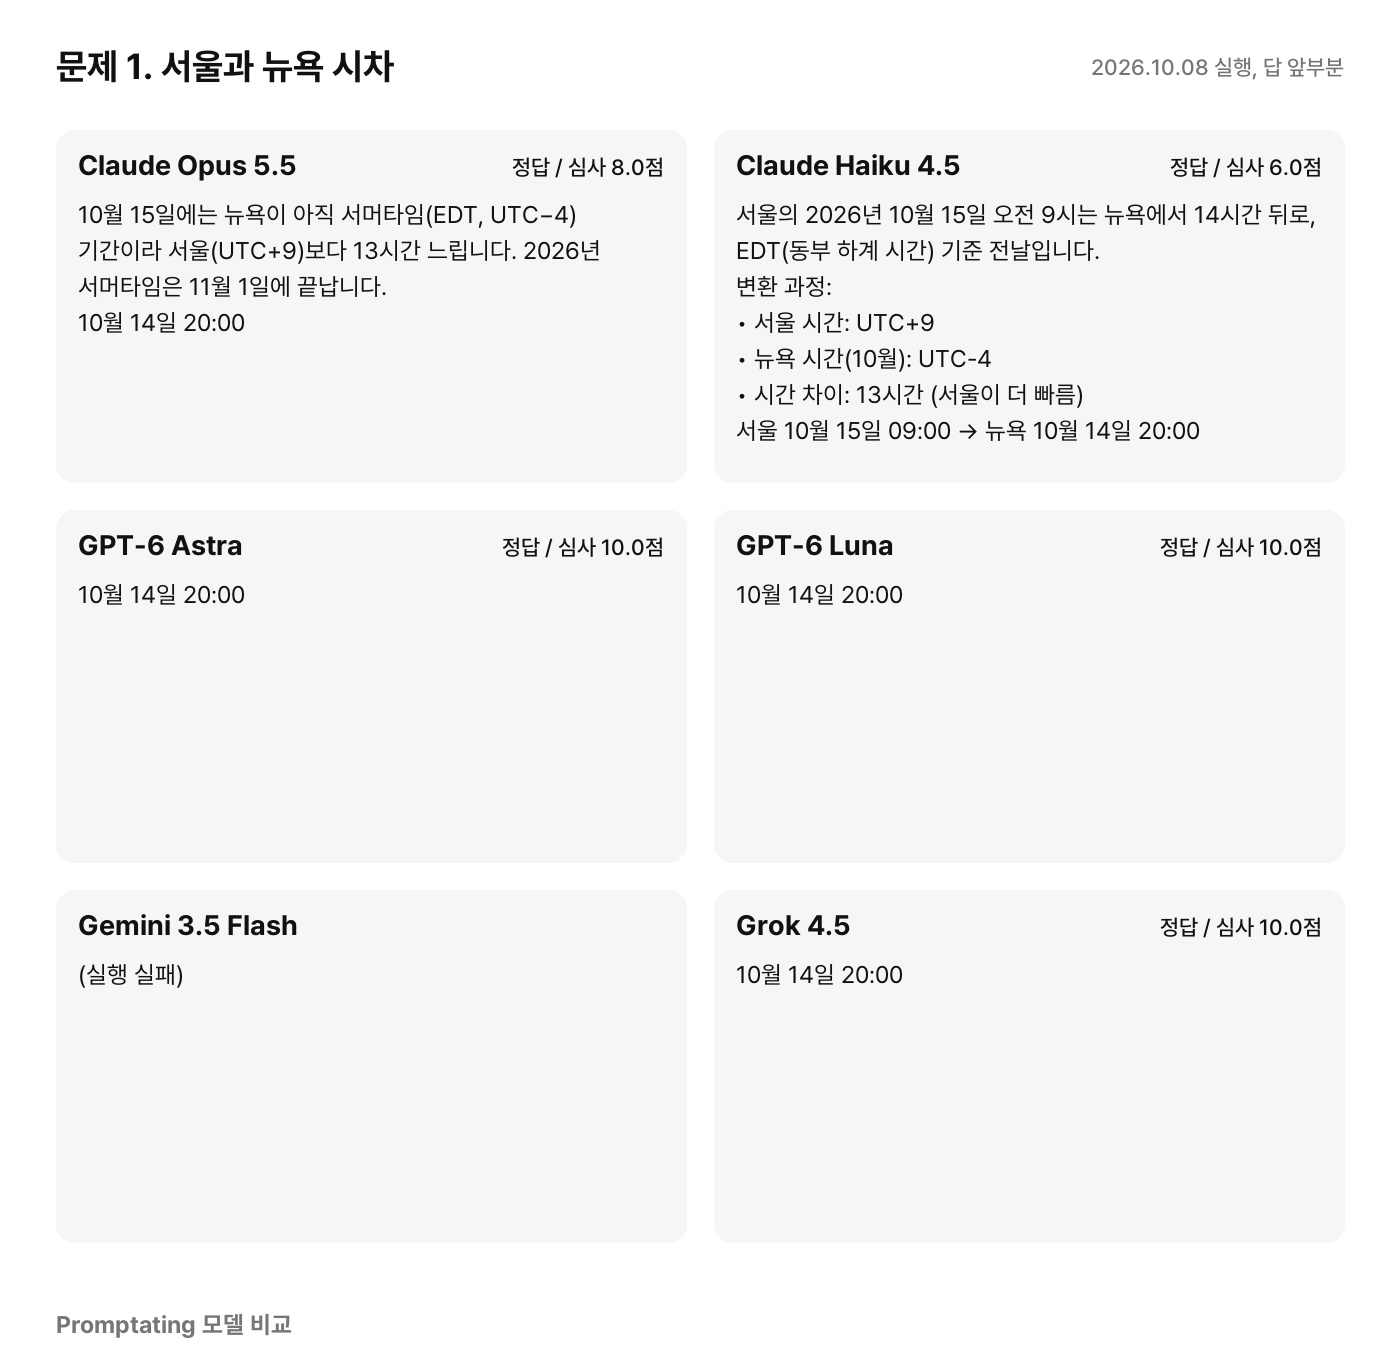
문제 1에 대한 모델별 실제 답 (2026년 10월 8일 실행, 앞부분만)
문제 2: 한글날을 빼면 마감은 언제일까
계약 다음 영업일부터 세면서 주말과 지정된 공휴일을 정확히 빼는지 살폈다.
2026년 10월 5일(월)에 계약했다. 다음 영업일부터 세어 10번째 영업일이 마감이다. 토요일, 일요일과 10월 9일(금, 한글날)은 영업일이 아니다. 마감일은 몇 월 며칠인가? 마지막 줄에 '10월 1일'처럼 답만 적어.
정답은 10월 20일이다. Claude Opus 5.5, Claude Haiku 4.5, GPT-6 Astra, Grok 4.5가 맞혔다. GPT-6 Luna는 “10월 21일"이라고 답해 유일한 오답을 냈고 2점을 받았다. 응답은 0.1초로 빨랐지만, 계약 마감에 그대로 적용하면 하루 늦은 날짜를 안내하게 된다. Gemini 3.5 Flash는 이번에도 실행에 실패했다.
계산을 따라가며 확인하고 싶다면 두 Claude 모델의 답이 눈에 띈다. 날짜별로 영업일을 세어 열 번째 날까지 보여줬다. 이 설명을 두고는 심사위원의 평가가 갈렸다. Claude Haiku 4.5에 Claude Opus 5는 계산 과정과 형식을 높게 평가해 10점을 줬고, GPT-6 Sol은 설명이 길다며 8점을 줬다.
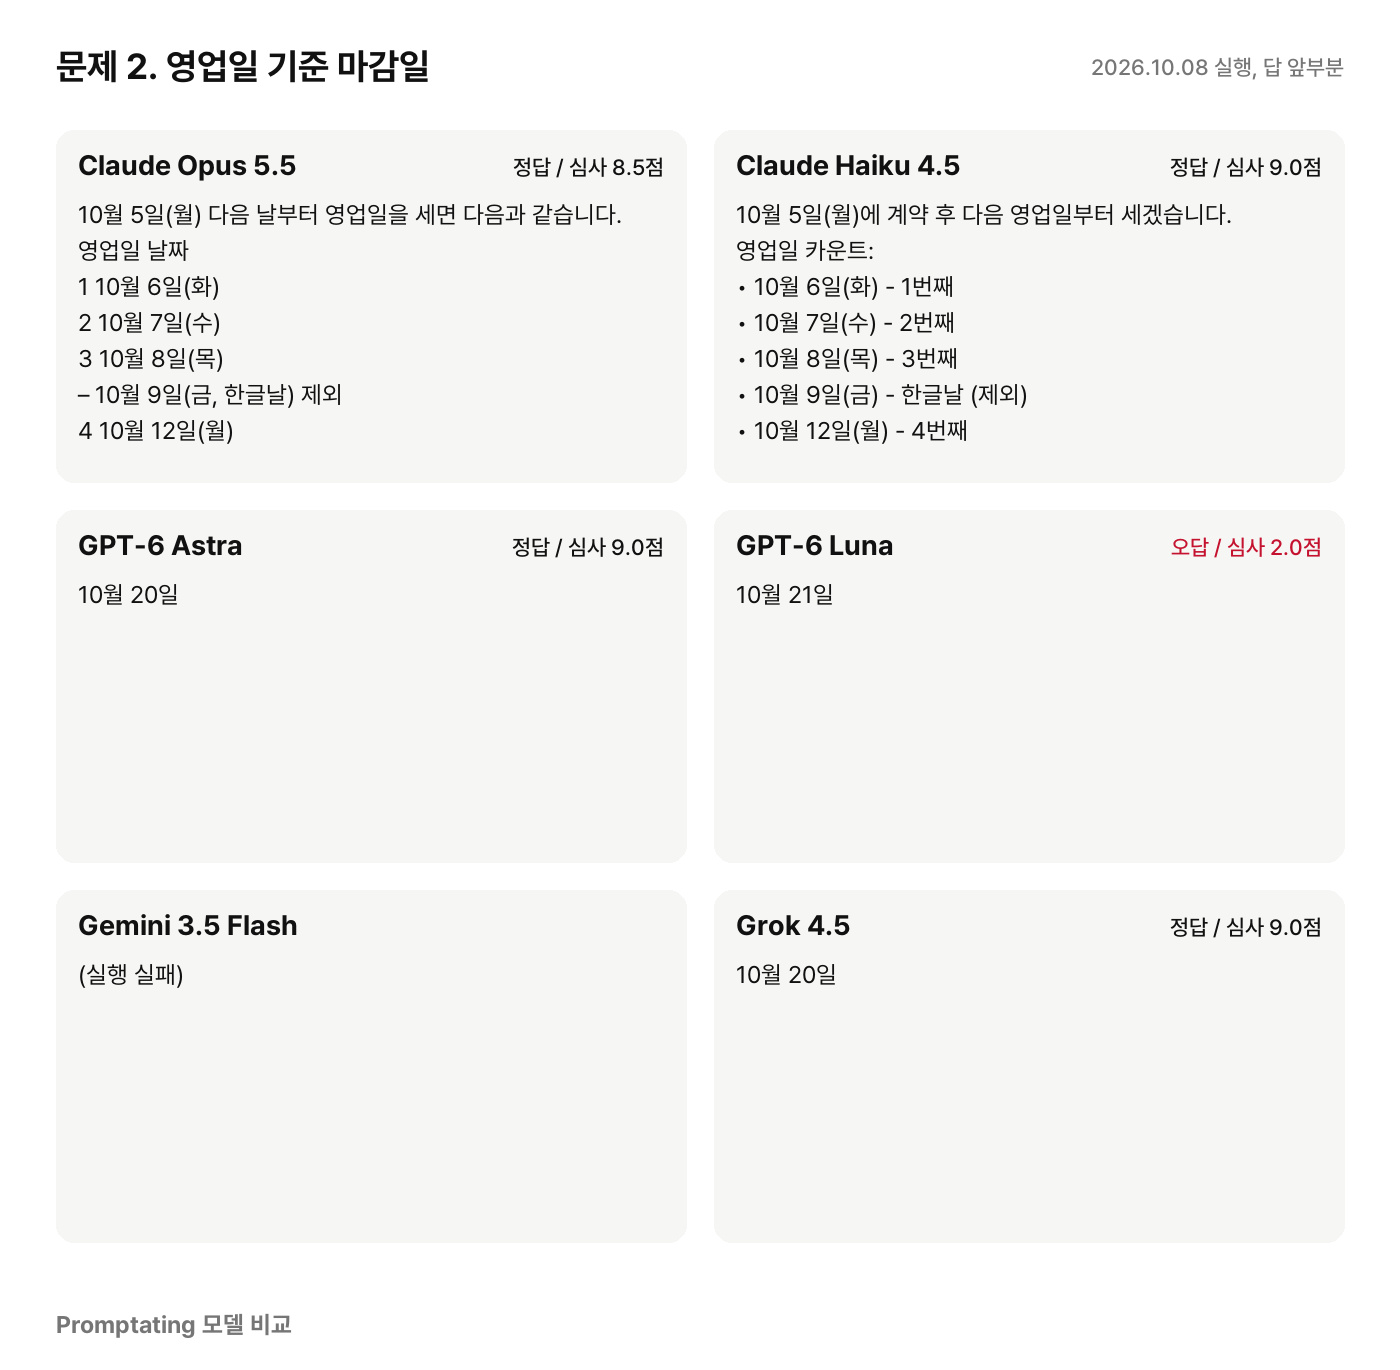
문제 2에 대한 모델별 실제 답 (2026년 10월 8일 실행, 앞부분만)
문제 3: 세 사람의 빈 시간은 언제일까
여러 일정에서 모두 겹치는 30분 구간을 빠짐없이 찾는 문제다.
30분짜리 회의를 잡으려 한다. 같은 날 가능한 시간은 다음과 같다.
A: 10:00~12:00, 14:00~17:00
B: 11:00~15:00
C: 09:00~11:30, 14:30~18:00
세 사람이 모두 되는 30분 구간을 모두 '11:00~11:30'처럼 적어.
답을 낸 다섯 모델은 오전 11:0011:30과 오후 14:3015:00을 모두 찾았다. GPT-6 Astra는 두 구간만 줄바꿈해 적었다. GPT-6 Luna와 Grok 4.5도 두 구간만 간결하게 제시해 세 모델 모두 10점을 받았다. 두 Claude 모델은 설명이나 서식을 덧붙여 각각 9점을 받았다. Gemini 3.5 Flash는 세 번째 문제도 실행에 실패해 이번 라운드 점수를 받지 못했다.
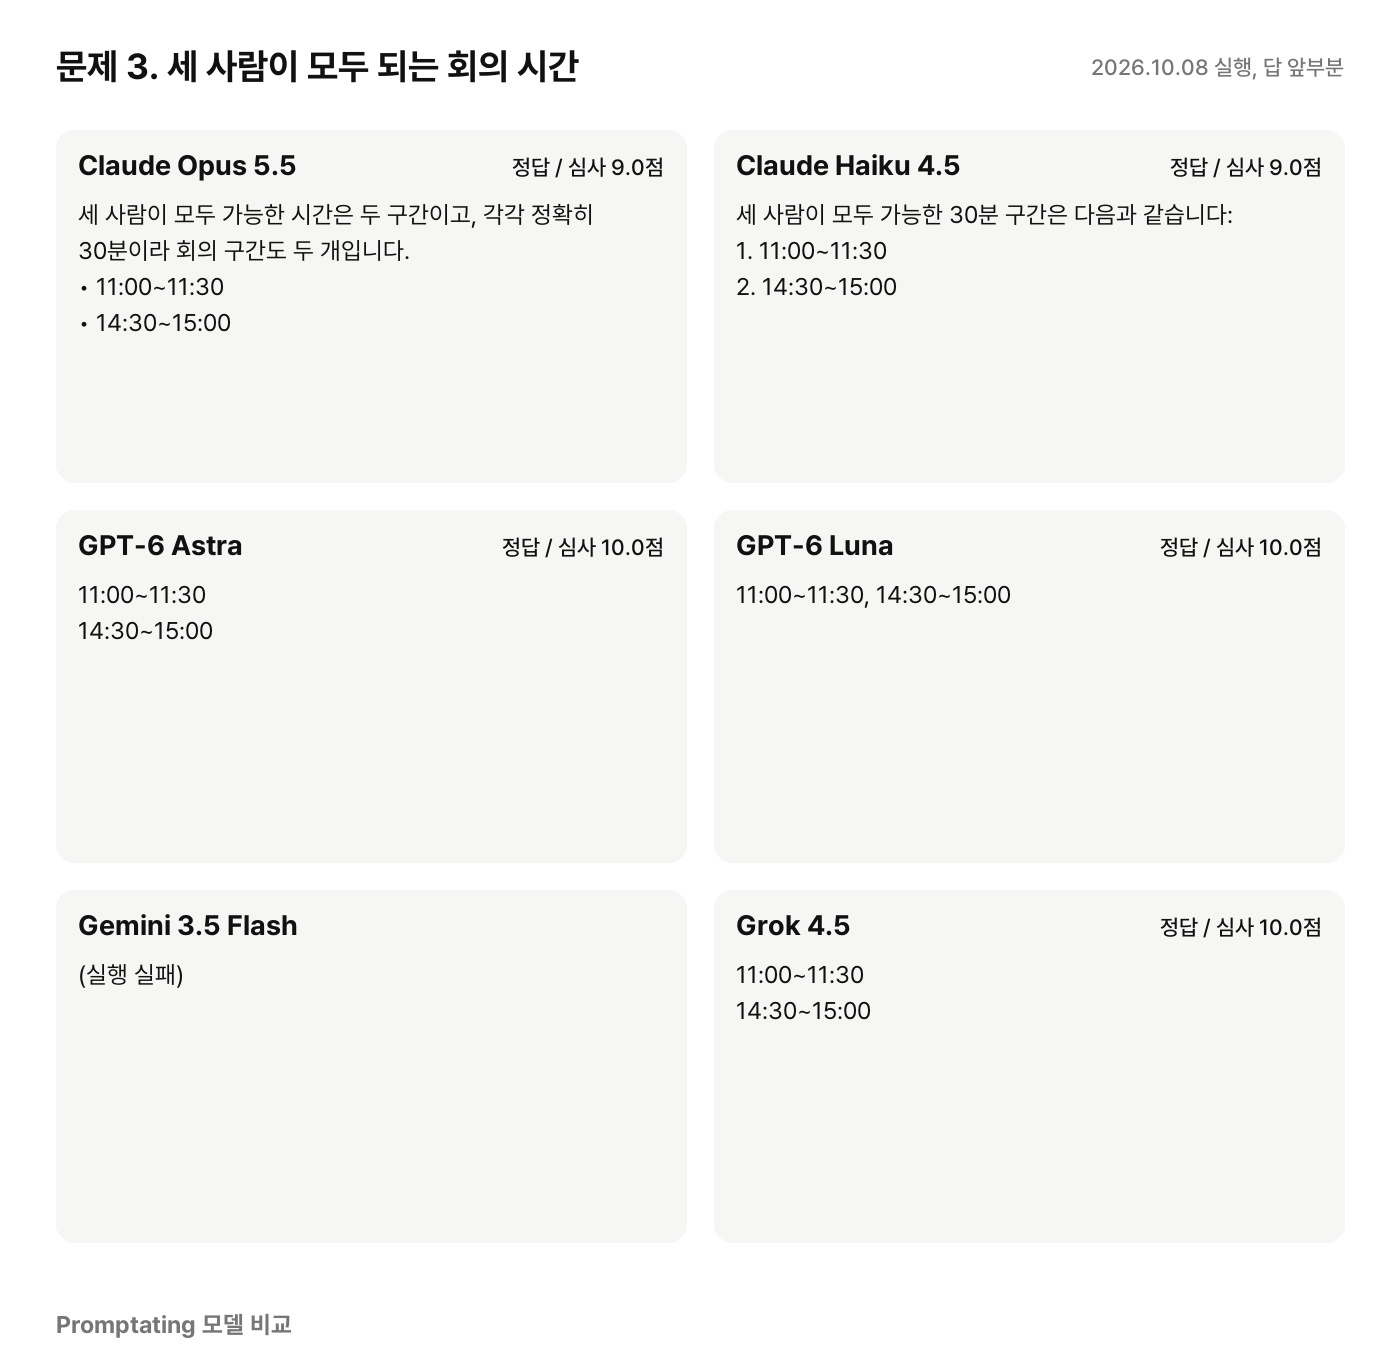
문제 3에 대한 모델별 실제 답 (2026년 10월 8일 실행, 앞부분만)
라운드 성적표
| 모델 | 평균 심사 점수 | 정답 | 평균 응답 시간 | 출력 속도(초당 글자) |
|---|---|---|---|---|
| Claude Opus 5.5 | 8.5점 | 3/3 | 2.5초 | 59 |
| Claude Haiku 4.5 | 8.0점 | 3/3 | 3.6초 | 45 |
| GPT-6 Astra | 9.7점 | 3/3 | 1.7초 | 9 |
| GPT-6 Luna | 7.3점 | 2/3 | 0.2초 | 97 |
| Gemini 3.5 Flash | — | 0/0(실행 실패) | — | — |
| Grok 4.5 | 9.7점 | 3/3 | 3.3초 | 5 |
응답 시간은 도구 준비 시간을 뺀 값이다. 모델마다 실행 경로가 달라 참고용 수치다.
준비 시간은 각 모델이 “OK” 한마디를 출력하는 데 걸린 시간으로 재고, 출력 속도는 답변 글자 수를 응답 시간으로 나눠 구했다. 짧게 정답만 쓴 모델은 초당 글자 수가 낮아도 답을 더 일찍 끝낼 수 있다. GPT-6 Astra와 Grok 4.5는 평균 9.7점으로 공동 선두였지만, 답을 마치는 시간은 GPT-6 Astra가 더 짧았다.
그래서 뭘 쓰면 될까
마감일을 정확하고 짧게 받고 싶다면 GPT-6 Astra가 먼저다. 이번 세 문제를 모두 맞히고 평균 1.7초에 끝냈다. Grok 4.5도 정답 수와 점수가 같았지만 평균 응답은 3.3초였다.
계산 과정을 직접 따라가고 싶다면 Claude Haiku 4.5도 선택지다. 가벼운 모델로 세 문제를 모두 맞혔고 영업일 계산도 풀어 썼다. 다만 시차 설명에는 앞뒤가 맞지 않는 대목이 있었다. 평균 3.6초로, 상위 모델 Claude Opus 5.5의 2.5초보다 느리기도 했다.
빠른 답이 급할 때는 평균 0.2초의 GPT-6 Luna가 눈에 띈다. 대신 영업일 마감은 따로 계산해 점검하는 편이 좋다. 가벼운 모델로도 세 문제를 다 풀 수 있었던 만큼, 등급만 보고 고르기는 어렵다.
지금까지 누적 순위
19개 라운드의 평균 심사 점수 순이다. 같은 점수는 공동 순위로 표시했다.
| 순위 | 모델 | 평균 심사 점수 | 정답 | 평균 응답 시간 |
|---|---|---|---|---|
| 1 | GPT-6 Astra | 9.3점 | 36/36 | 4.1초 |
| 공동 2 | Grok 4.5 | 8.6점 | 36/36 | 6.0초 |
| 공동 2 | Claude Opus 5.5 | 8.6점 | 36/36 | 4.1초 |
| 4 | Gemini 3.5 Flash | 8.2점 | 32/33 | 3.6초 |
| 5 | GPT-6 Luna | 7.9점 | 29/36 | 2.0초 |
| 6 | Claude Haiku 4.5 | 7.1점 | 36/36 | 8.7초 |
이번 비교의 한계
문제는 세 개였고, 모델마다 한 번씩만 실행했다. AI가 매긴 점수는 참고 값이며, 설명 길이를 보는 기준도 두 심사위원이 달랐다. 선택 기준을 더 분명히 하려면 같은 문제를 여러 번 반복하고, 다른 공휴일과 시차 조건에서도 정답이 유지되는지 봐야 한다. 이번 라운드는 날짜 계산에서 속도와 정확성을 함께 봐야 한다는 점을 보여줬다.