오픈AI, EU ChatGPT 글에 보이지 않는 출처 표시 넣는다
앞으로 몇 주에 걸쳐 EU 대상 이용자의 ChatGPT와 Codex 글에 눈에 보이지 않는 신호를 심는다. 찾아내는 도구는 승인된 연구자부터 쓰고, 글을 고치거나 번역하면 찾기 어려워진다.
오픈AI가 10월 5일(현지시간) 글에 눈에 보이지 않는 출처 표시를 넣는 계획을 발표했다. EU의 AI 규제법(EU AI Act)에 맞추기 위한 조치다. 앞으로 몇 주에 걸쳐 EU의 대상 이용자에게 ChatGPT와 Codex가 내놓는 글에 순차 적용한다. 요금제와 상관없이 적용하지만, 출시 시점에 전 세계 이용자에게 기본으로 켜지지는 않는다.
글에 어떤 표시가 남나
textGrain이라는 기술로 AI가 단어를 고르는 과정에 눈에 보이지 않는 통계 신호를 심는다. 전용 탐지기는 글에 오픈AI의 워터마크 신호가 있는지 확인한다. 읽는 사람 눈에 표시가 보이는 방식이 아니라, 별도 도구로 흔적을 찾아내는 방식이다. 오픈AI는 이 기술을 앞으로 오픈소스로 공개할 계획이다.
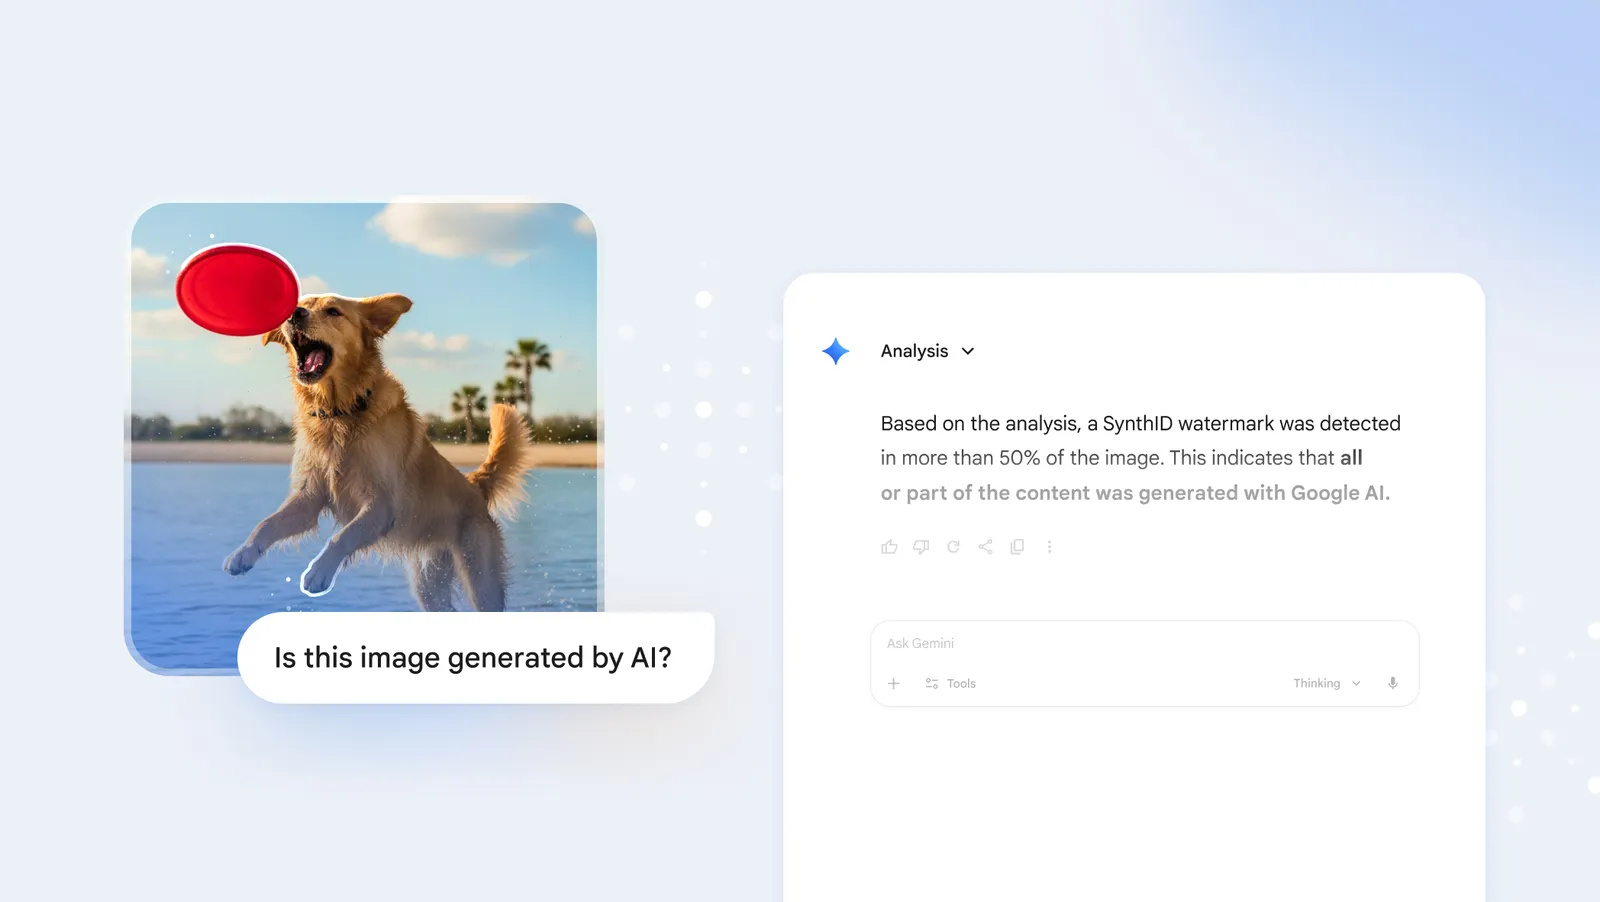
오픈AI는 이미 이미지와 소리에는 출처 표시를 넣고 있다. 지원되는 이미지에는 출처 정보를 담는 Content Credentials를 붙이고, 지원되는 이미지와 오디오에는 눈에 보이지 않는 SynthID 워터마크를 넣는다. 기존 이미지와 오디오 확인 도구, 개발자용 출처 확인 기능도 계속 쓸 수 있다.
글을 조금 고치면 못 찾을까
탐지율은 글의 길이와 분야에 따라 갈렸다. 워터마크가 없는 글을 워터마크가 있다고 잘못 짚는 비율을 1%로 맞췄을 때, 심리학 분야 글에서는 약 80~95%를 찾아냈다. 글 길이가 글자 조각 200개에서 400개로 늘자 탐지율도 올랐다. 반면 단어를 바꿀 여지가 적은 수학 분야에서는 탐지율이 크게 떨어졌다.
출처: OpenAI
단어를 손보면 탐지율은 더 내려갔다. 글자 조각 400개 분량에서 단어의 10%를 비슷한 말로 바꾸자 탐지율이 약 92%에서 66%로 낮아졌다. 바꾼 단어가 25%에 이르면 17%까지 떨어졌다. 오픈AI는 짧은 글, 편집이나 번역을 거친 글, 지원하지 않는 모델이 쓴 글도 찾기 어려울 수 있다고 설명했다.
오픈AI는 이 표시가 사람의 기여도나 이용자 신원, 글의 정확성을 알려주지는 않는다고 밝혔다. 신호가 없는 글이 사람이 쓴 글이라는 보장도 없다는 설명이다.
누가 언제부터 쓸 수 있나
개발자가 서비스에 붙여 쓰는 방식에서는 10월 5일부터 선택할 수 있다. 전 세계 고객이 일부 모델에서 워터마크가 들어간 글을 받도록 설정할 수 있고, 기본값은 꺼져 있다. 오픈AI는 클라우드 파트너가 제공하는 자사 모델에도 몇 주 안에 적용하도록 협력하고 있다. 탐지기는 같은 날부터 연구자와 전문 기관의 신청을 받아 승인된 곳에만 권한을 준다. 잘못 짚거나 놓칠 위험이 있어 출시 시점에 일반 공개는 하지 않는다고 밝혔다.
이미지: OpenAI
오픈AI는 워터마크를 넣어도 답변 성능이 떨어지지 않았다고 밝혔다. Astra를 여러 성능 시험에 돌린 결과 적용 전후에 의미 있는 차이가 없었다는 것이다. 시험별 점수는 일부 올랐고 일부 내려갔다.
한국에서도 개발자 고객은 일부 모델에서 워터마크 적용을 선택할 수 있다. 앞으로 지켜볼 점은 한국어 글에서도 신호를 잘 찾아내는지, 편집이나 번역 뒤에도 신호가 남는지다. 연구자와 전문 기관이 먼저 써 보는 과정에서 드러날 오류도 실제 활용 범위를 가를 변수다.