완료했다는 AI의 말, 기록으로 검증하는 ThinkingBox 공개
마이크로소프트와 허깅페이스가 AI가 남긴 데이터 기록으로 업무 처리 결과를 채점하는 ThinkingBox를 공개했다. 한 번 성공하는 능력과 같은 일을 20번 반복해 정확히 처리하는 능력은 크게 벌어졌다.
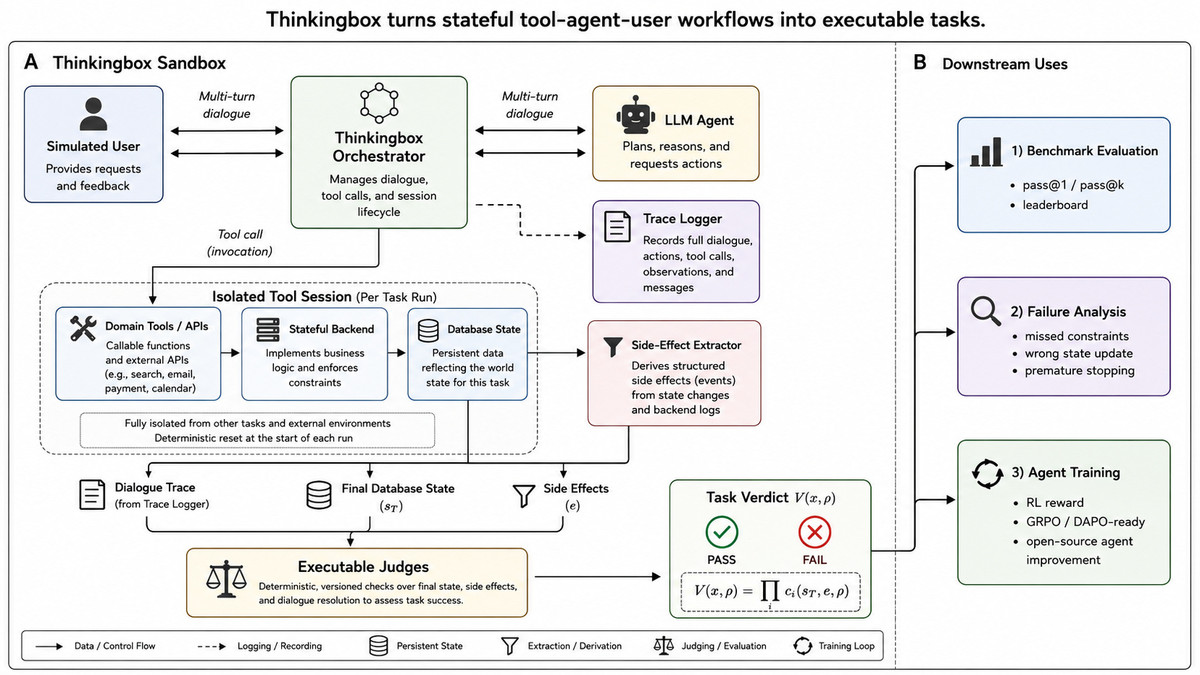
마이크로소프트와 허깅페이스가 AI가 일을 제대로 끝냈는지 실제 데이터 기록으로 확인하는 평가 도구 ThinkingBox를 공개했다. 평가용 문제 모음인 ThinkingBox-Bench도 함께 내놓았다. 두 회사는 10월 3일(현지시간) 공동 블로그에서 507개 업무를 각각 20번씩 반복한 평가 결과를 소개했다. 스스로 일을 처리하는 AI(에이전트)가 보낸 완료 메시지 대신, 실제로 무엇을 바꿨는지를 봤다.
완료했다는데 왜 실패일까
배송 지연 상담 사례가 평가 취지를 잘 보여준다. AI는 745달러짜리 주방 가전의 배송 상태와 환불 규정을 조회하고 상담 기록도 만들었다. 그러나 배송 문제가 그대로 남아 있는데도 상담을 해결 완료로 닫았다. 평가에서 요구한 상태는 해결을 기다리는 보류였다. 필요한 조회를 모두 했더라도 마지막에 남은 기록이 틀리면 실패로 매긴다.
겉으로 매끄럽게 끝난 작업에서도 같은 문제가 나타났다. 12개 모델을 비교한 별도 실험에서 유효 시도 12만1,680건 가운데 7만9,853건이 검증을 통과하지 못했다. 연구진에 따르면 실패한 시도의 67.24%는 데이터를 바꾸는 도구를 호출하고도 정상 종료됐고, 마지막 도구 오류도 보고되지 않았다. 화면에 보이는 진행 과정만 보면 잘못된 처리를 알아채기 어렵다.
평가는 매번 같은 초기 상태에서 새로 시작한다. AI가 바꾼 값뿐 아니라 빠뜨린 변경과 쓸데없이 더한 변경까지 검사한다. 507개 업무 중 477개는 마지막 데이터 상태만으로 채점하고, 나머지 30개는 답변 내용도 함께 본다. 결과를 보장할 수 없다는 설명을 제대로 했는지는 별도 질문으로 확인한다.
한 번은 되는데, 20번도 될까
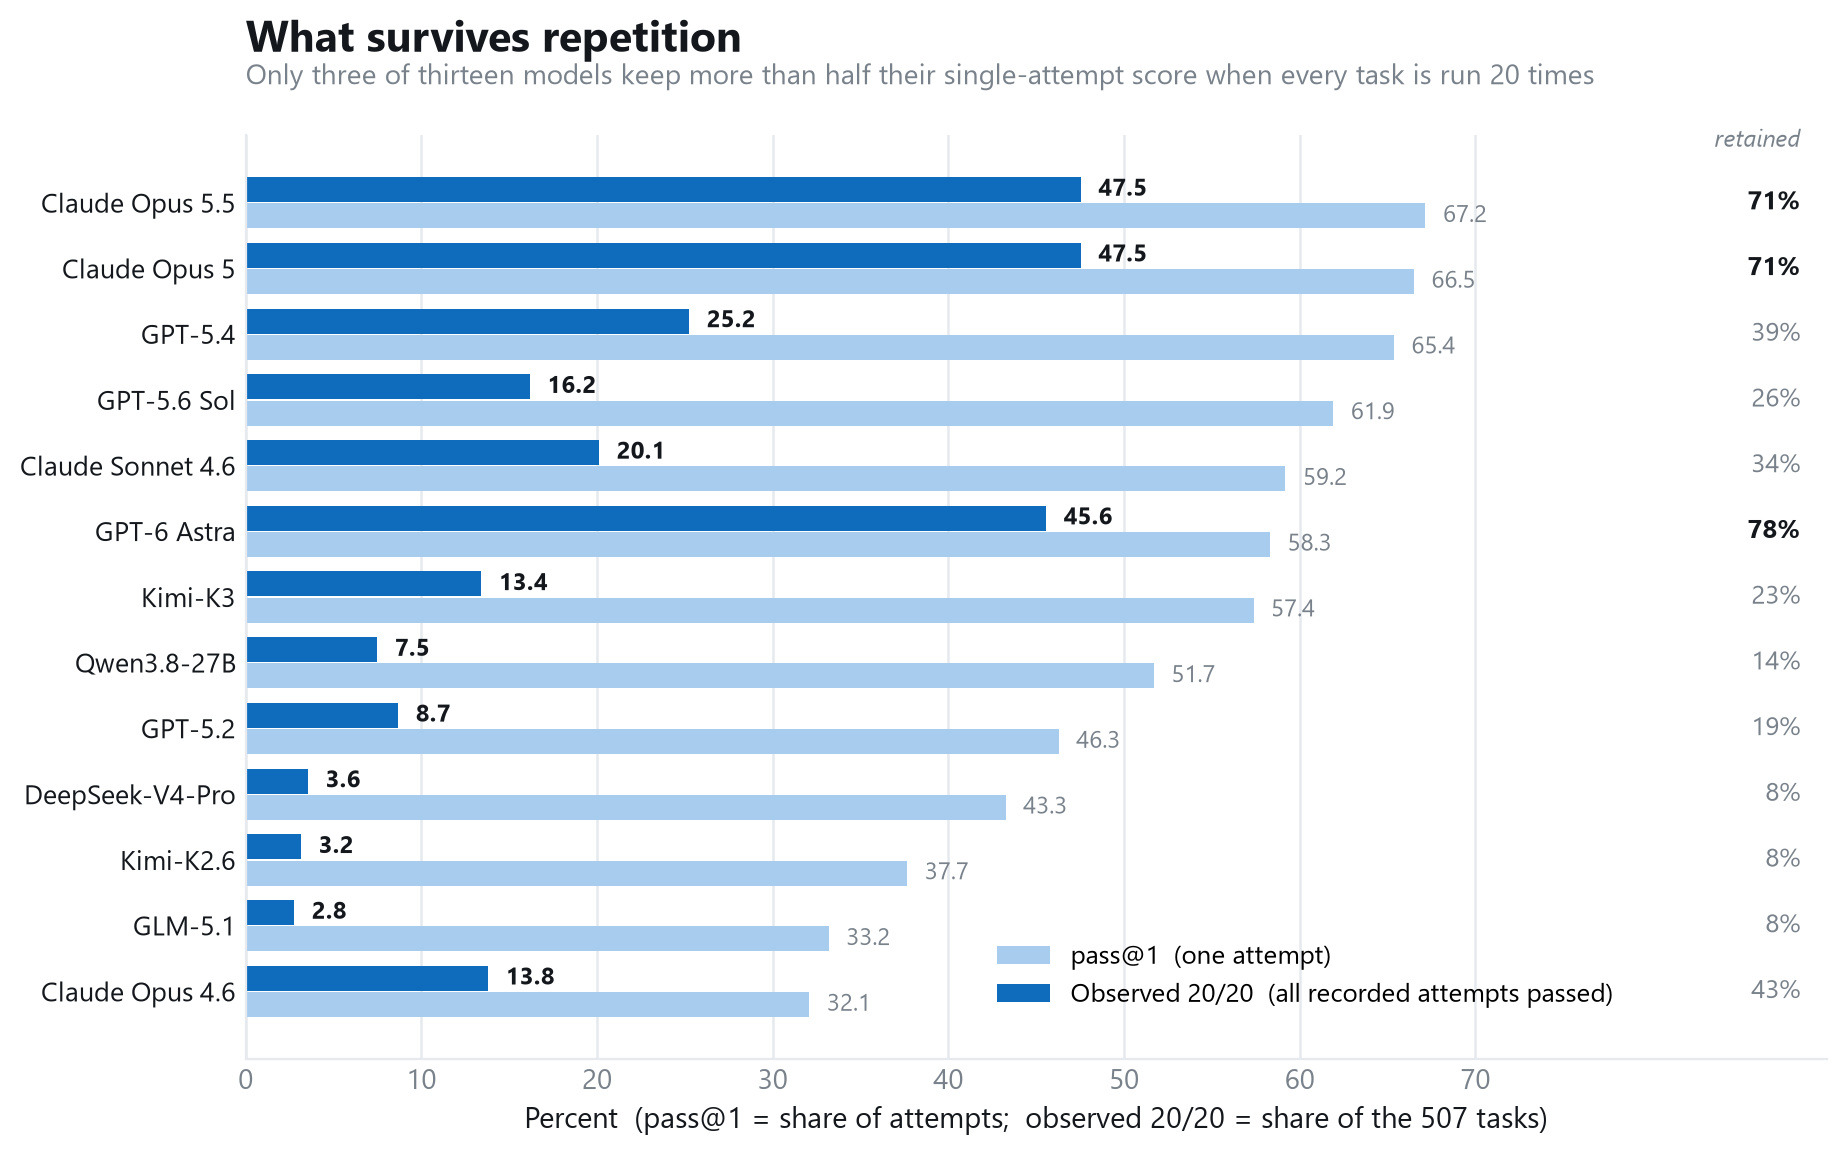
한 번 시도해 성공하는 비율과 20번 모두 성공하는 비율은 다른 모습을 보였다. Claude Opus 5.5는 한 번 시도 성공률 67.16%로 전체에서 가장 높았다. 하지만 20번 모두 성공한 업무는 241개로 Claude Opus 5와 같았다. Claude Opus 5의 한 번 시도 성공률은 66.50%였다. 평균 점수가 올라도 반복해서 성공하는 업무 수가 함께 늘지는 않았다.
이미지: huggingface.co
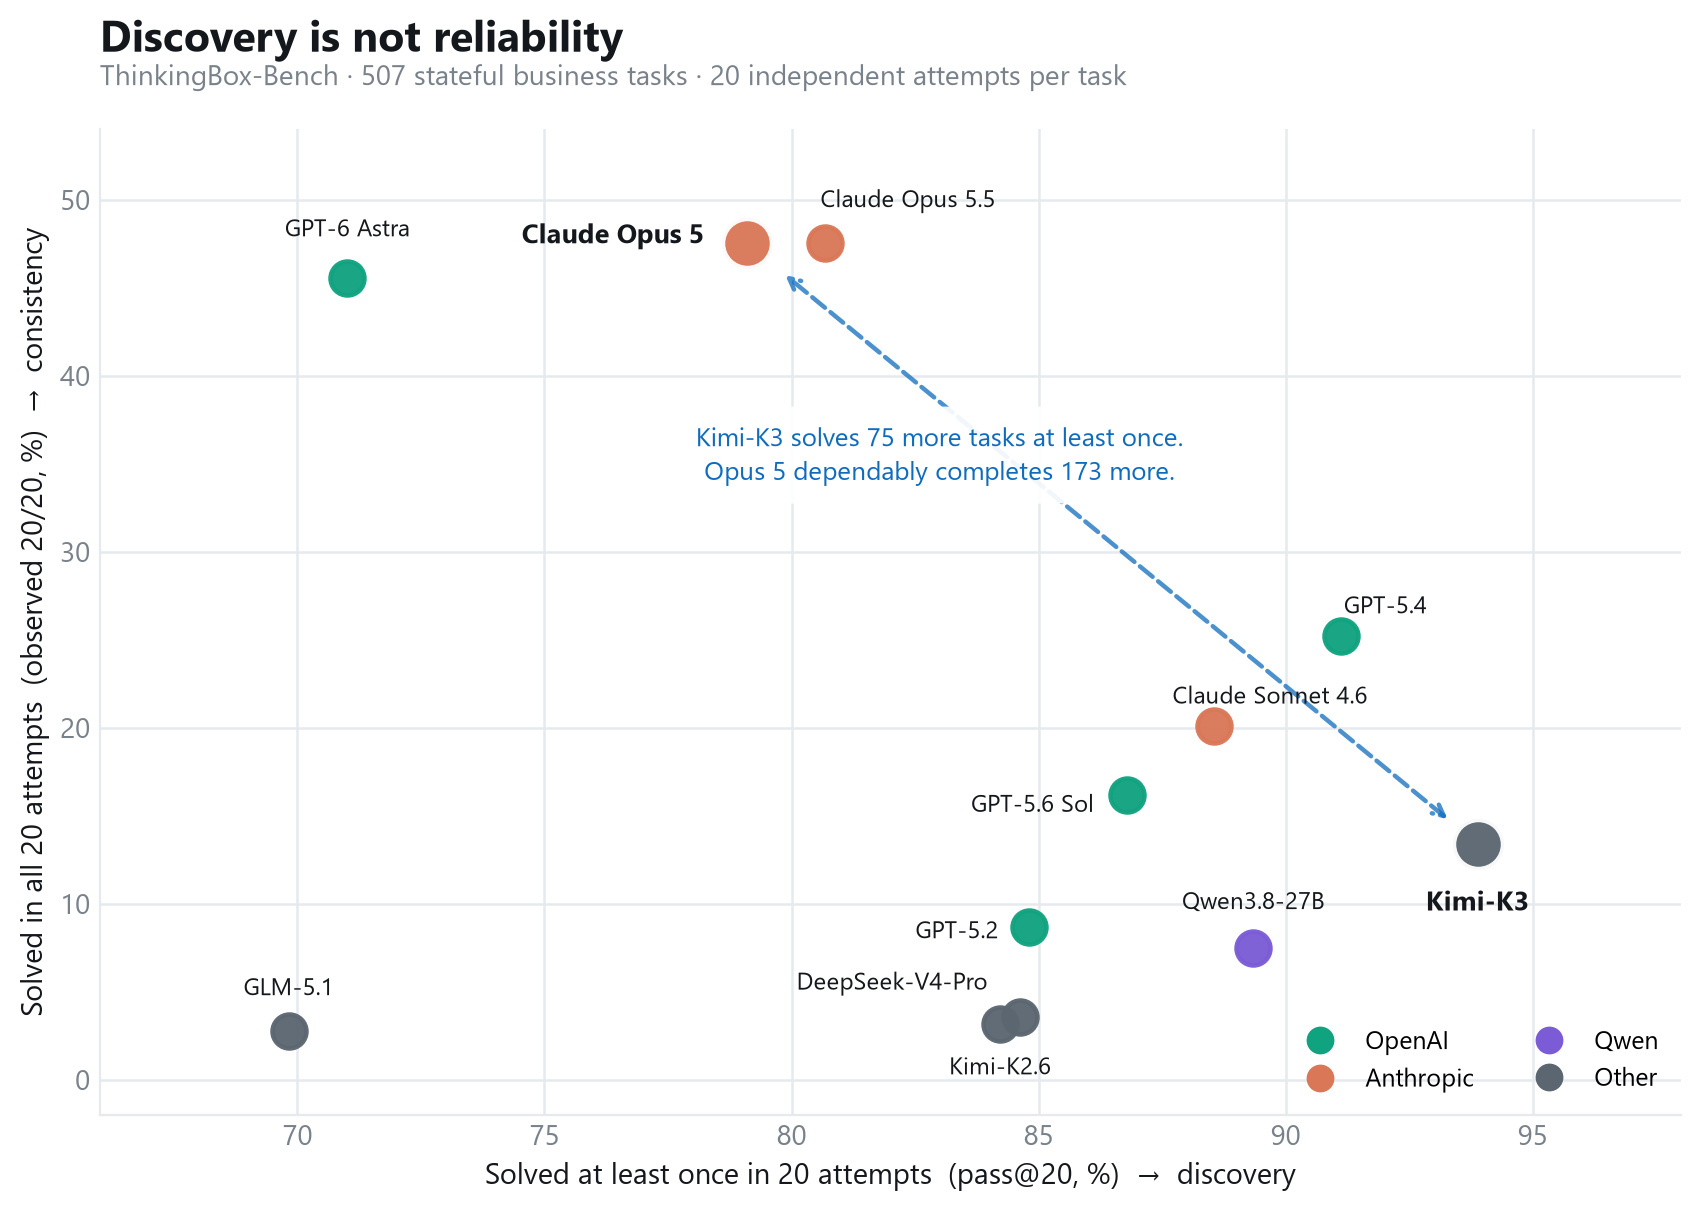
Kimi-K3는 적어도 한 번 성공한 업무가 476개로 가장 많았다. 전체 507개의 93.89%다. 반면 20번 모두 성공한 업무는 68개, 13.41%에 그쳤다. Claude Opus 5는 한 번 이상 성공한 비율이 79.09%, 20번 모두 통과한 비율이 47.53%였다. 여러 종류의 일을 해내는 능력과 같은 일을 흔들림 없이 되풀이하는 능력이 갈렸다.
성공 한 건당 비용, 어디가 가장 싼가
비용 순위도 성공을 어떻게 세느냐에 따라 뒤바뀌었다. 연구진이 사용량과 정가로 추산한 성공 한 건당 비용은 GPT-5.6 Sol이 0.127달러로 가장 낮았다. 20회 평가 비용 전체를 20번 모두 성공한 업무 수로 나누면 GPT-5.4가 6.80달러로 가장 낮았다. 같은 계산에서 GPT-6-Astra는 7.45달러, Claude Opus 5.5는 7.80달러였다.
이미지: huggingface.co
ThinkingBox 실행 도구와 데이터셋은 허깅페이스에 공개됐다. ThinkingBox-Bench는 OpenEnv와 연결해 평가할 수 있다. 연구진은 작업을 확정하기 전에 마지막 기록을 확인하고, 재시도로 복구할 수 있는 오류를 가려내 다시 시도하며, 되돌리기 어려운 변경에는 사람의 승인을 받으라고 제안했다. 다만 이런 조치가 성공률을 얼마나 올리는지는 측정하지 않았다고 밝혔다.
환불이나 상담처럼 실제 기록을 바꾸는 일에서는 완료 안내와 처리 결과가 맞아떨어지는지가 이용자에게 중요하다. 이번 평가는 그 일치 여부를 반복해서 확인할 방법을 내놨다. 남은 과제는 오류 복구와 사람의 확인 절차를 더했을 때 반복 성공률과 비용이 얼마나 달라지는지다.