사진 한 장을 고칠 수 있는 3D로, LEGO-Anything 공개
메릴랜드대와 아마존웹서비스 연구진이 사진을 보고 3D 제작 프로그램 Blender용 코드를 만드는 방식을 내놓았다. 만든 장면을 고칠 수 있다는 것이 장점이지만, AI가 자기 결과의 정확도를 판단하는 데는 한계를 보였다.
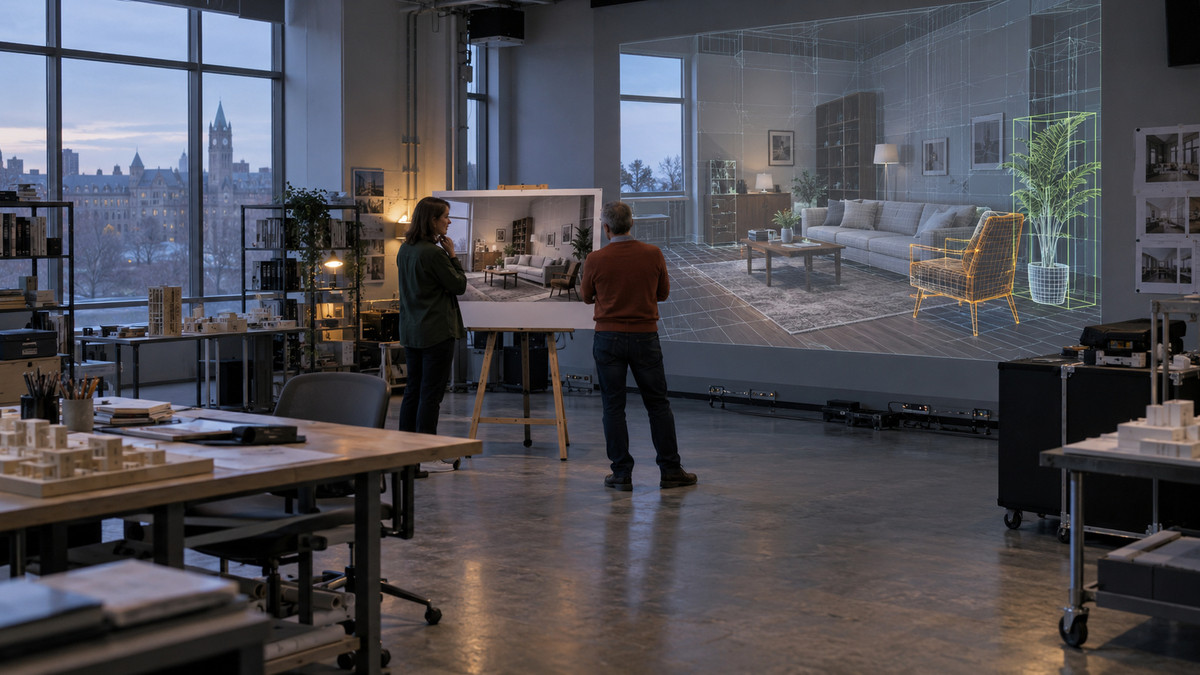
메릴랜드대와 아마존웹서비스(AWS) 연구진이 9월 28일 논문에서 ‘LEGO-Anything’을 공개했다. 사진 한 장을 보고 나중에 고칠 수 있는 3D 장면을 만들어 주는 방식이다. 장면을 만드는 AI의 성능을 재는 시험 모음 ‘LEGO-Bench’와 결과를 개선하는 ‘LEGO-Plugin’도 함께 내놓았다. 결과물이 완성된 이미지가 아니라, 고쳐서 다시 실행할 수 있는 프로그램이라는 점이 특징이다.
만든 장면을 고칠 수 있나
고칠 수 있다. LEGO-Anything은 코딩을 스스로 처리하는 AI(에이전트)가 이미지를 보고 3D 제작 프로그램 Blender용 코드를 작성하는 방식이다. AI는 코드를 실행해 장면을 이미지로 만든 뒤, 그 결과를 살펴보며 코드를 여러 번 고친다. 입력한 이미지와 비슷한 장면에 다가가는 과정에 코드 작성과 결과 검토가 함께 들어간다.
결과물에서는 물체와 카메라 등을 바꿀 수 있다. 완성된 3D 결과물만 내놓는 방식과 달리 장면의 구성 요소를 따로 수정하거나 분석에 쓸 수 있다. 장면 속 물체 찾기, 영역 구분, 거리를 나타내는 깊이 정보 추출에도 활용할 수 있다. 다만 연구진의 비교에서 이런 개별 작업의 성능은 각 작업에 특화된 모델보다 낮았다.
최고 점수 53.4%, 잘한 건가
성능 시험에서는 GPT-6 Astra가 6개 모델 가운데 종합 점수 1위를 기록했다. 실내 장면에서 53.4%, 실외 장면에서 39.6%였다. 평가는 실내외 시뮬레이터 장면 104개에서 만든 이미지 208장으로 진행했다. 실제 사진이 아니라 정답 정보를 갖춘 가상 장면의 이미지를 써서 결과를 비교했다.
종합 점수는 세 가지를 따져 매긴다. 장면 파일을 정상적으로 쓸 수 있는지, 눈에 보이는 표면의 형태가 얼마나 맞는지, 다시 만든 이미지가 원본과 얼마나 비슷한지다. 쓸 수 있는 장면 파일을 낸 경우에만 형태 점수와 비슷한 정도 점수를 평균해 반영하고, 그렇지 못한 결과물은 0점으로 처리한다. 연구진은 쓸 수 있는 장면 파일을 만든 경우에도 물체의 형상과 겉모습이 원래 장면과 맞는 정도는 차이가 컸다고 밝혔다.
연구진이 꼽은 문제는 세 가지다. 첫 장면의 품질, 고치는 과정에서 이미 잘된 부분을 망가뜨리는 현상, 그리고 AI가 자기 결과의 정확도를 잘못 판단하는 문제다. 코드를 실행하고 결과를 다시 살펴봐도 정확한 형상을 만드는 데는 어려움을 겪었다.
플러그인을 붙이면 얼마나 나아지나
LEGO-Plugin은 추가 학습 없이 장면의 처음 구성을 돕고, 측정 결과에 근거한 수정과 이전 버전 관리를 지원한다. 사무실 장면 사례 42건으로 범위를 좁힌 시험에서는 6개 모델 모두 점수가 올랐다. 가장 많이 오른 경우는 기존 점수보다 62.7% 높았다.
코드는 아직 받아 쓸 수 없다. 연구 페이지에는 논문과 예시가 올라와 있고, 코드는 ‘출시 예정’으로 적혀 있다. 앞으로 지켜볼 점은 실제 사진에서도 형태를 얼마나 정확히 복원하는지, 반복 수정이 결과를 꾸준히 개선하는지다.