구글, Gboard 단어 예측 학습을 서버로…개인정보 처리 외부 검증
구글이 휴대전화가 하던 학습 계산을 서버 안 보호 구역으로 옮기고, 데이터 처리 규칙을 외부에서 점검할 수 있게 했다. Gboard의 영어와 일본어 다음 단어 예측에 적용해 학습 속도와 정확도를 함께 높였다고 밝혔다.
구글이 10월 2일 개인정보 보호 절차를 외부에서 검증할 수 있는 새 학습 시스템을 공개했다. 휴대전화가 맡던 학습 계산을 서버 안의 보호 구역으로 옮기는 방식이다. 구글은 Gboard의 영어와 일본어 다음 단어 예측 모델에 이 시스템을 적용했다. 이전보다 학습이 빨라지고 정확도도 나아졌다고 밝혔다.
서버로 옮긴 학습, 데이터는 어떻게 지키나
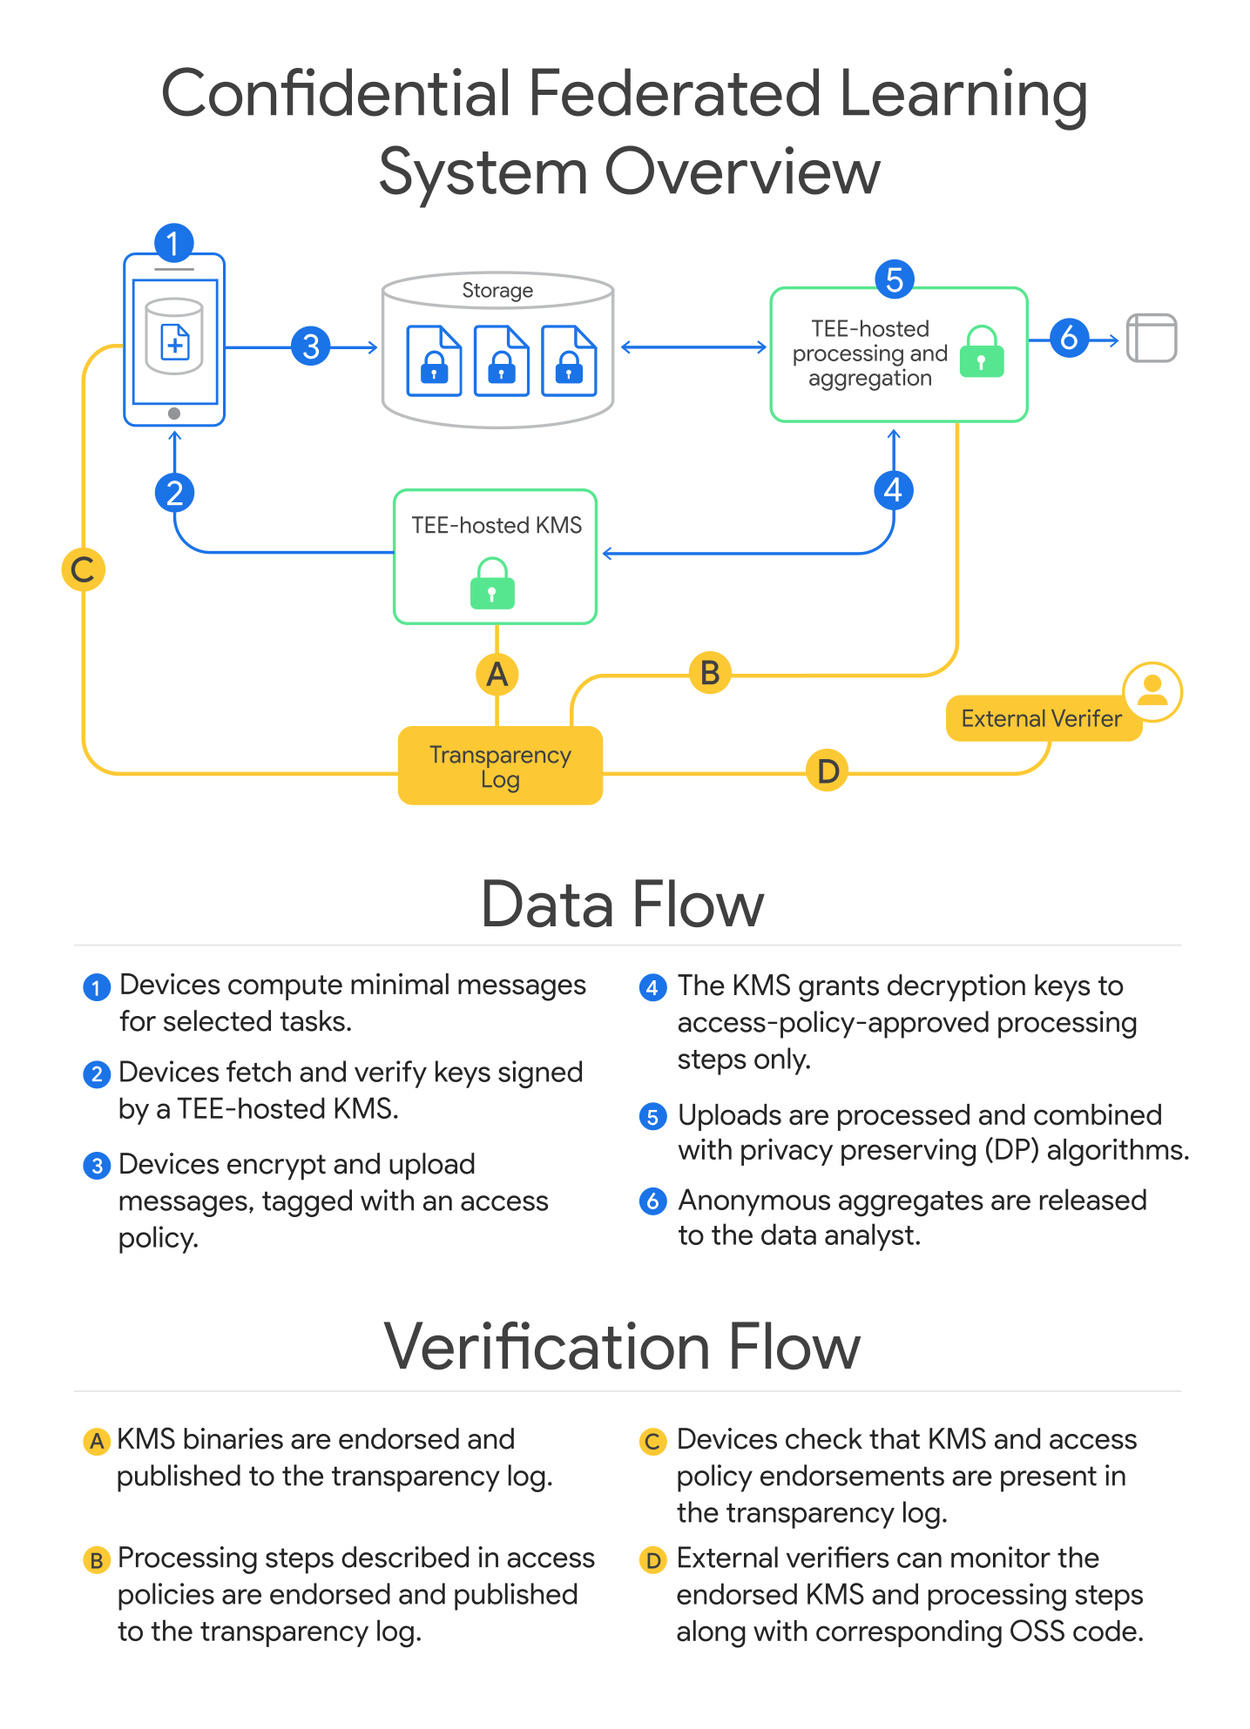
기기에서 올라온 데이터는 서버 안에 따로 떼어 둔 보호 구역에서만 처리된다. 구글은 이 공간을 신뢰 실행 환경(TEE)이라고 부른다. 기기가 보낸 학습 데이터는 암호화된 상태로 올라오고, 미리 정해 둔 프로그램이 돌아가는 이 공간에서만 풀어서 쓴다. 처리할 수 있는 기간도 업로드 뒤 일정 시간으로 묶었다. 작업을 운영하는 쪽이 볼 수 있는 결과는 측정 지표와 개인 정보가 드러나지 않게 처리한 학습값뿐이라고 구글은 설명했다.
여기서 말하는 학습은 여러 기기에 흩어진 데이터로 모델을 함께 학습시키는 방식이다. 흔히 연합학습이라고 부른다. 구글은 2017년 이 방식을 도입한 뒤 Gboard의 다음 단어 예측과 문장 작성 보조, 구글 메시지의 답장 추천 등에 써 왔다. 새 시스템은 데이터 사용을 통제하면서도 기기의 계산 능력에 덜 얽매이도록 설계됐다.
바깥에서 들여다볼 수 있게 한 장치도 있다. 데이터에 접근할 수 있는 작업의 규칙을 공개 기록에 남긴다. 참여하는 기기는 자기가 올린 데이터에 어떤 서버 작업이 접근할 수 있는지 알 수 있다. 외부 감사자는 ‘Rekor’라는 공개 기록에서 그 작업들을 추적할 수 있다. 구글은 암호 키 관리와 데이터 처리에 쓰는 실행 파일을 공개된 소스 코드로 다시 만들어 확인할 수 있게 했다고 밝혔다.
예전에는 무엇을 믿어야 했나
기존 시스템에서는 서버가 데이터를 기록하거나 들여다보지 않는지 바깥에서 확인할 방법이 없었다고 구글은 설명했다. 개인의 정보가 학습 결과에 드러나지 않도록 무작위 값을 섞는 절차도 서버 운영자가 제대로 했으리라 믿는 수밖에 없었다. 새 시스템은 공개된 접근 규칙에 학습 프로그램을 직접 적어 둔다. 개인정보 보호와 관련된 처리 절차를 외부에서 점검할 수 있게 한 것이다.
이미지: research.google
다만 검증에는 조건이 붙는다. 구글은 보호 구역의 보안 수준이 지금 세대 하드웨어의 한계를 따른다고 설명했다. 외부에 공개하지 않는 모델 구조처럼 일부 정보는 실행 중에 따로 불러올 수 있다. 대신 개인정보 보호와 관련된 처리 과정은 모두 검증 대상 프로그램 안에 고정돼 있어야 한다. 구글은 실행 중 흘러나오는 간접적인 단서로 정보를 알아내는 공격을 막는 연구와 앞으로의 하드웨어 개선이 더 두꺼운 보호로 이어질 것으로 기대했다.
Gboard 쓰는 사람에게 달라지는 점
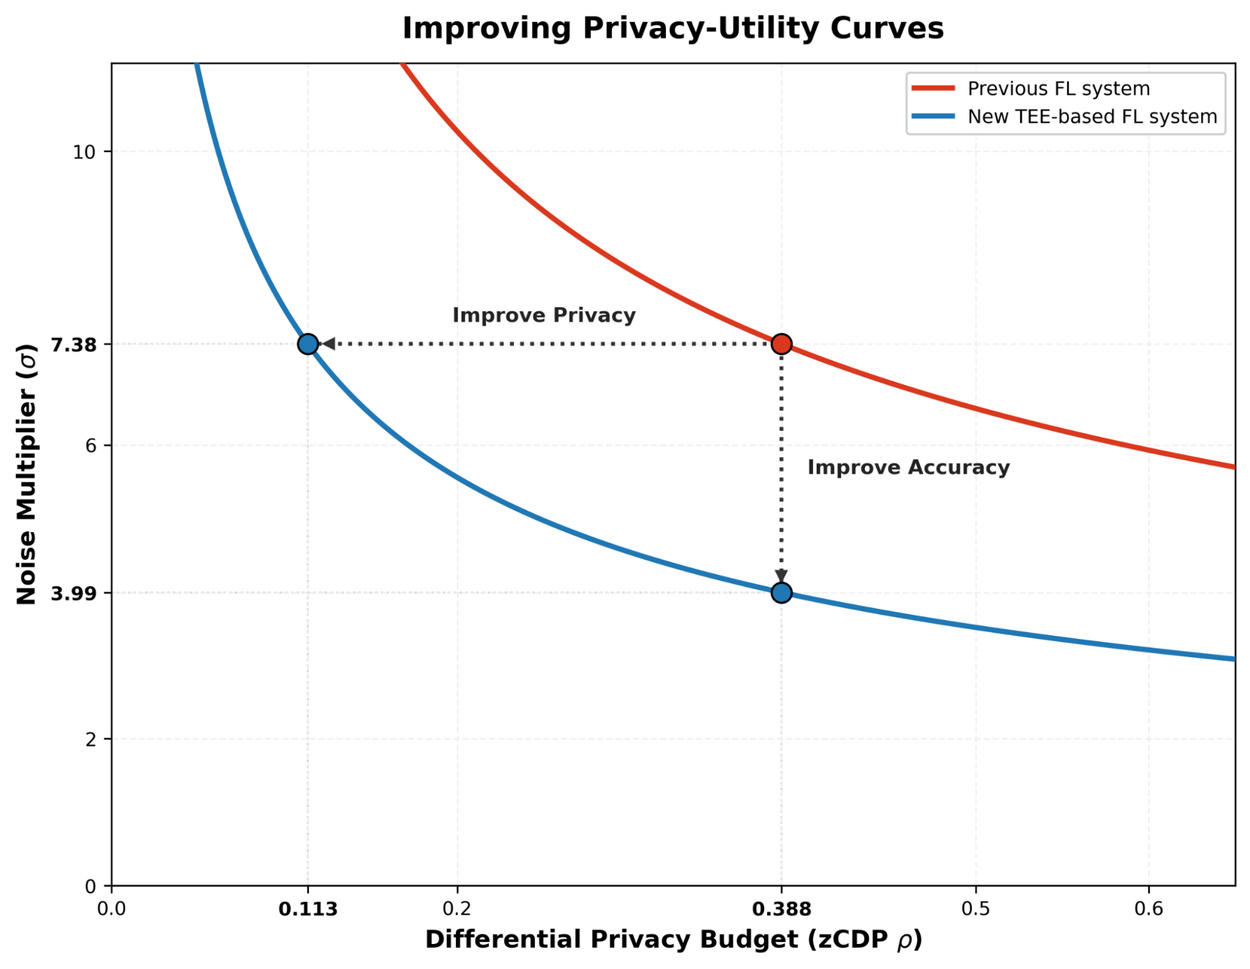
구글이 내세운 이용자 쪽 변화는 두 가지다. 영어와 일본어 다음 단어 예측의 정확도가 올라가고 개인정보 보호가 강해진다는 것이다. 개발 과정에서는 학습에 걸리는 시간을 줄였다. 구글에 따르면 전에는 모델 하나를 학습하는 데 한두 달이 걸리기도 했다. 새 방식은 기기에서 올라온 데이터를 먼저 모은 뒤 여러 서버가 계산을 나눠 처리한다. 기기를 쓸 수 있는 시간과 기기 성능에 따른 제약이 줄어든 셈이다.
이미지: research.google
구글은 기기의 계산 부담을 덜어 더 큰 모델을 학습할 길도 열렸다고 설명했다. 앞으로 볼 지점은 지금 하드웨어의 한계를 메우는 보호 기술과 검증 범위가 얼마나 넓어지는지다. 구글은 길게 보면 개인정보 보호 알고리즘과 시스템 구성 요소의 구현까지 정확성을 완전히 증명하는 방향으로 갈 것이라고 내다봤다. 일상적인 입력 기능을 고치면서 서버의 데이터 처리 방식까지 검증 대상으로 끌어들였다는 점이 이번 발표의 핵심이다.