AI가 실패한 업무를 연습 문제로, 서비스나우 AutoSynthData
AI가 실패한 업무를 분석해 추가 학습용 과제를 만드는 방식이다. 그 과제를 실제로 풀 수 있는지, 틀린 답이 성공으로 채점되지는 않는지도 검사한다.
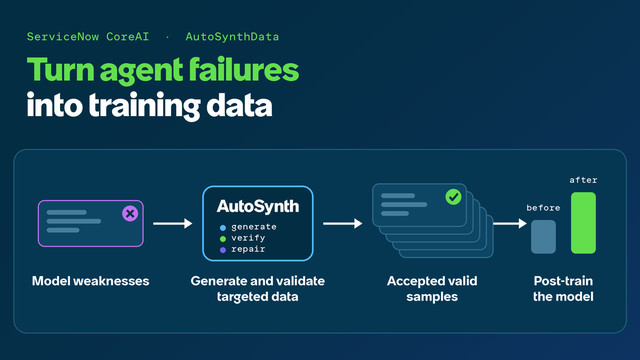
서비스나우 CoreAI가 AutoSynthData를 소개했다. 기업 업무를 처리하는 AI의 약점을 찾아 학습 데이터를 만드는 방식이다. 대상 모델이 실패한 과제와 더 강한 모델이 성공한 사례를 비교해, 부족한 능력을 연습할 새 과제를 만든다. 서비스나우는 이렇게 만든 과제를 대상 환경에서 실행해 검증한 뒤 추가 학습에 쓴다고 설명했다.
기업에서 스스로 일을 처리하는 AI(에이전트)는 그 회사의 도구와 규칙에 맞게 움직여야 한다. 서비스나우는 전반적인 능력이 좋은 모델도 특정 업무 절차나 도구 조합에서는 어려움을 겪을 수 있다고 설명했다. AutoSynthData는 이런 실패를 출발점으로 삼는다. 같은 능력을 여러 상황에서 익히도록 학습 과제를 짠다.
실패를 어떻게 연습 문제로 바꾸나
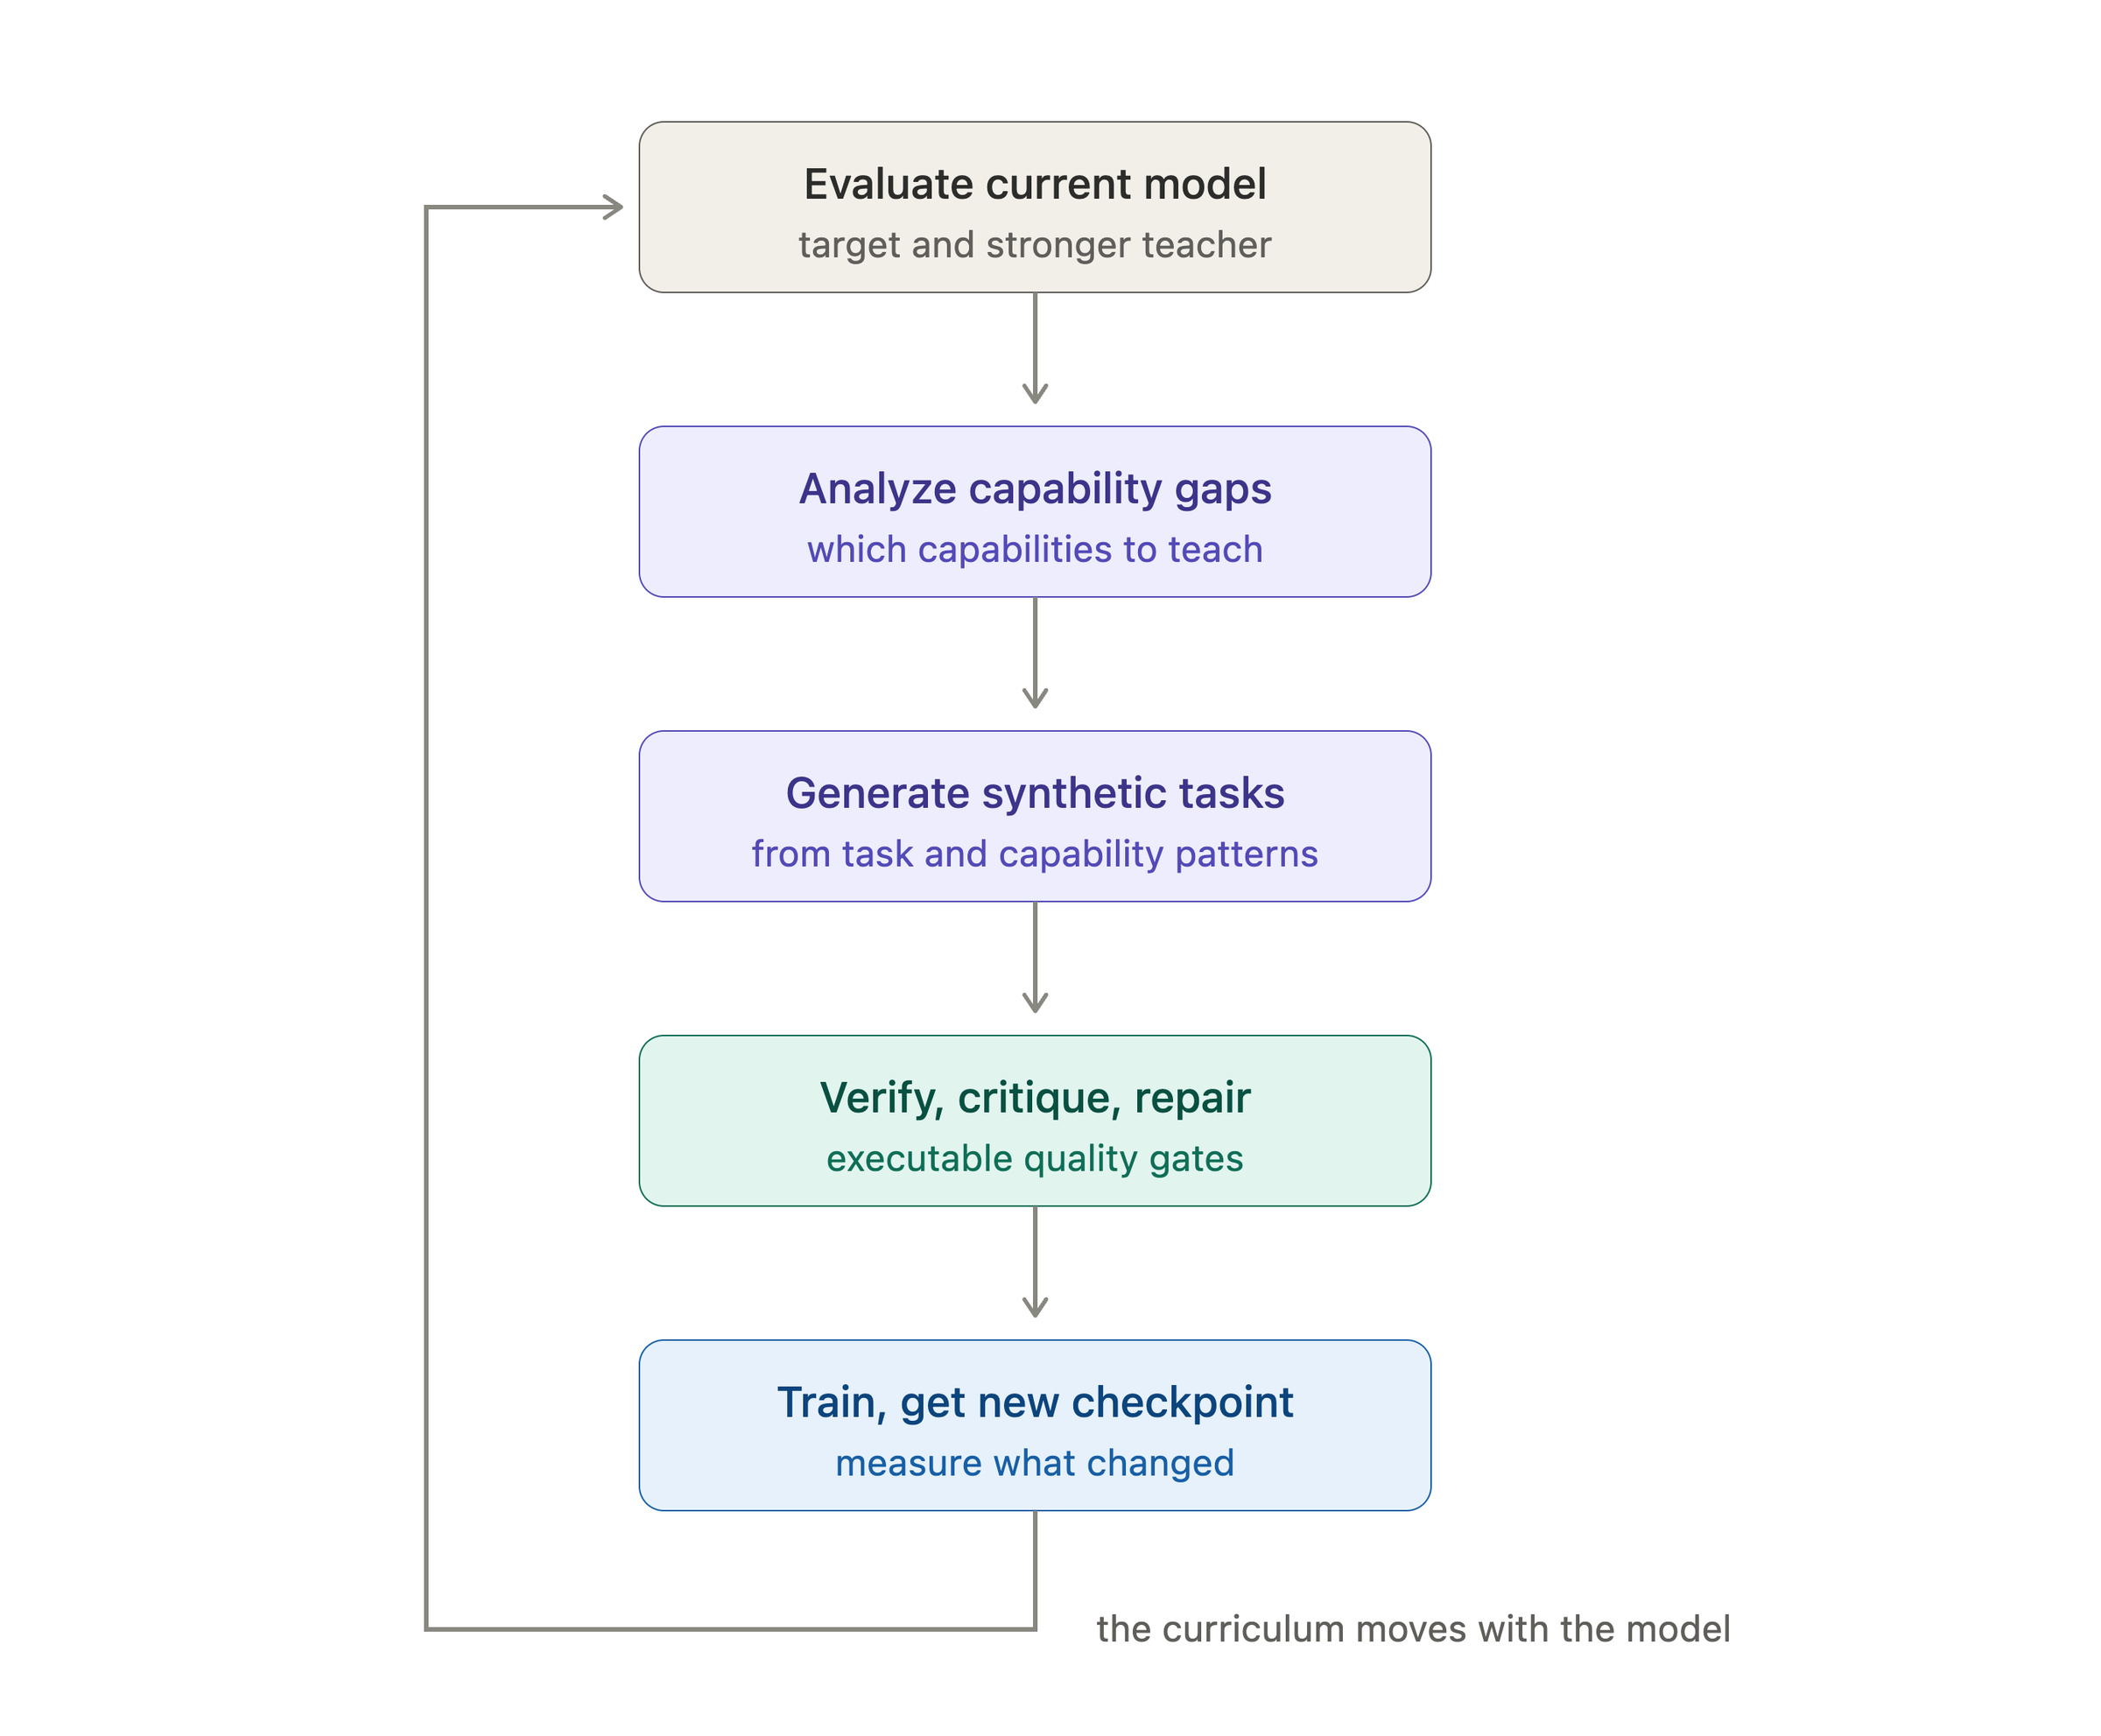
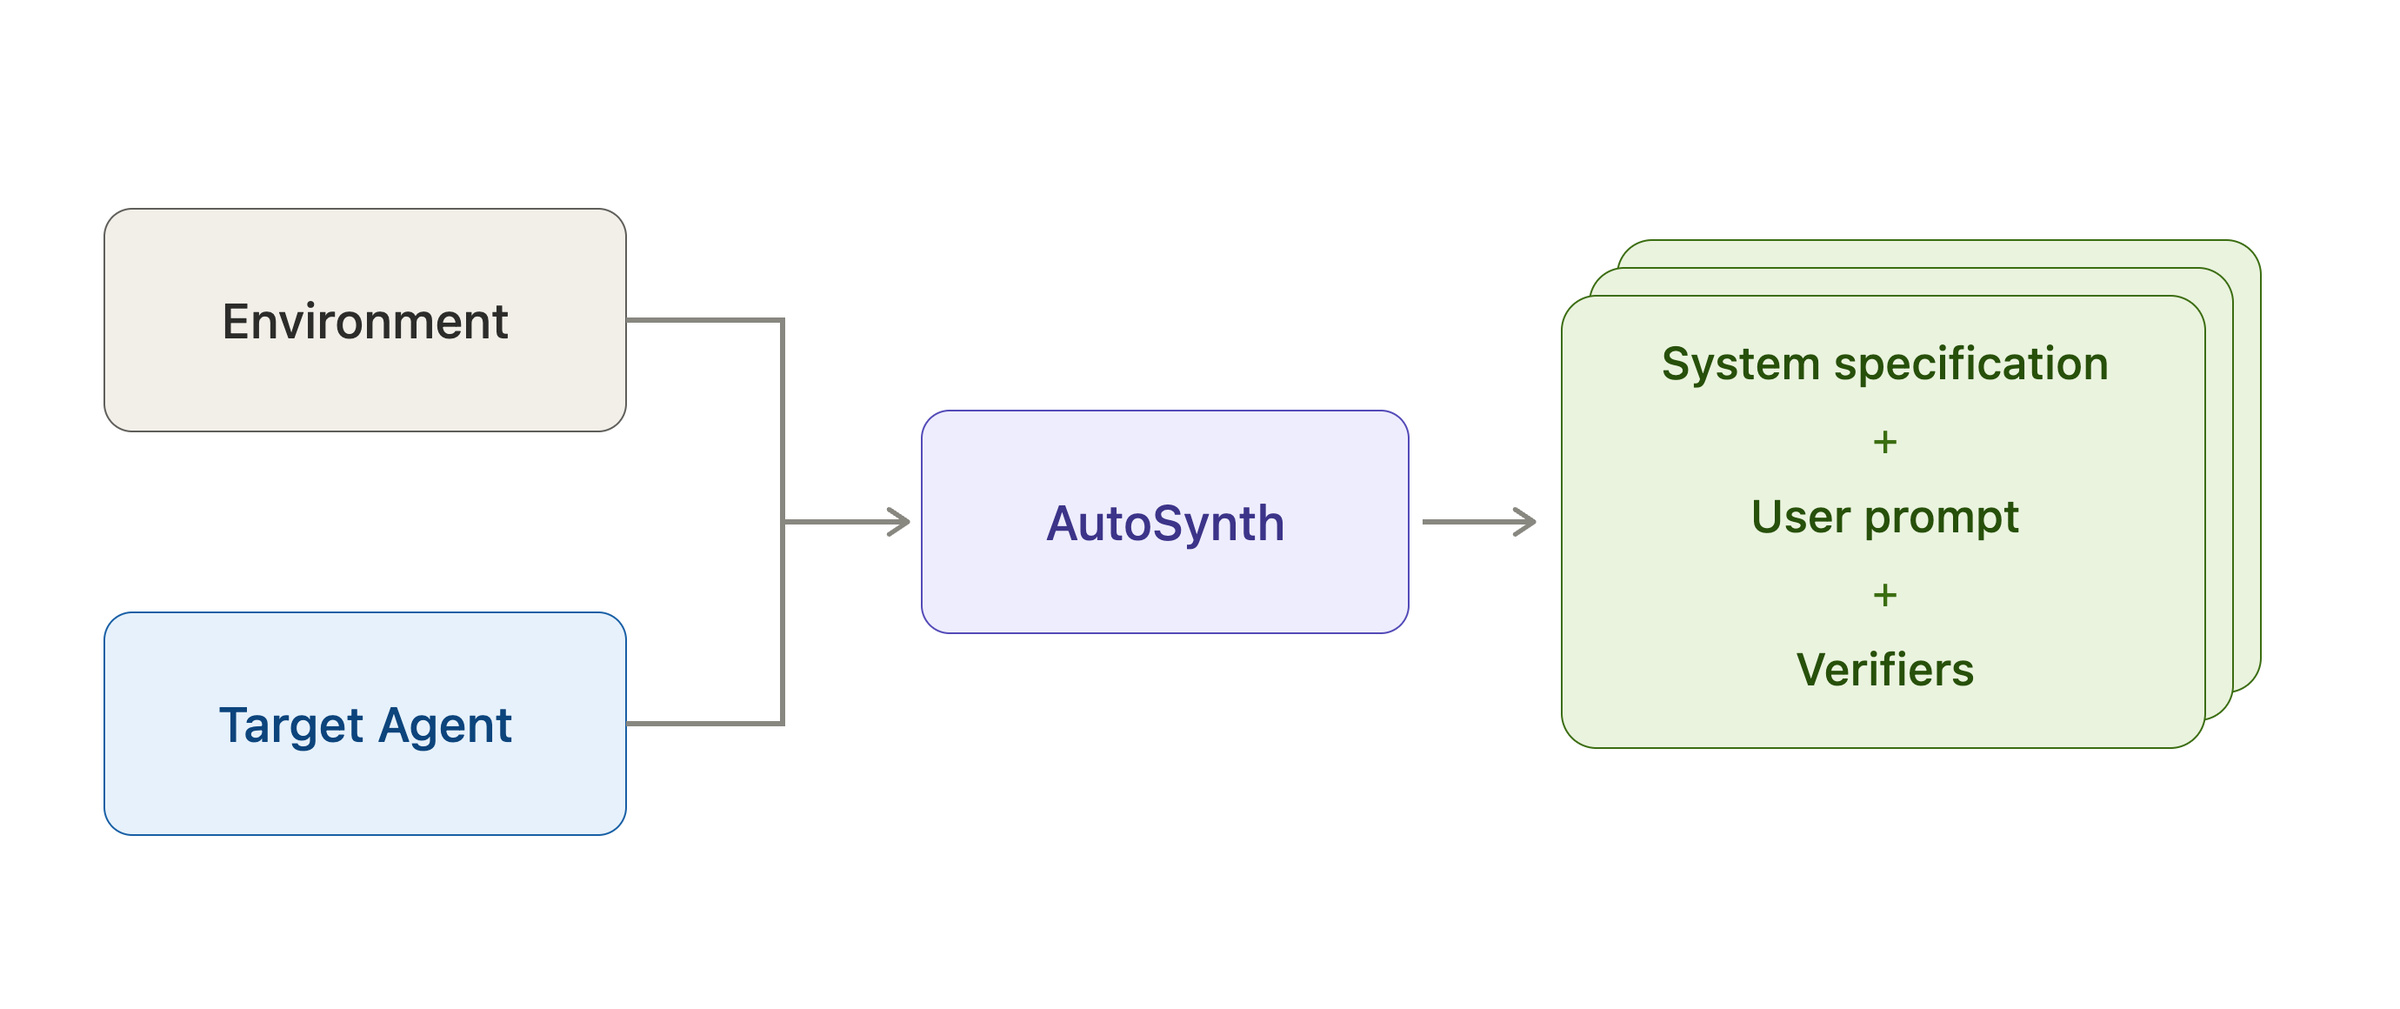
먼저 같은 환경에서 대상 모델과 교사 역할을 맡은 더 강한 모델을 함께 평가한다. 어떤 능력이 필요한지, 어느 단계에서 실패했는지, 성공한 결과는 어떤 조건을 갖췄는지 분석한다. 이를 정리한 능력 명세를 과제 생성기에 넘긴다. 평가에 쓴 원래 요청문과 등장 대상, 수행 과정, 채점 세부 사항은 넘기지 않는다고 회사는 밝혔다.
이미지: huggingface.co
생성기는 이 명세를 바탕으로 등장 대상과 시작 상태, 도구 조합, 요청 표현과 난도를 바꾼다. 교사 모델은 새 과제를 푸는 모범 과정을 보여준다. 학습 과제에는 AI가 지켜야 할 규칙과 사용자의 요청, 성공 여부를 가릴 검사 장치가 함께 들어간다. 쓸 수 없는 도구에 기대거나 규칙상 금지된 행동을 요구하는 과제는 걸러낸다.
데이터는 두 단계로 만든다. 핵심 과제를 먼저 검증하고, 이를 변형해 수를 늘린다. 변형 과제도 저마다 요청과 시작 상태, 모범 수행 과정, 검사 장치를 갖추고 같은 검증을 거쳐야 한다. 변형본을 다시 변형의 출발점으로 쓰지는 않는다. 서비스나우는 검증된 핵심 과제를 기준으로 삼아, 변형이 거듭되며 과제가 어긋나는 일을 줄이려는 설계라고 설명했다.
틀린 답도 통과시키지는 않나
과제 난도는 대상 모델에는 어렵고 교사 모델은 풀 수 있는 수준을 겨냥한다. 이번 구성에서는 세 번 시도해 대상 모델이 한 번 이하로 성공하고, 더 강한 모델이 두 번 이상 성공하는 과제를 먼저 쓴다. 이어 모범 수행 과정을 대상 환경에서 실행해 성공으로 판정되는지 확인한다. 예상 결과의 일부를 바꾼 오답이 채점을 통과하지는 않는지도 점검한다.
이미지: huggingface.co
검증에 실패한 과제는 원인을 진단해 정해진 재시도 한도 안에서 고친다. 고친 뒤에는 관련 검사를 다시 받아야 한다. 과제 묶음 전체를 따로 검토하기도 한다. 비슷한 사례가 반복되는지, 특정 능력을 연습할 과제가 빠졌는지 살펴 다음 생성 방향을 조정한다. 추가 학습을 마친 모델을 다시 평가한 결과도 이후 과제를 만드는 데 쓸 수 있다.
서비스나우는 EnterpriseOps Gym에서 교사의 모범 수행을 따라 배우는 추가 학습을 중심으로 실험했다고 밝혔다. 성공 여부에 따라 보상을 주며 배우는 강화학습에도 이 방식을 시험할 계획이다. 업무용 AI를 들이는 기업에는 자사 환경에서 되풀이되는 실패를 연습 문제로 바꾼다는 점이 눈여겨볼 대목이다. 남은 질문은 이런 과제 생성과 검증이 실제 업무 성공률을 얼마나 끌어올리느냐다.