Olmo-core 3 공개…대형 AI 학습 처리량 2.7배
개발팀이 이전 학습 시스템과 비교한 예비 시험 결과를 내놓았다. 모델 일부만 골라 쓰는 MoE 구조를 지원하고, 연구자가 직접 고쳐 쓸 수 있다.
Olmo 개발팀이 10월 1일(현지시간) 대형 AI 모델을 학습시키는 공개 소프트웨어 Olmo-core 3를 내놓았다. 필요한 부분만 골라 계산하는 MoE 구조에 맞춰 학습 시스템을 새로 설계했다. 개발팀은 모델 크기를 1조 규모 이상으로 키우면서도 계산 효율을 유지하는 것이 목표라고 밝혔다.
일부만 계산하는 구조, 왜 어려운가
MoE는 역할을 나눠 맡는 여러 ‘전문가’ 가운데 일부만 골라 입력을 처리하는 구조다. 모델 전체를 매번 계산하지 않아도 된다. 그래도 학습할 때는 전체 모델을 GPU 메모리에 나눠 담고 갱신해야 한다. 입력을 알맞은 전문가에게 보내는 통신 작업도 필요하다. 개발팀은 모델이 커질수록 이런 부담이 계산량을 줄인 이점을 깎아낼 수 있다고 설명했다.
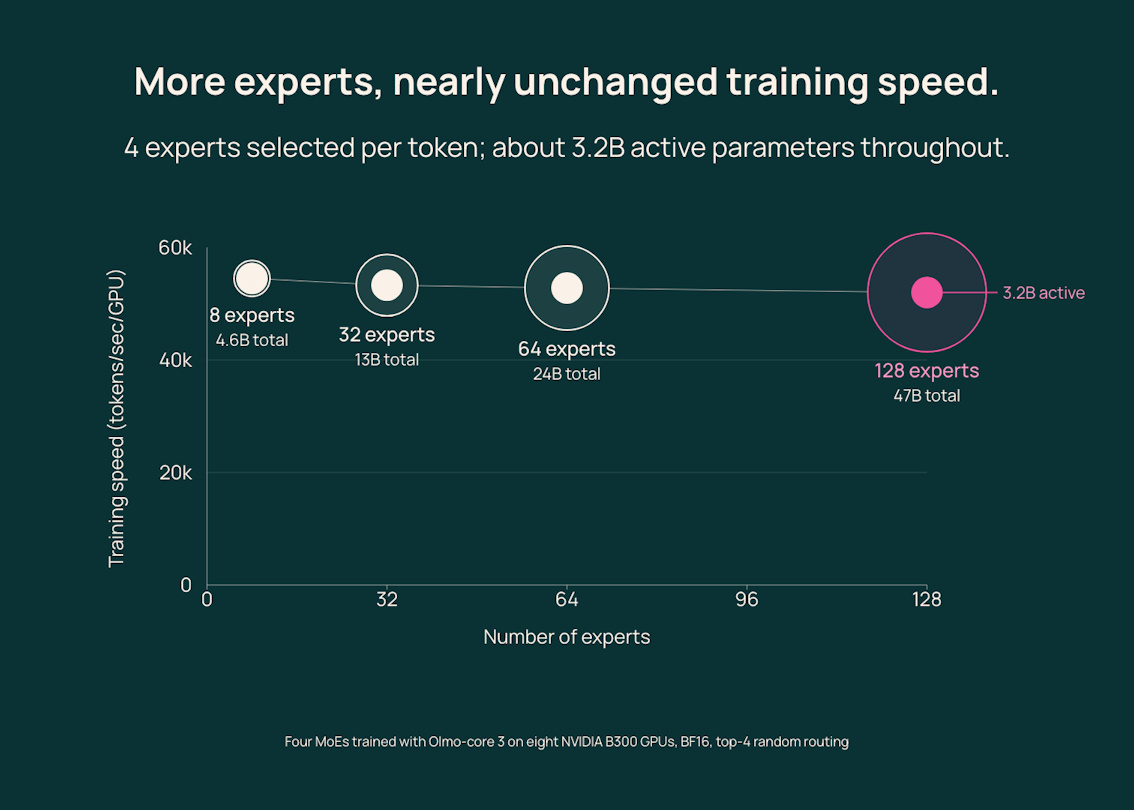
개발팀의 시험에서는 모델 전체 크기를 약 10배로 키워도 학습 처리량이 5% 미만만 줄었다. 전문가 수를 8개에서 128개로 늘리고, 글자 조각(토큰) 하나마다 고르는 전문가는 4개로 유지한 결과다. 모델 전체 크기는 46억 규모에서 470억 규모로 커졌지만, 글자 조각 하나를 처리할 때 실제로 쓰는 부분은 약 32억 규모로 거의 같았다.
이전보다 무엇이 빨라졌나
Olmo-core 3는 전문가를 GPU에 그대로 둔 채 필요한 데이터를 보내도록 학습 방식을 바꿨다. 이전에는 작은 단위로 나눈 학습 데이터를 처리할 때마다 모델 데이터를 모았다가 다시 나누는 작업을 반복했다. 이전 모델인 OlmoE는 전문가 64개를 쓰는 MoE였고, Olmo 3는 입력마다 모델 대부분을 쓰는 구조였다. 이번 개편은 더 큰 MoE 모델을 학습시키는 데 초점을 맞췄다.
이미지: huggingface.co
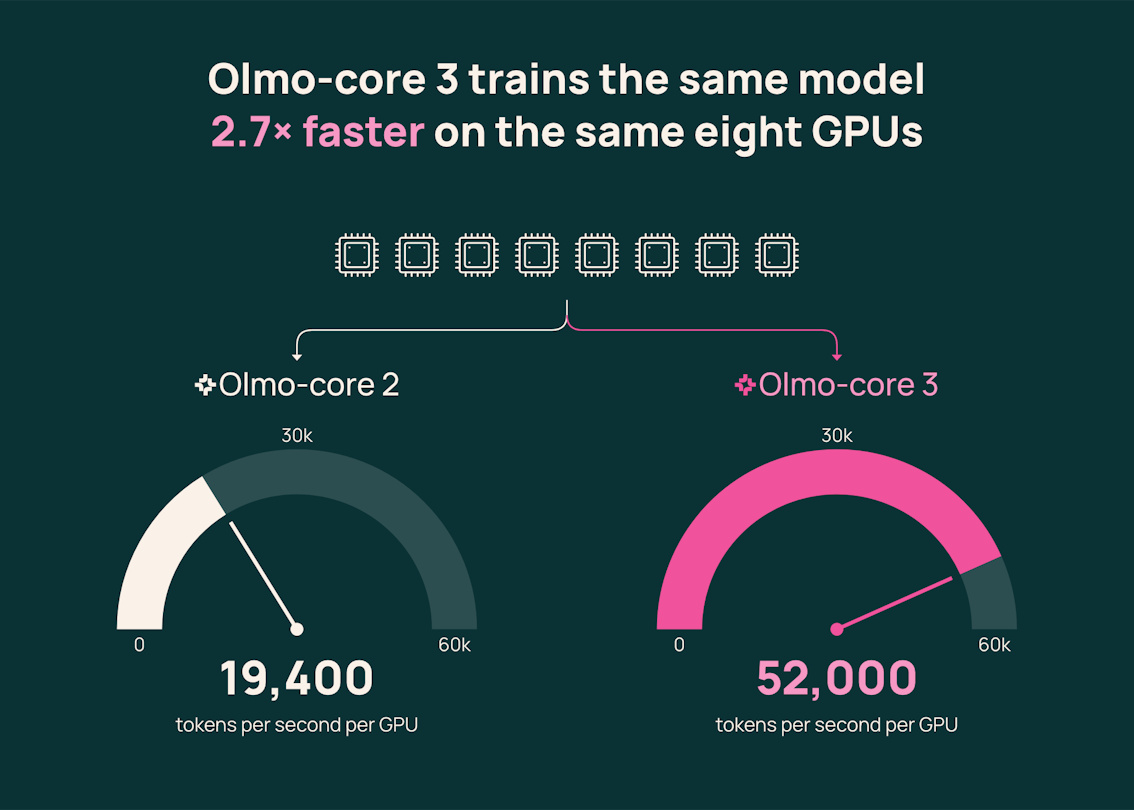
엔비디아 B300 GPU 8개를 쓴 예비 시험에서는 개발팀의 이전 시스템보다 처리량이 약 2.7배 높았다. 470억 규모 모델을 학습할 때 GPU 한 개가 1초에 처리한 글자 조각 단위가 1만9400개에서 5만2000개로 늘었다. 시스템은 전문가와 모델의 층을 여러 GPU에 나누고, 작은 계산들을 묶어 한 번에 실행하도록 구성했다.
숫자를 더 적은 비트로 표현하는 MXFP8도 쓸 수 있다. B300 GPU 4개에서 전문가별 작업량을 균등하게 맞춰 시험한 결과, 기존 BF16 방식보다 학습 처리량이 약 21% 높았다. 가장 많이 쓸 때의 메모리도 103GiB에서 95GiB로 줄었다. 개발팀은 효과가 큰 부분에만 MXFP8을 적용했으며, 숫자 형식을 바꾸는 데 드는 비용까지 함께 따져야 한다고 설명했다.
연구자가 직접 쓸 수 있나
개발팀은 연구자와 개발자가 Olmo-core 3로 자체 MoE 모델을 학습시키고, 쓰는 하드웨어에 맞게 고칠 수 있다고 밝혔다. 큰 규모 시험에는 B300 GPU 512개와 1조2000억 규모 모델을 썼다. 이 시험은 입력을 전문가에게 무작위로 나눠 보내 시스템 성능만 측정했다. 2조3800억 규모에서도 짧게 돌려 보는 시험을 따로 진행했다.
이미지: huggingface.co
개발팀은 차세대 Olmo에 MoE 구조를 쓰겠다고 밝혔다. 자체 데이터셋 가운데 가장 큰 것을 쓰고, 한 번에 읽을 수 있는 분량도 가장 길게 잡는 것이 목표다. 앞으로 볼 점은 이번 시험에서 나온 속도가 오래 걸리는 실제 학습에서도 이어지는지, 이렇게 만든 모델이 실제 사용에서 어떤 성능을 내는지다.