구글, 이미지 AI에 작은 제어망 붙여 지시 이행 높였다
기존 이미지 생성 모델에 작은 제어망을 덧붙여 지시를 얼마나 반영할지 조절하는 기술이다. 구글은 모델 내부를 손대기 어려운 환경에서도 그림 품질과 지시 이행을 함께 높였다고 밝혔다.
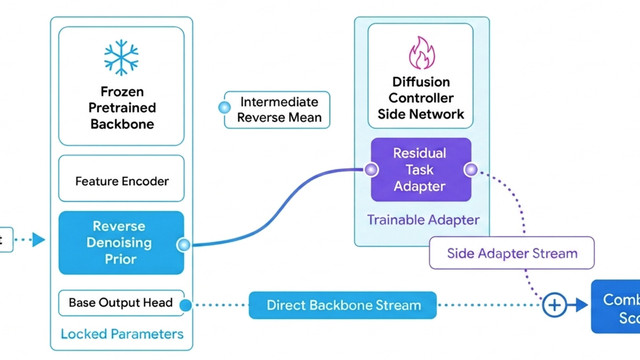
구글 리서치가 9월 29일(현지시간) Diffusion Controller를 공개했다. 이미지 생성 과정을 조절하는 기술이다. 기존 모델에 작은 제어망을 덧붙여 사용자가 원하는 요소를 그림에 반영하는 방식이다. 구글은 모델 내부를 손대기 어려운 환경에서도 기본 모델의 안정성을 지키면서 지시를 더 잘 따르게 했다고 밝혔다.
선글라스 쓴 도마뱀이 왜 어려울까
이미지 AI는 요청한 대상을 그려도 세부 조건을 빠뜨리곤 한다. 구글은 선글라스를 쓴 도마뱀을 예로 들었다. 도마뱀은 사실적으로 그리면서 선글라스는 빼먹거나, 선글라스를 억지로 넣다가 얼굴을 일그러뜨린다는 것이다. 이번 기술은 요청한 요소와 자연스러운 그림을 함께 지키는 것을 겨냥한다.
기존에는 그림을 만드는 도중 글로 쓴 지시의 영향력을 조절하거나, 모델을 추가로 학습시키는 방법을 썼다. 구글은 두 방법이 따로 놀아 품질과 사용자 취향 사이에서 균형을 잡기 어려웠다고 설명했다. Diffusion Controller는 무작위 잡음에서 그림을 완성해 가는 전 과정을 하나의 제어 문제로 다룬다. 서로 다른 조절 방법을 같은 수학적 틀에서 비교해 보려는 접근이다.
기본 모델은 그대로, 방향만 고친다
덧붙인 제어망은 그림이 만들어지는 중간 상태를 보고 생성 방향을 조금씩 수정한다. 기본 모델은 건드리지 않은 채 원하는 화풍이나 내용에 가까워지도록 개입하는 구조다. 기본 동작에서 너무 멀어지면 제동도 건다. 구글은 이 장치가 요청한 물건을 넣다가 대상의 형태나 질감을 망가뜨리는 문제를 줄인다고 설명했다.
이미지: research.google
사용자는 그림을 만들 때 설정값 하나로 제어 강도를 올리거나 내릴 수 있다. 글로 쓴 지시를 얼마나 강하게 반영할지 정하는 기능이다. 구글은 이렇게 해도 기본 이미지의 안정성을 지킬 수 있다고 주장했다. 모델 내부를 직접 바꾸기 어려운 개발자라면 별도 제어망만으로 결과를 맞춤 조정할 수 있다는 설명이다.
성능 시험에서는 어땠나
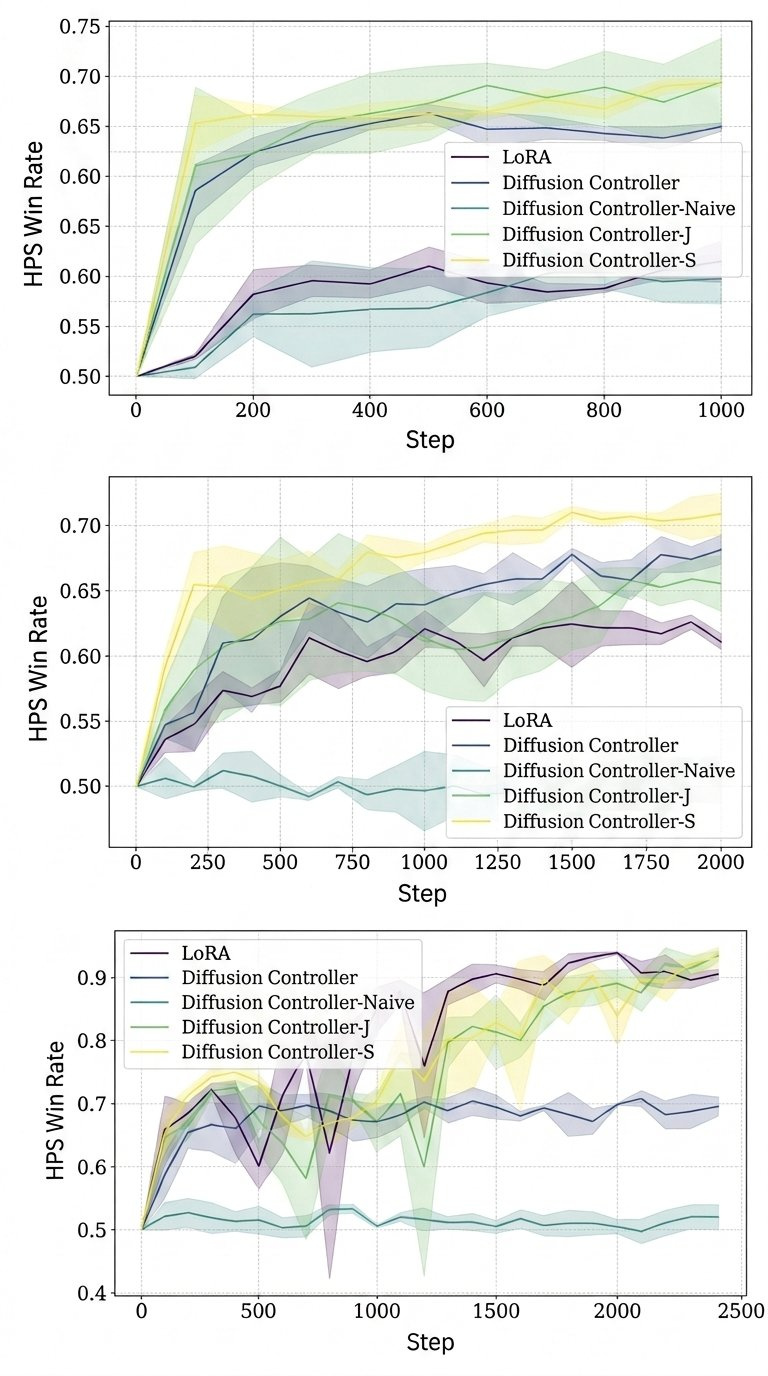
구글은 Stable Diffusion v1.4를 바탕으로 세 가지 추가 학습 방식에서 성능을 시험했다. 평가에는 만들어진 이미지가 사람의 취향에 얼마나 맞는지 재는 HPS-v2 점수를 썼다. 내부 접근을 제한한 제어망은 두 가지 학습 방식에서 LoRA보다 높은 승률을 기록했다고 구글은 밝혔다. LoRA는 모델 일부만 추가로 학습시키는 방법이다. 구글은 제어망이 LoRA보다 적은 내부 계층에 관여하고도 이 결과를 냈다고 설명했다.
이미지: research.google
모델 내부를 자유롭게 고친 버전은 기본 모델을 상대로 90%의 승률을 거뒀다고 구글은 밝혔다. 사람이 직접 비교한 평가에서도 여러 조건을 한꺼번에 요구하는 복잡한 지시에서 이미지 품질과 지시 일치도가 가장 좋았다고 설명했다.
구글은 후속 연구 방향으로 개인 맞춤 기능, 유해 이미지 생성을 줄이는 안전장치, 동영상 모델 제어를 제시했다. 결국 지켜볼 대목은 이미지 시험에서 나온 효과가 이런 용도로도 이어지느냐다.