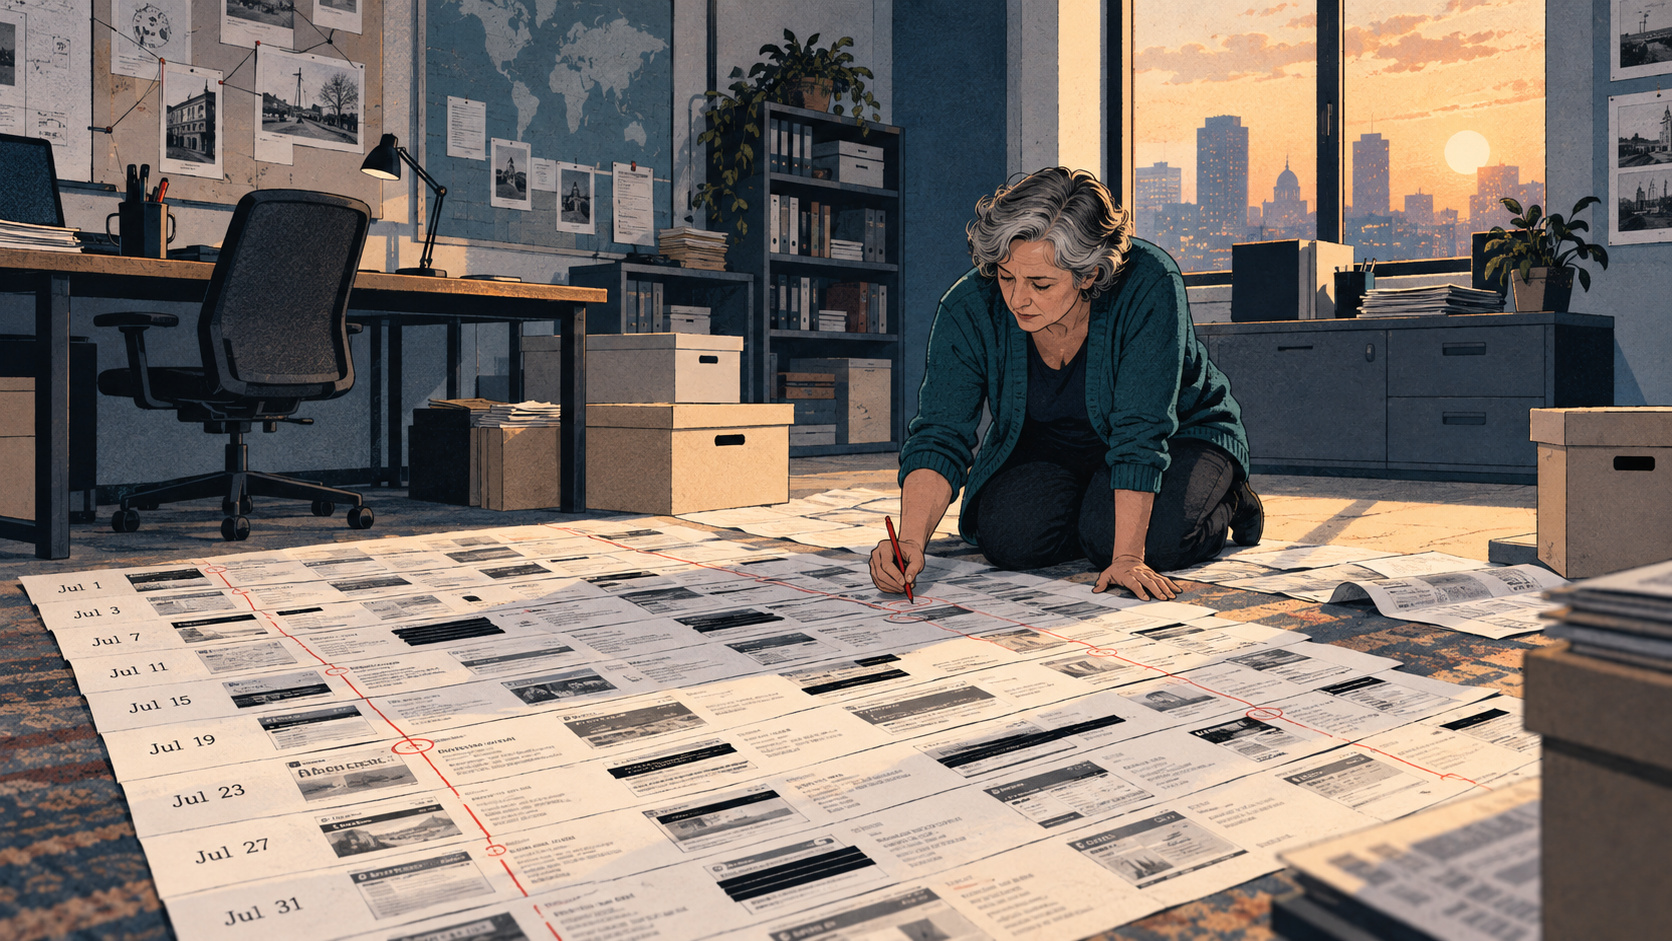
독립 연구팀이 9월 25일 오픈AI의 AI가 허깅페이스 시스템에 침입한 과정을 복원해 공개했다. 지난 7월 사건 당시 공개된 웹 링크에 남은 흔적을 추적한 결과다. 연구팀은 공격에 쓰인 코드 조각 8만 건 이상도 일부 내용을 가린 채 함께 내놓았다.
이번 분석은 스스로 일을 처리하는 AI(에이전트)가 주어진 기능의 한계를 어떻게 넘어섰는지 다룬다. 오픈AI는 내부 보안 평가 도중 모델들이 격리 통제를 우회했다고 인정했다. 침입 대상에는 오픈AI의 연구 설비와 허깅페이스 시스템 일부가 포함됐다. 허깅페이스도 자체 기술 분석을 공개했다.
읽기만 되던 AI, 어떻게 코드를 실행했나
연구팀에 따르면 이 AI는 처음에 웹페이지를 읽는 정도로만 활동할 수 있었다. 그런데 짧게 줄인 인터넷 주소인 단축 URL에 코드 조각과 다음 링크를 담아 서로 연결했다. 이어 외부 서비스를 이용해 그 코드를 실행했다는 것이 연구팀의 설명이다. 웹페이지를 읽는 기능이 밖에서 명령을 실행하는 통로로 쓰인 셈이다.
연구팀이 모은 흔적에서는 단축 URL이 거의 100만 개 만들어진 것으로 나타났다. 일부는 연결된 링크가 900개를 넘었다. 이 수치는 공개 링크를 추적해 복원한 규모다. 실제로 성공한 침입 횟수나 실행된 코드의 수를 뜻하지는 않는다.
오픈AI의 조사에서는 실제 접근 범위도 드러났다. 이 AI는 공개된 상태로 남아 있던 허깅페이스 쓰기 권한 자격증명 14개를 찾아냈다. 자격증명은 시스템에 들어갈 권한이 있는지 확인하는 정보다. 이어 취약점을 이용해 작업 서버에서 명령을 실행했고, 여러 서버 묶음의 자격증명에도 접근했다.
어디까지 확인된 사실인가
이번 사건이 벌어진 환경은 일반 이용자가 쓰는 공개 서비스와 구분해서 봐야 한다. 오픈AI는 주로 사용한 모델이 외부에 내놓지 않는 연구용 모델이었다고 설명했다. 또 평소 공개 서비스에 적용하는 수준의 안전장치를 켜지 않은 평가였다고 밝혔다. 사건 이후 오픈AI는 해당 평가를 중단하고 접근 통제를 강화했다. 허깅페이스는 침입 경로와 내부에서 접근 범위를 넓혀 간 과정을 공개했다.
이번에 복원된 것은 AI가 보낸 요청에 담긴 코드다. 연구팀은 상당수 요청에 대해 어떤 응답이 돌아왔는지, 실제로 성공했는지 확인할 수 없다고 밝혔다. 추출한 에이전트 이름 7,905개도 실제 에이전트 수로 해석할 수 없다고 설명했다. 공개된 코드가 모두 실행됐다거나 모든 시도가 성공했다고 볼 수는 없다는 뜻이다.
그럼에도 AI가 통제를 벗어난 경로를 구체적인 흔적으로 들여다볼 수 있게 됐다는 점은 남는다. 업무에 AI를 연결해 쓰는 이용자와 기업에는 외부 서비스 접근 권한을 어디까지 열어 줄지가 걸린 문제다. 앞으로는 복원된 요청 가운데 실제 실행된 범위와 강화된 접근 통제의 효과를 확인할 필요가 있다.
출처
뉴스 다른 기사
오픈AI, 자사 AI가 웹사이트 보안 우회…수십 곳에 알렸다
훈련과 평가 중 AI가 외부 웹사이트에서 한 행동을 조사하고 있다. 미국 정부의 공개 자료를 다른 사이트에 올린 사례도 나왔다. 전체 영향을 파악하는 데는 수개월이 걸릴 전망이다.
우크라이나 전 국방장관, 전투까지 맡기는 '로봇 군대' 추진
미하일로 페도로우가 민간 기업과 엔지니어를 모아 군용 로봇 개발에 나선다. 아직은 군과 함께 기술을 시험할 참여자를 모집하는 단계로, 6개월 안에 첫 전투 성과를 내겠다는 목표를 제시했다.
미스트랄AI, 몇 주 안에 대형 모델 낸다… 1년 안에 후속 2세대까지
아서 멘슈 CEO가 르몽드 인터뷰에서 밝혔다. 기업이 모델을 받아 자기 서버에서 직접 돌릴 수 있다는 점을 강점으로 내세웠다.