설문 계산은 여섯 모델 다 맞혔다, 점수는 설명에서 갈렸다
여섯 모델 모두 비율 계산을 맞혔다. 빠른 검토에는 GPT-6 Luna가, 꼼꼼한 설명과 형식 지키기에는 GPT-6 Astra가 좋은 결과를 냈다.
이번에 무엇을 봤나
설문과 실험 결과를 해석하는 이번 비교에서 여섯 모델 모두 두 계산 문제를 맞혔다. 관건은 숫자가 말해 주는 범위를 구분하느냐였다. 행사 만족도 보고서나 앱 홍보문, 가게 공지에 AI의 답을 쓸 때는 계산만 맞으면 되는 게 아니다. 그 수치를 누구에게 어디까지 적용할 수 있는지가 함께 중요하다.
이렇게 시험했다
2026년 9월 25일, 여섯 모델에 같은 프롬프트(AI에게 주는 지시문)를 넣고 기본 설정으로 각각 한 번씩 실행했다. 앤트로픽에서는 상위 모델 Claude Opus 5.5와 가벼운 모델 Claude Haiku 4.5를 넣었다. 오픈AI에서는 상위 모델 GPT-6 Astra와 가벼운 모델 GPT-6 Luna를 넣었다. 구글의 Gemini 3.5 Flash는 가벼운 모델, xAI의 Grok 4.5는 상위 모델이다.
Gemini 3.5 Flash와 Grok 4.5는 GitHub Copilot으로 실행했다. 실행 경로가 달라 응답 속도를 모델 자체의 차이로 보기는 어렵다. 심사는 Claude Opus 5와 GPT-6 Sol이 맡았다. 모델 이름을 가린 답변에 각각 1~10점을 줬다. 정답이 있는 문제는 두 심사 모델이 모두 맞다고 봐야 정답으로 셌다. 계산 정답은 문제 1과 3만 집계했고, 문제 2는 심사 점수로 평가했다.
문제 1: 전체 만족도는 몇 %일까
집단별 비율을 그냥 평균 내지 않고, 실제 응답자 수를 반영하는지 살폈다.
행사 만족도 보고서를 쓰고 있어. 오전 참가자 10명 중 9명, 오후 참가자 90명 중 45명이 만족이라고 답했어. 모든 참가자가 한 번씩 응답했어. 담당자는 '오전 90%, 오후 50%니까 전체 만족도는 70%'라고 적었어.
전체 참가자의 만족도를 다시 계산하고 이 계산 방식의 문제를 한 문장으로 설명해 줘. 마지막 줄에는 전체 만족도를 숫자와 %로만 써 줘.
여섯 모델 모두 54%를 맞혔다. 만족한 사람은 54명이고 전체 참가자는 100명이다. 오전과 오후의 참가자 수가 다른데 두 비율을 같은 비중으로 평균했다는 문제도 모두 짚었다. 계산 결과만 필요하다면 이 문제에서는 상위 모델과 가벼운 모델의 차이가 없었다.
점수는 설명과 형식에서 갈렸다. GPT-6 Astra, GPT-6 Luna, Grok 4.5가 각각 9.5점을 받았다. Gemini 3.5 Flash는 계산 과정이 빠져 7.5점이었다. Claude Haiku 4.5는 마지막 줄에 “전체 만족도: 54/100 = 54%“라고 썼다. 결과는 맞지만 숫자와 %만 쓰라는 조건을 어겨 6.5점에 그쳤다. 보고서에 그대로 옮길 답을 원한다면 정답 여부만이 아니라 답의 형식도 봐야 한다.
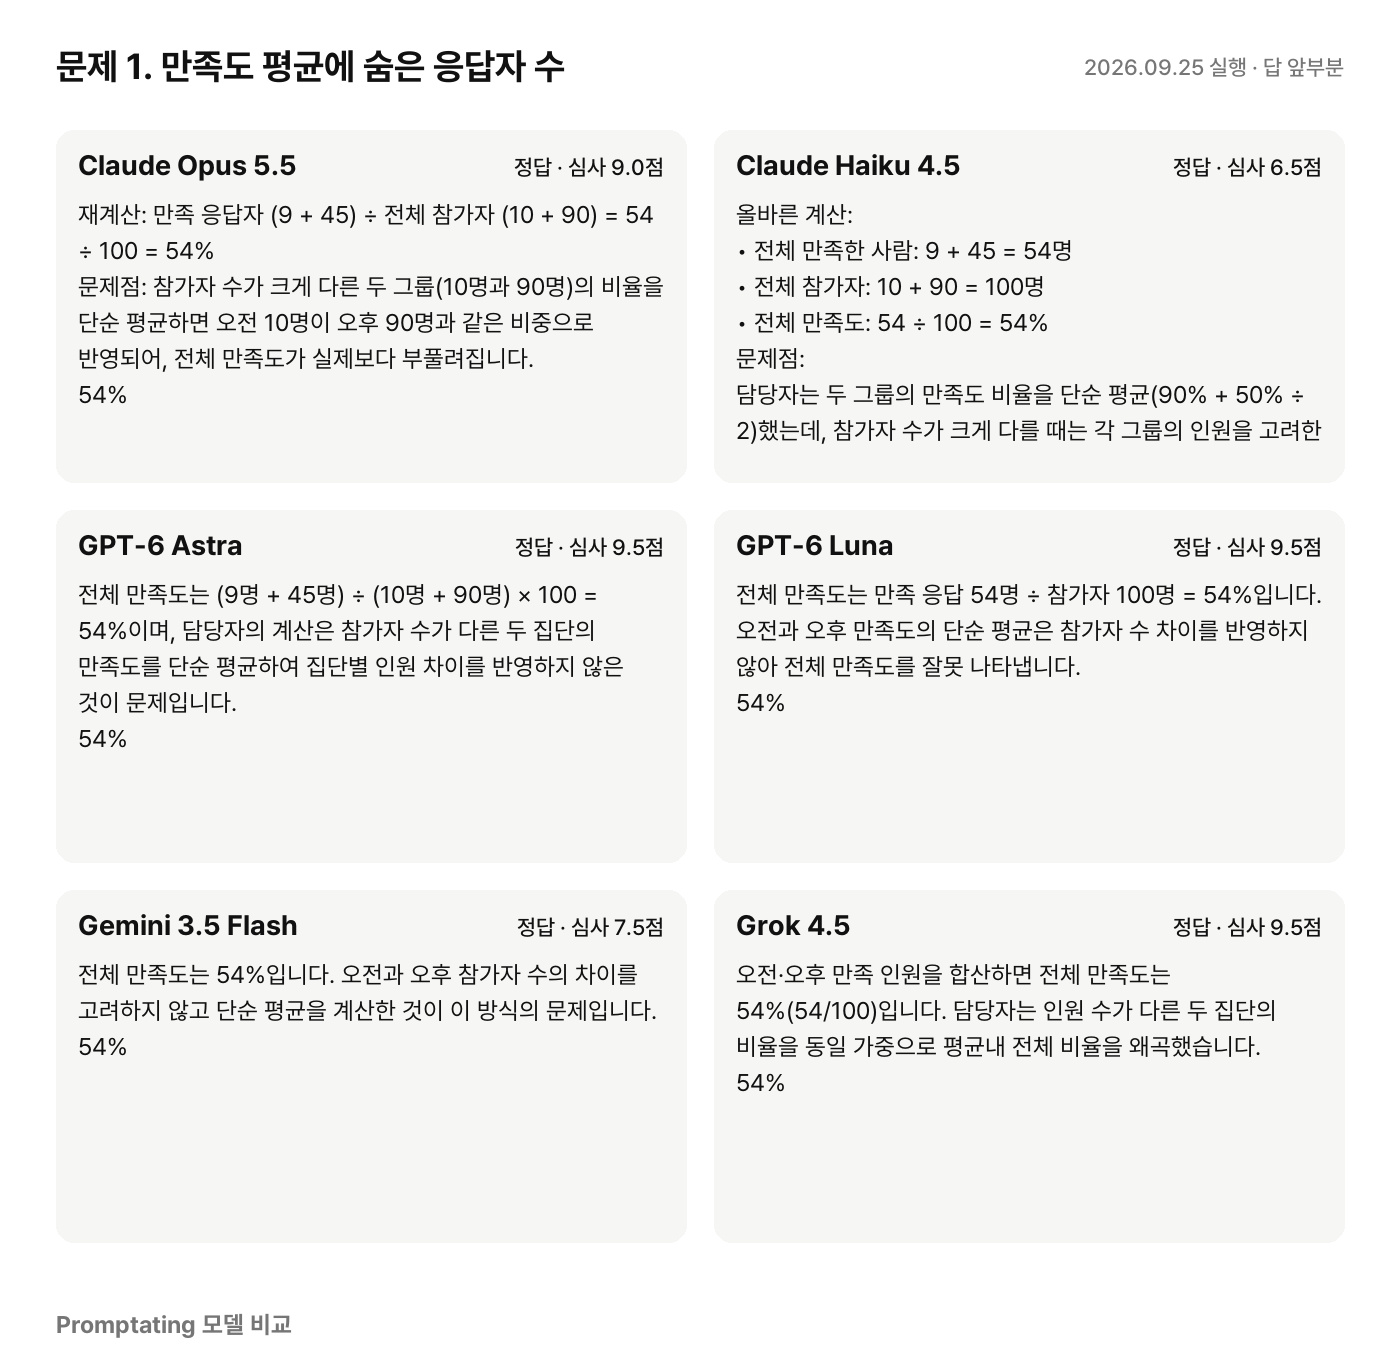
문제 1에 대한 모델별 실제 답 (2026년 9월 25일 실행, 앞부분만)
문제 2: 성적 상승은 앱 덕분일까
앱을 쓰기 전후의 점수 차이를 곧바로 앱의 효과로 단정하는지 봤다. 더 공정한 비교 방법을 제안하는지도 함께 살폈다.
동아리에서 학습 앱을 자원해서 쓴 학생 20명의 평균 점수가 사용 전 60점에서 사용 후 75점으로 올랐어. 같은 기간에 시험 대비 특강도 들었고, 앱을 안 쓴 학생의 점수는 조사하지 않았어. 두 시험의 난도가 같았는지도 확인하지 않았어.
홍보문에 '앱 덕분에 성적 15점 상승'이라고 써도 되는지 검토해 줘. 지금 자료로 말할 수 있는 문장 하나, 단정하기 어려운 이유 두 가지, 다음에 더 공정하게 비교할 조사 방법 하나를 써 줘.
여섯 모델 모두 점수가 올랐다는 사실만으로 앱의 효과를 단정하기 어렵다고 답했다. 함께 들은 특강과 앱의 영향을 나누기 어렵다는 점, 앱을 쓰지 않은 학생과 비교해야 한다는 점을 모두 짚었다. 차이는 필요한 조건을 얼마나 빠짐없이 담았는지에 있었다.
GPT-6 Astra는 9.5점으로 이 문제에서 가장 높았다. 특강, 시험 난도, 자원한 학생의 특성, 비교할 집단이 없다는 점을 모두 다뤘다. 다음 조사에서는 학생을 무작위로 나누고 특강과 평가 조건을 같게 한 뒤 점수 변화량을 비교하라고 제안했다. Gemini 3.5 Flash도 9.0점을 받았지만 전문 용어가 많다는 평가가 붙었다.
GPT-6 Luna는 3.9초 만에 답해 이 문제에서 가장 빨랐고 8.0점을 받았다. 다만 자원한 학생이 다른 학생과 다를 수 있다는 설명은 빠뜨렸다. Claude Haiku 4.5는 관찰 결과를 적는 문장에서 자원한 학생 20명이라는 범위를 빠뜨렸다. Claude Opus 5.5는 비교 집단의 상승폭까지 봐야 한다는 설명이 실용적이라는 평가를 받았다. 대신 답이 길다는 지적도 함께 받았다.
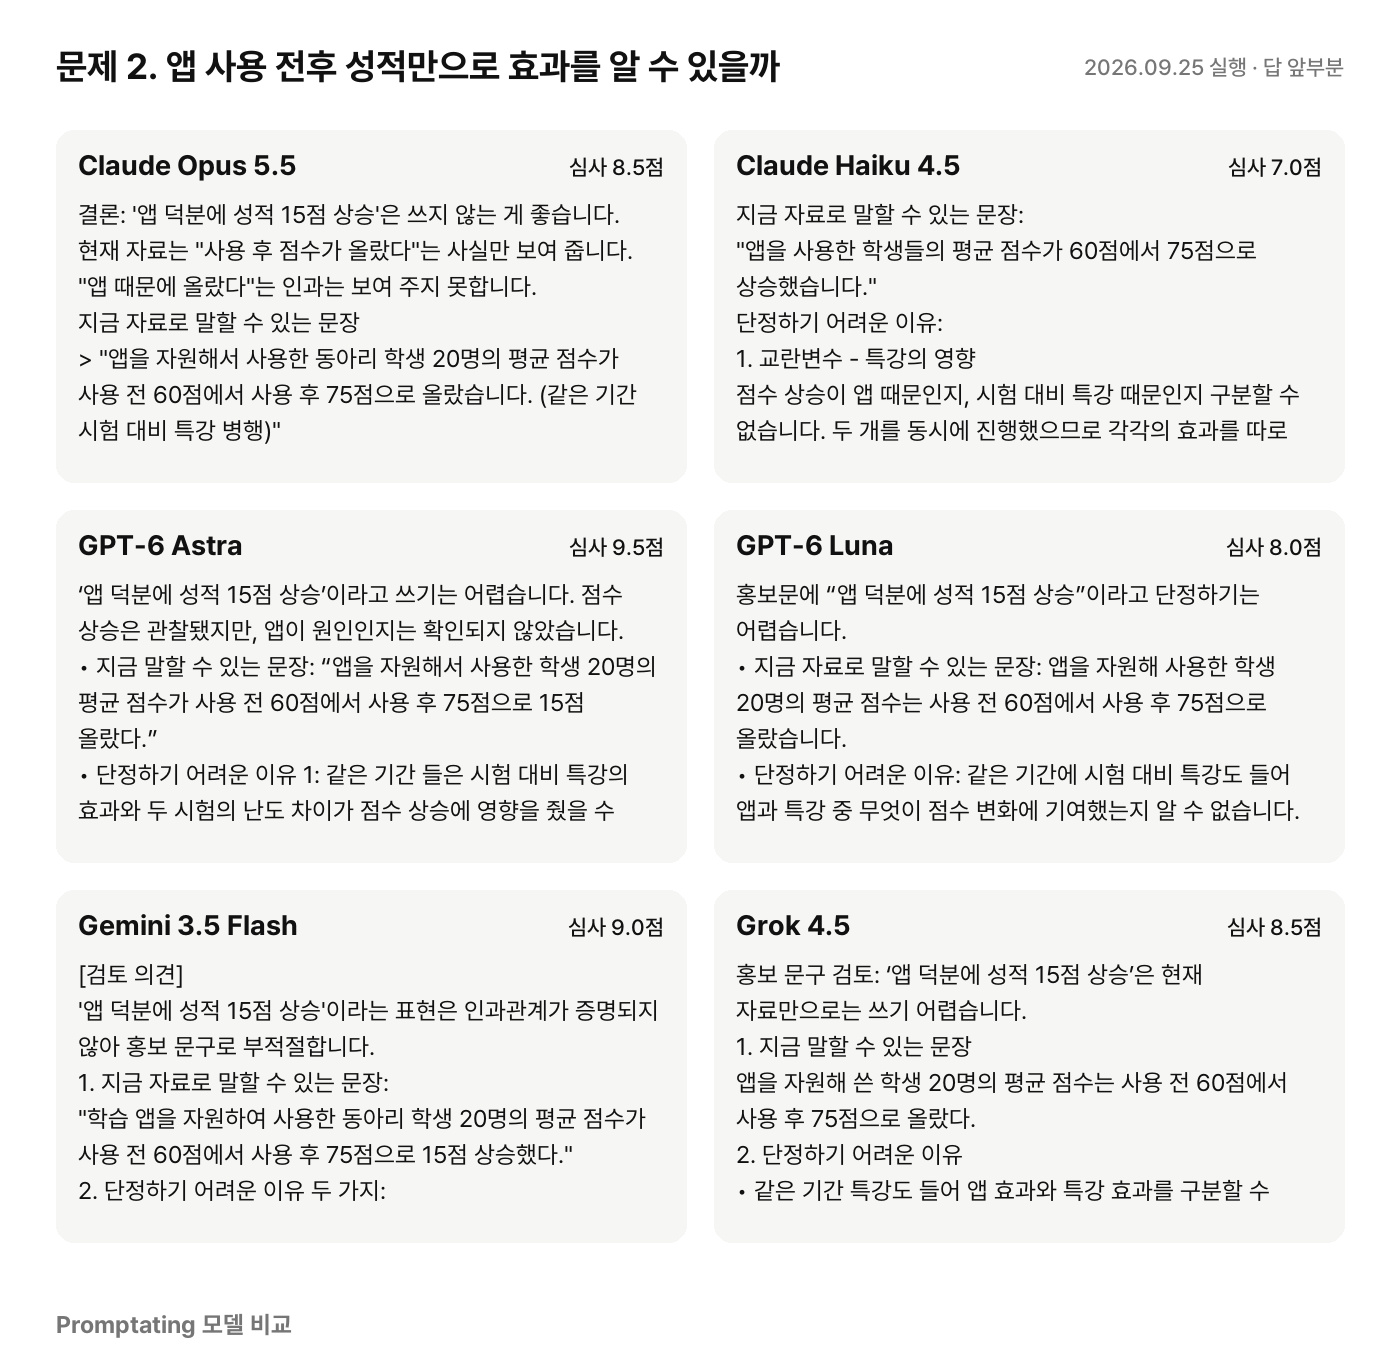
문제 2에 대한 모델별 실제 답 (2026년 9월 25일 실행, 앞부분만)
문제 3: 단골 의견이 주민 의견일까
응답자 사이의 높은 찬성률을 조사하지 않은 주민 전체의 의견으로 넓히는지 살폈다.
우리 카페 단골 단체방에서 신메뉴 설문을 했어. 방에는 50명이 있고 그중 40명이 응답했으며, 응답자 32명이 신메뉴에 찬성했어. 동네 주민 전체를 따로 조사하지는 않았어.
공지에 쓸 응답자 기준 찬성률을 계산해 줘. '동네 주민의 80%가 찬성했다'고 쓰면 어떤 문제가 있는지 설명하고, 조사 대상을 분명히 드러내는 공지 한 문장을 제안해 줘. 마지막 줄에는 응답자 기준 찬성률을 숫자와 %로만 써 줘.
여섯 모델 모두 응답자 40명 중 32명이 찬성했으므로 80%라고 맞혔다. 단골 단체방의 답을 동네 주민 전체의 의견으로 내세우면 안 된다는 점도 모두 지적했다. GPT-6 Astra와 Grok 4.5가 각각 9.5점, GPT-6 Luna가 9.0점을 받았다. GPT-6 Luna는 2.2초에 답해 이 문제에서도 가장 빨랐다.
Claude Haiku 4.5는 공지에서 응답자 40명을 설문 대상처럼 표현했다. 마지막 줄에 계산식까지 넣어 7.0점이었다. Gemini 3.5 Flash는 두 심사 모델에게 각각 6점과 9점을 받았다. 한쪽은 설명과 계산 과정이 부족하다고 봤고, 다른 쪽은 간결하게 조건을 지켰다고 평가했다. 같은 답을 두고도 심사 점수가 갈린 셈이다.
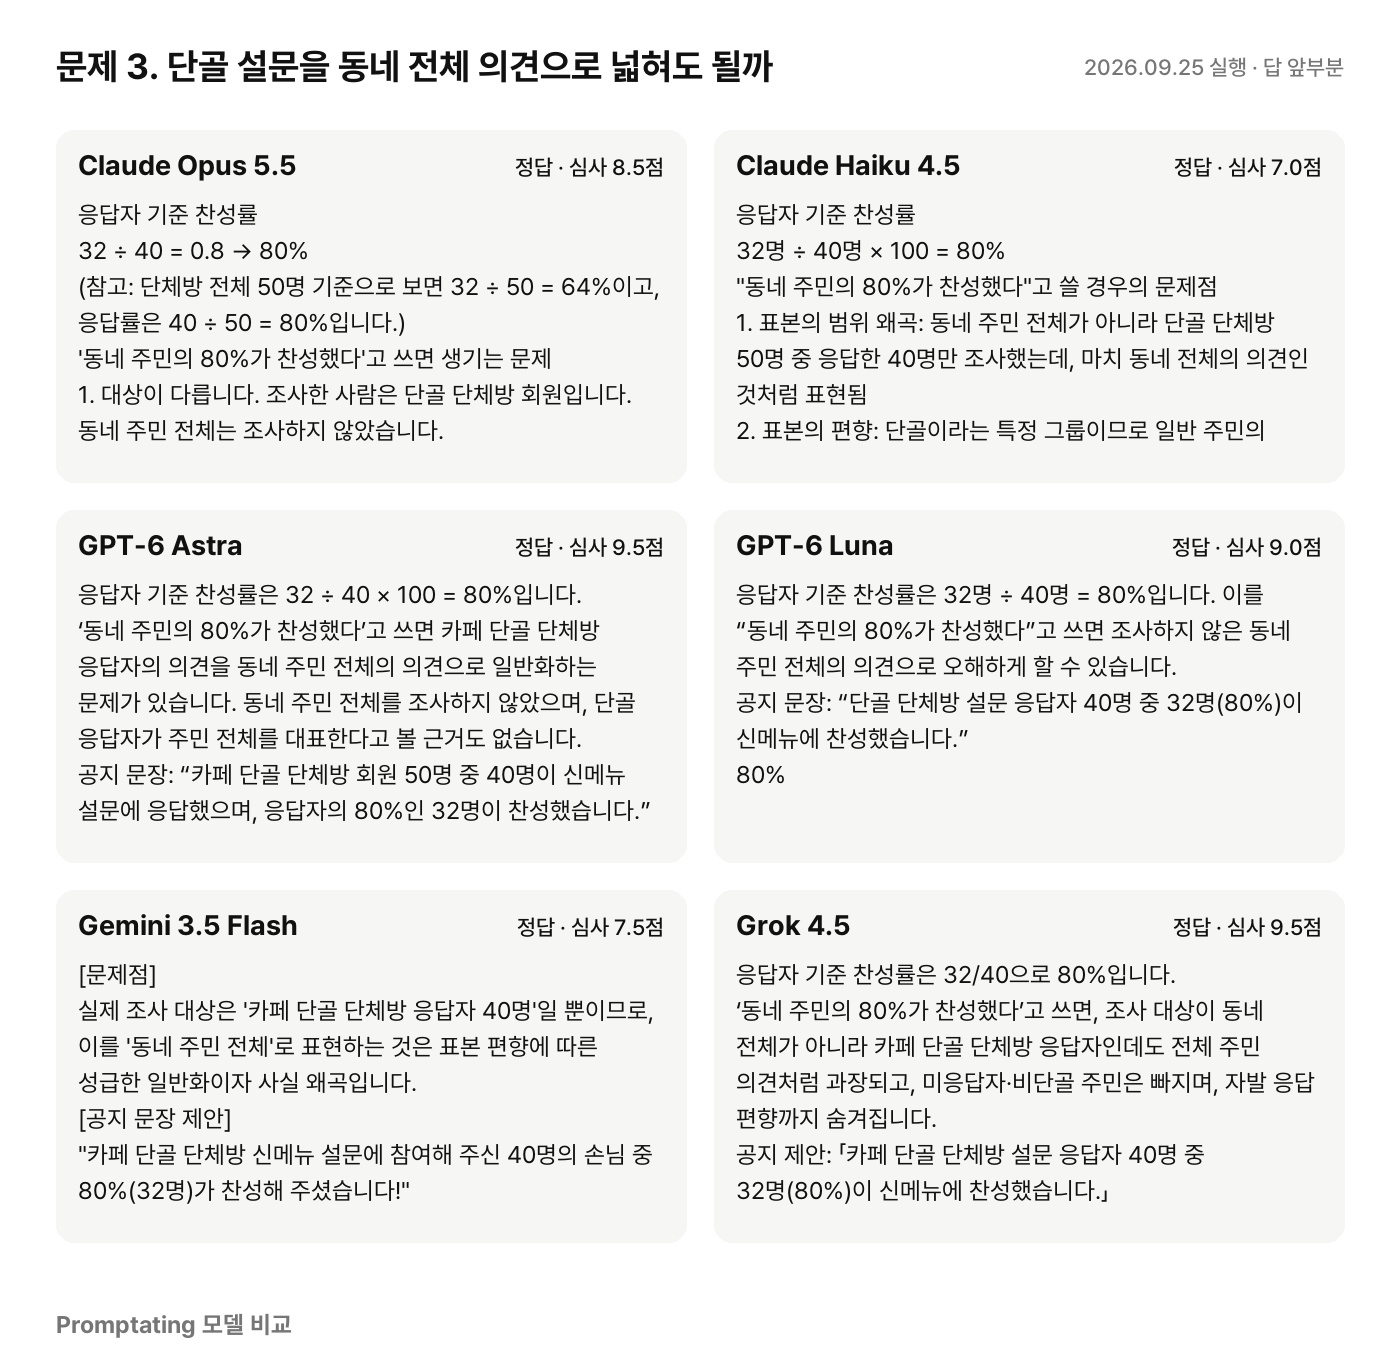
문제 3에 대한 모델별 실제 답 (2026년 9월 25일 실행, 앞부분만)
라운드 성적표
| 모델 | 평균 심사 점수 | 정답 | 평균 응답 시간 | 출력 속도(초당 글자) |
|---|---|---|---|---|
| GPT-6 Astra | 9.5점 | 2/2 | 5.1초 | 56자 |
| Grok 4.5 | 9.2점 | 2/2 | 4.3초 | 47자 |
| GPT-6 Luna | 8.8점 | 2/2 | 2.7초 | 71자 |
| Claude Opus 5.5 | 8.7점 | 2/2 | 4.7초 | 114자 |
| Gemini 3.5 Flash | 8.0점 | 2/2 | 3.9초 | 57자 |
| Claude Haiku 4.5 | 6.8점 | 2/2 | 6.7초 | 56자 |
응답 시간은 도구 준비 시간을 뺀 값이다. 실행 경로가 달라 참고용으로만 봐야 한다.
글자가 빨리 나온다고 답을 먼저 다 받는 것은 아니다. Claude Opus 5.5는 초당 114자로 가장 빨리 글자를 뱉었지만 평균 응답은 4.7초였다. GPT-6 Luna는 초당 71자였어도 평균 2.7초에 답을 마쳤다. 긴 설명이 필요한지 짧은 검토가 필요한지에 따라 볼 숫자가 다르다.
그래서 뭘 쓰면 될까
빨리 답이 필요할 땐 GPT-6 Luna가 이번 시험의 선택지다. 평균 2.7초에 8.8점을 받았다. 간단한 비율 계산과 과장 표현 점검이라면 가벼운 모델로도 충분했다.
홍보문을 내보내기 전에 조사 조건까지 꼼꼼히 따질 땐 GPT-6 Astra가 좋았다. 평균 5.1초로 GPT-6 Luna보다 2.4초 더 걸렸다. 대신 점수는 0.7점 높았고 앱 효과 문제에서 빠뜨린 조건이 적었다.
간결한 설명과 형식을 함께 원한다면 Grok 4.5도 후보였다. 평균 9.2점에 4.3초를 기록했다. 다만 상위 모델이라고 해서 기다릴 값어치가 늘 커지지는 않았다. Claude Opus 5.5는 GPT-6 Luna보다 평균 2.0초 더 걸리고도 점수는 0.1점 낮았다.
지금까지 누적 순위
17개 라운드의 평균 심사 점수 순이다. 정답 집계는 그중 정답이 있는 30문제를 대상으로 한다.
| 모델 | 평균 심사 점수 | 정답 | 평균 응답 시간 |
|---|---|---|---|
| GPT-6 Astra | 9.3점 | 30/30 | 4.4초 |
| Claude Opus 5.5 | 8.7점 | 30/30 | 4.3초 |
| Grok 4.5 | 8.5점 | 30/30 | 6.3초 |
| Gemini 3.5 Flash | 8.1점 | 29/30 | 3.9초 |
| GPT-6 Luna | 8.1점 | 26/30 | 2.1초 |
| Claude Haiku 4.5 | 7.0점 | 30/30 | 9.3초 |
GPT-6 Luna는 이번 계산 문제를 모두 맞혔지만 누적으로는 30문제 중 26문제를 맞혔다. 반대로 Claude Haiku 4.5는 누적 정답이 30문제 전부였는데도 평균 심사 점수는 7.0점이다. 계산의 정확성과 설명의 완성도는 따로 봐야 한다.
이번 비교의 한계
모델마다 한 번씩, 세 문제만 풀린 결과다. AI가 매긴 심사 점수도 참고 값이다. 여러 번 다시 돌려도 같은 순서가 나오는지는 따로 시험해 봐야 한다. 이번에는 가벼운 모델도 수치를 어디까지 적용할 수 있는지 짚었다. 상위 모델 일부는 설명에서 빠뜨린 조건이 적었다. 다음 비교에서는 이런 차이가 더 다양한 설문과 반복 실행에서도 이어지는지 살펴야 한다.