저녁 준비 맡겨 보니, 가벼운 AI도 장보기 계산은 다 맞혔다
가벼운 모델인 Gemini 3.5 Flash가 좋은 성적을 냈고, GPT-6 Astra는 세 문제에서 고르게 높은 점수를 받았다.
오늘의 질문
인분과 남은 재료, 조리 순서가 얽힌 저녁 준비를 AI에 맡겨도 될까. 이번 비교에서 장보기 계산은 여섯 모델이 모두 맞혔다. 하지만 오븐 사용 시간표와 있는 재료로만 만드는 조리법에서는 성적이 갈렸다.
인분만 늘린다고 장보기가 끝나지는 않는다. 집에 남은 재료와 파는 포장 크기를 함께 따져야 한다. 조리할 때는 혼자 할 수 있는 일과 기구를 나눠 써야 하는 일의 순서까지 맞춰야 한다.
이렇게 시험했다
2026년 9월 25일, 여섯 모델에 같은 지시문을 주고 기본 설정으로 한 번씩 실행했다. 앤트로픽의 Claude Opus 5.5, 오픈AI의 GPT-6 Astra, xAI의 Grok 4.5는 상위 모델이다. Claude Haiku 4.5, GPT-6 Luna, 구글의 Gemini 3.5 Flash는 가벼운 모델로 함께 비교했다.
Gemini 3.5 Flash와 Grok 4.5는 GitHub Copilot으로 실행했다. 실행 경로가 달라 응답 속도를 모델 자체의 차이로 보기는 어렵다. 각 모델에 짧은 확인 답변을 먼저 시켜 준비 시간을 잰 뒤, 문제 응답 시간에서 그 값을 뺐다.
채점은 Claude Opus 5와 GPT-6 Sol이 맡았다. 두 심사 모델은 답변을 쓴 모델 이름을 모르는 상태에서 10점 만점으로 점수를 매겼다. 정답이 정해진 문제는 둘 다 맞다고 해야 정답으로 셌다. 정답 수는 문제 1과 2만 반영하고, 평균 점수는 세 문제를 모두 반영한다.
문제 1: 몇 봉지를 사야 할까
인분에 맞춰 재료량을 늘리고, 집에 있는 양을 뺀 뒤 포장 단위에 맞게 구매량을 올리는지 살폈다.
3인분 레시피에 마른 파스타 240g과 소스 360g이 필요해. 재료 비율을 그대로 유지해 5인분을 만들 거야. 집에는 파스타 150g과 소스 100g이 있어. 파스타는 200g 봉지, 소스는 250g 병으로만 팔고 낱개로 덜어 살 수 없어.
재료별 총 필요량, 추가로 필요한 양, 최소 구매 수량, 요리 후 남는 양을 계산해 줘. 마지막 줄은 '파스타 N봉지, 소스 N병' 형식으로 적어 줘.
여섯 모델 모두 마지막 구매량을 ‘파스타 2봉지, 소스 2병’으로 맞혔다. 총 필요량은 파스타 400g과 소스 600g이다. 집에 있는 양을 빼면 각각 250g과 500g이 부족해 두 포장씩 사야 한다. 조리 후에는 파스타 150g이 남고 소스는 남지 않는다.
차이는 설명 방식에서 났다. Claude Opus 5.5는 1인분 계산부터 부족분까지 자세히 풀었다. Grok 4.5는 138자로 필요한 항목만 정리했고, GPT-6 Astra는 표로 수치를 묶었다. 세 모델의 평균 심사 점수는 모두 9.5점이었다.
가벼운 모델 세 개도 모두 9.0점을 받았다. GPT-6 Luna는 3.1초 만에 정확히 답했다. 다만 한 심사 모델은 수식 표기가 읽기 불편하다고 지적했다. 장보기 계산만 놓고 보면 상위 모델을 골라야 정답을 얻는 상황은 아니었다.
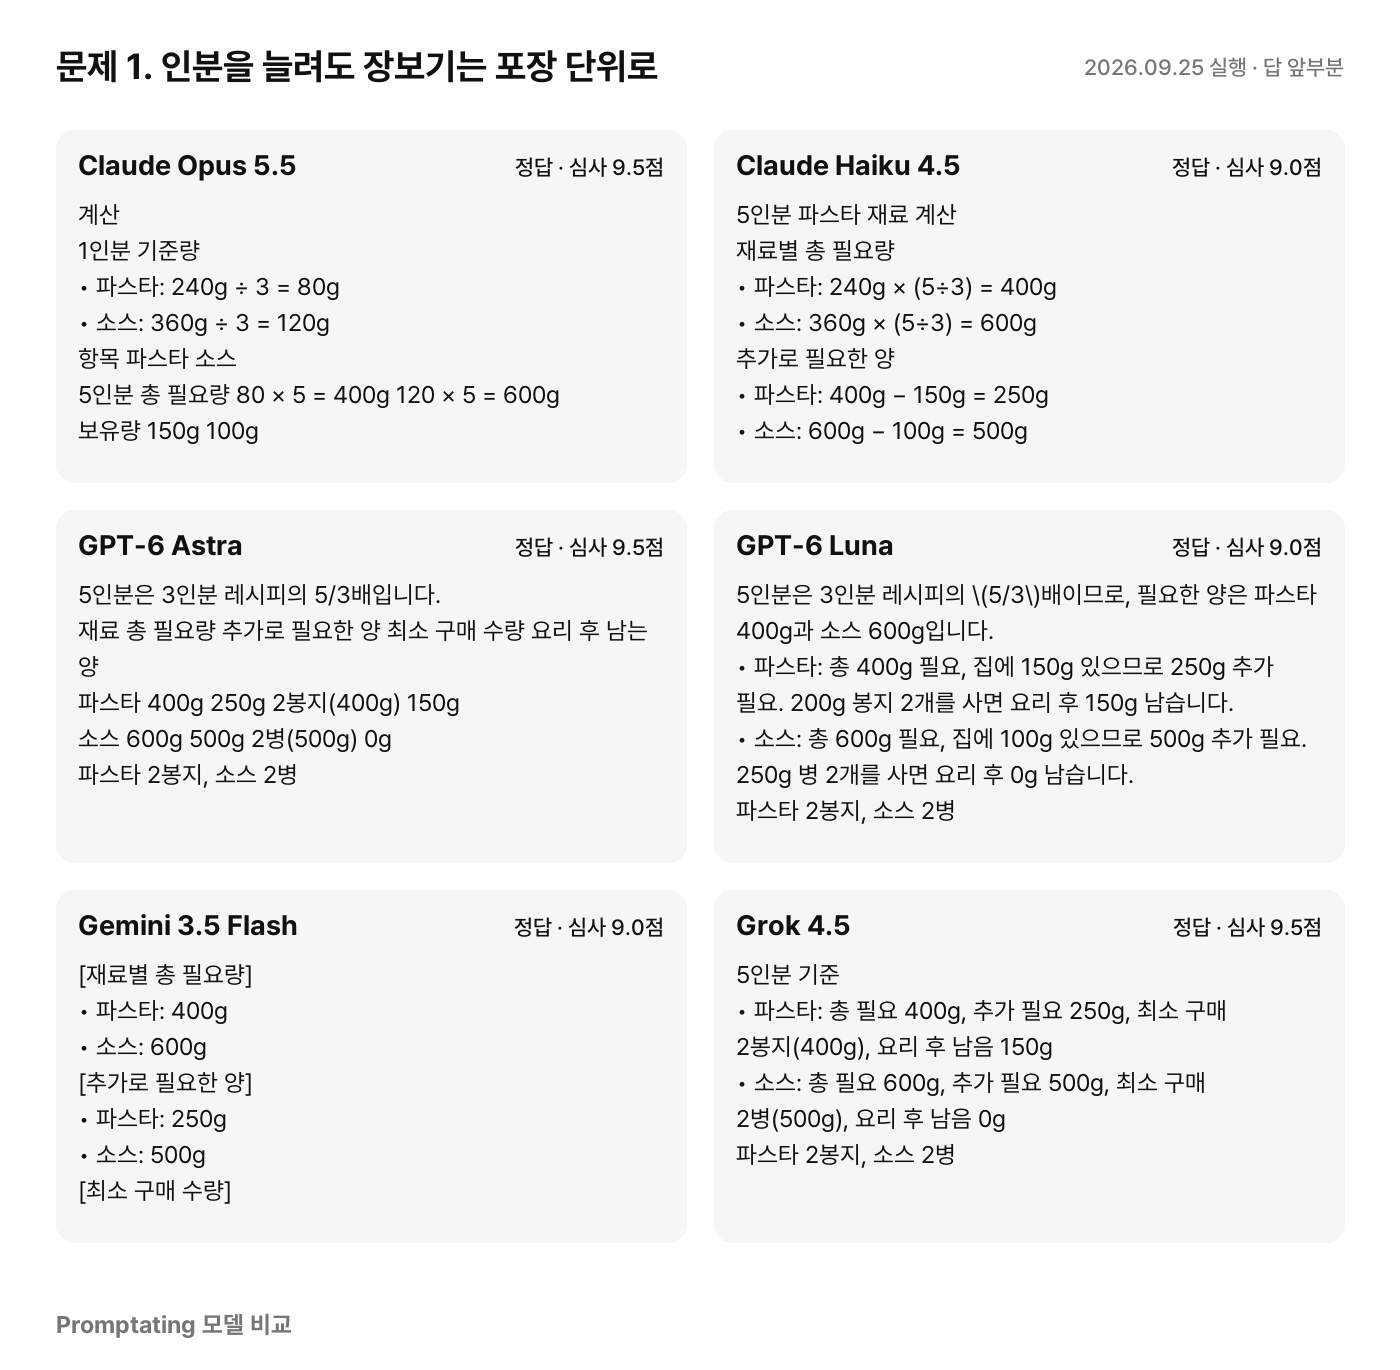
문제 1에 대한 모델별 실제 답 (2026년 9월 25일 실행, 앞부분만)
문제 2: 오븐 한 대, 언제 시작할까
겹쳐서 할 수 있는 준비 작업과 차례로 해야 하는 굽기를 구분하는지 시험했다.
18:30에 두 음식을 동시에 차리고 싶어. 아래 시간과 조건만으로 가장 늦게 시작할 수 있는 시각과 작업 시간표를 알려 줘.
오븐 예열은 10분이고 조리 온도는 같아. 오븐에는 한 번에 한 접시만 들어가. A는 재료 준비 15분, 굽기 25분이고 다 구운 뒤 최대 20분 기다려도 돼. B는 준비 10분, 굽기 15분이고 구운 즉시 내야 해. 혼자 하므로 A와 B의 재료 준비는 동시에 못 하지만, 예열이나 굽는 동안에는 재료 준비를 할 수 있어. 오븐에 넣고 빼는 시간은 0분으로 계산해.
마지막 줄에는 시작 시각을 HH:MM 형식으로 적어 줘.
정답은 17:35다. GPT-6 Luna를 뺀 다섯 모델이 맞혔다. A 준비 15분, A 굽기 25분, B 굽기 15분은 차례로 해야 한다. 예열은 A 준비와, B 준비는 A 굽기와 겹칠 수 있다. A는 18:15에 꺼내 15분 기다리면 된다.
GPT-6 Astra와 Gemini 3.5 Flash가 나란히 9.5점을 받았다. 각각 10.6초와 11.1초 만에 조건에 맞는 시간표를 냈다. GPT-6 Astra는 왜 최소 55분이 필요한지까지 설명했고, Gemini 3.5 Flash는 작업 순서를 간결하게 적었다.
GPT-6 Luna는 2.4초로 빨랐지만 시작 시각을 ‘17:55’로 잡았다. 제시한 일정도 목표보다 25분 늦은 18:55에 끝났다. Claude Haiku 4.5는 정답을 맞혔으나 127.3초가 걸렸다. 설명에 잘못된 시간 계산이 섞여 8.0점에 그쳤다. 빠른 답도, 오래 기다린 답도 완성도를 보장하지는 않았다.
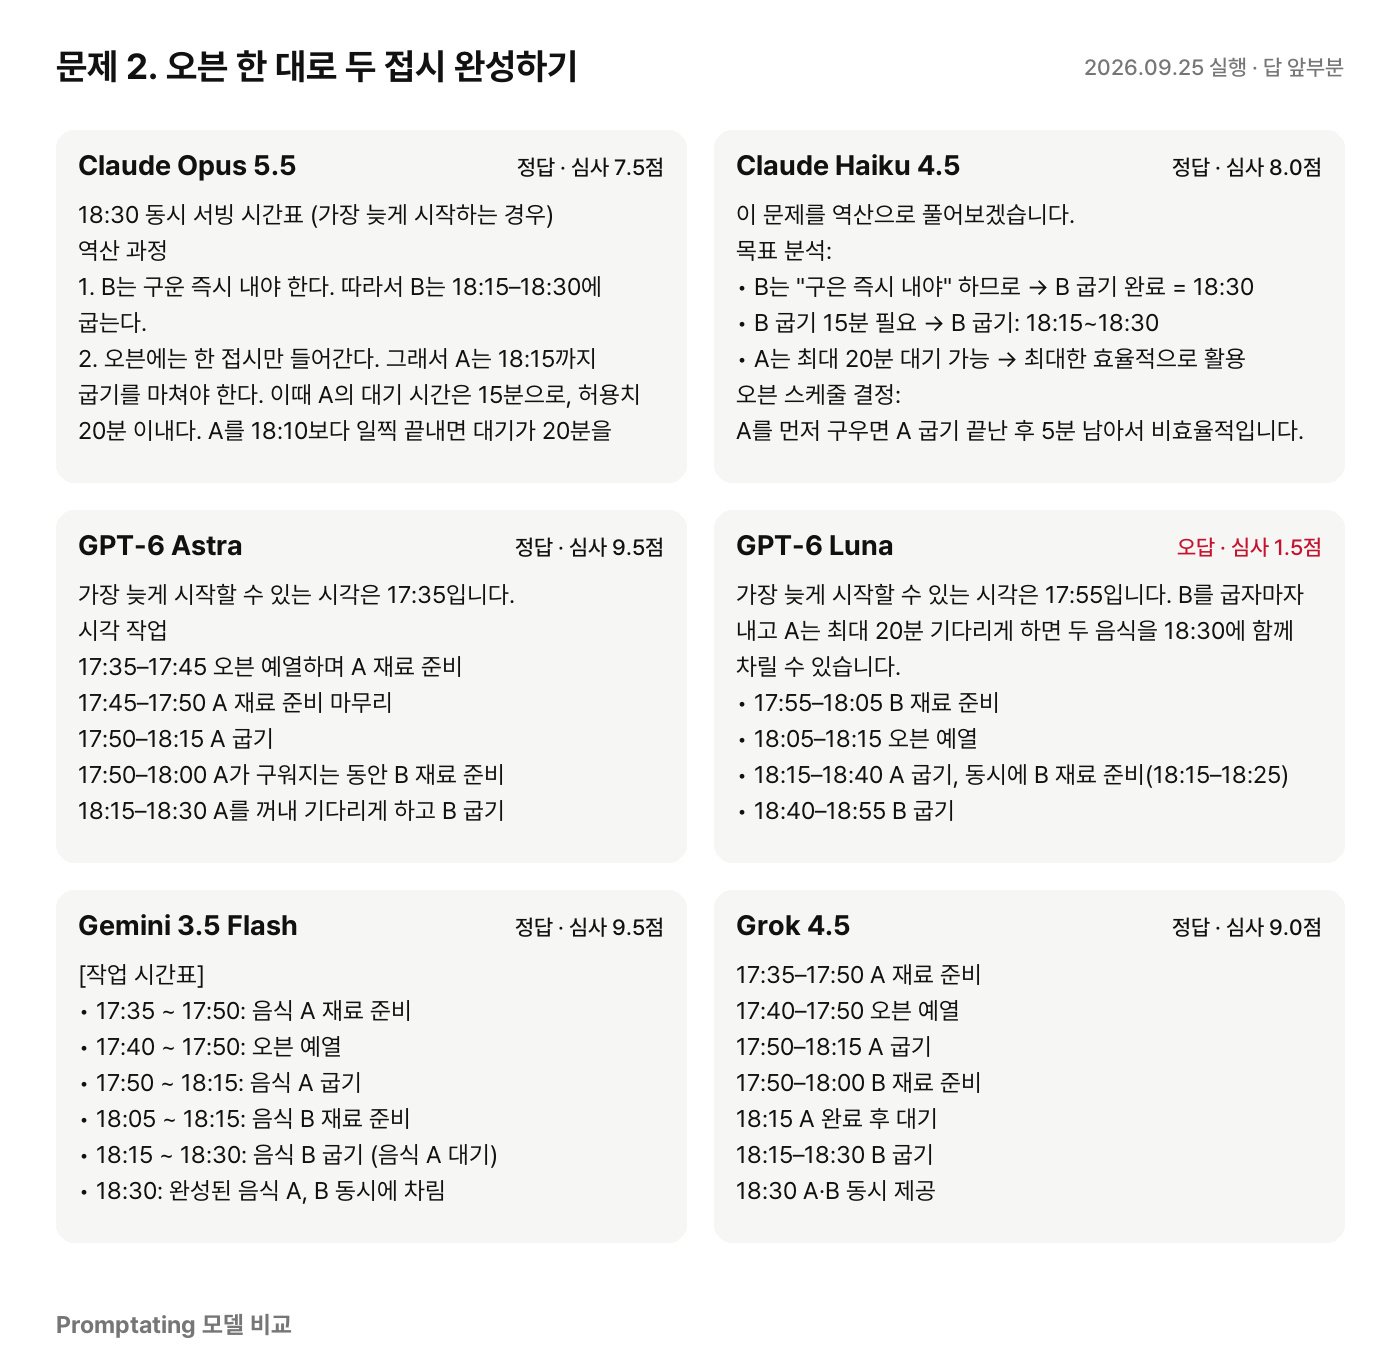
문제 2에 대한 모델별 실제 답 (2026년 9월 25일 실행, 앞부분만)
문제 3: 있는 재료로만 차릴 수 있을까
없는 양념을 끼워 넣지 않고, 화구 하나로 실행할 수 있는 순서를 쓰는지 살폈다.
장을 더 보지 않고 두 사람의 저녁을 만들고 싶어. 가진 것은 밥 2공기, 두부 1모, 양배추 200g, 식용유, 소금, 물뿐이야. 프라이팬 하나와 냄비 하나, 화구 하나가 있어. 간장, 마늘, 달걀 등 다른 재료는 전혀 없어.
이 재료만으로 밥과 따뜻한 반찬 한 가지를 차리는 방법을 5단계 이내로 써 줘. 쓸 재료와 양을 밝히고, 화구 하나로 가능한 순서로 설명해 줘.
이 문제는 정답을 하나로 정하지 않고 조건을 얼마나 지켰는지로 점수를 매겼다. GPT-6 Astra와 GPT-6 Luna가 각각 9.5점으로 가장 높았다. 두 모델 모두 밥을 먼저 데워 둔 뒤 프라이팬으로 반찬을 만드는 순서를 택했다. 응답 시간은 각각 12.2초와 5.9초였다.
GPT-6 Astra는 물 100mL를 밥과 반찬에 나눠 쓰도록 양을 정했다. GPT-6 Luna도 다섯 단계 안에 밥 데우기와 반찬 조리를 담았다. 오븐 시간표를 틀린 가벼운 모델이 이 문제에서는 상위 모델과 같은 점수를 받은 셈이다.
Claude Opus 5.5는 보온 방법과 두부가 부서지지 않게 하는 요령까지 담아 9.0점을 받았다. 반면 Claude Haiku 4.5는 밥을 준비하는 단계가 빠지고 불필요한 과정이 들어가 4.5점에 머물렀다. 제목에 쓴 ‘두부 계란국 대신’이라는 표현도 지적받았다. 다만 실제 조리 단계에 달걀을 넣은 것은 아니다. Grok 4.5는 밥 데우는 순서와 일부 분량이 불명확하다는 평가로 6.5점을 받았다.
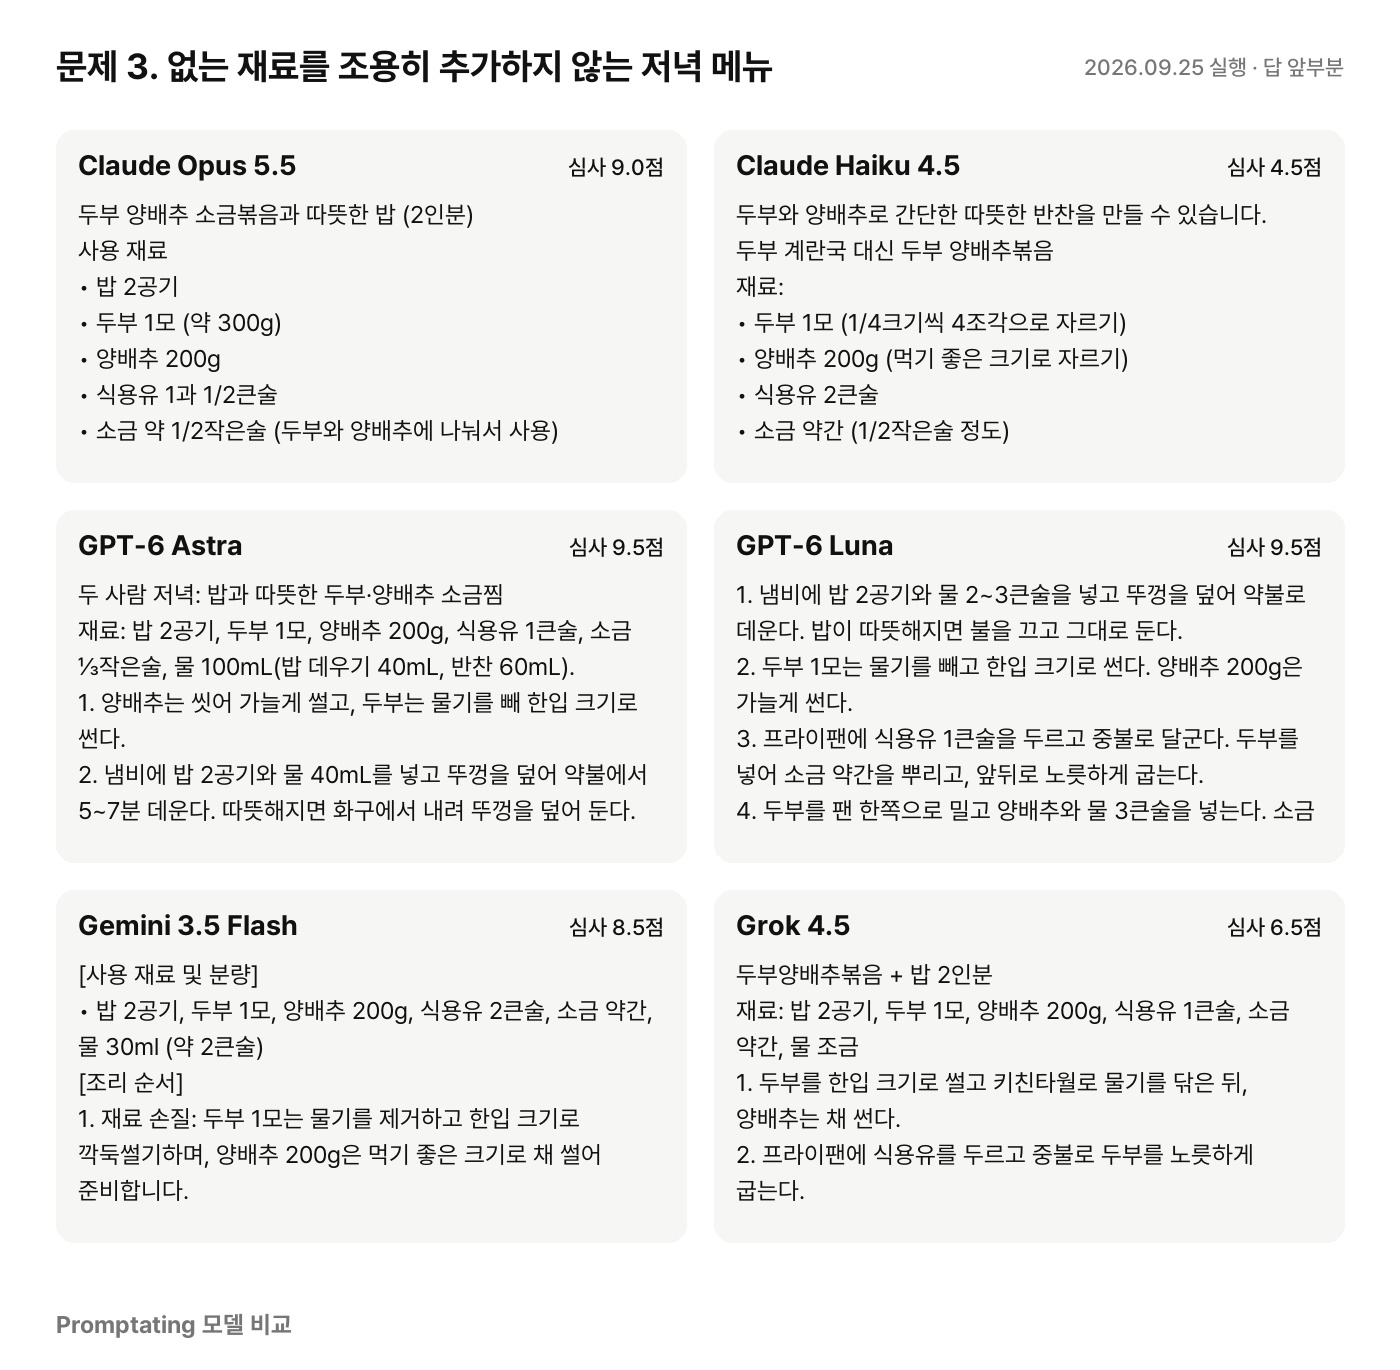
문제 3에 대한 모델별 실제 답 (2026년 9월 25일 실행, 앞부분만)
이번 라운드 성적표
| 모델 | 평균 심사 점수 | 정답 | 평균 응답 시간 | 출력 속도(초당 글자) |
|---|---|---|---|---|
| GPT-6 Astra | 9.5점 | 2/2 | 9.7초 | 34 |
| Gemini 3.5 Flash | 9.0점 | 2/2 | 7.8초 | 39 |
| Claude Opus 5.5 | 8.7점 | 2/2 | 8.1초 | 97 |
| Grok 4.5 | 8.3점 | 2/2 | 23.2초 | 20 |
| Claude Haiku 4.5 | 7.2점 | 2/2 | 48.5초 | 38 |
| GPT-6 Luna | 6.7점 | 1/2 | 3.8초 | 77 |
응답 시간은 준비 시간을 뺀 값이다. 실행 경로가 달라 참고용으로만 봐야 한다. 출력 속도는 문제별 값의 평균이다.
그래서 뭘 쓰면 될까
장보기 계산과 간단한 조리 순서라면 가벼운 모델도 충분히 쓸 만하다. Gemini 3.5 Flash는 정답이 있는 문제를 모두 맞히고 평균 9.0점을 받아 이번 라운드에서 균형이 좋았다.
빨리 답을 받고 싶다면 평균 3.8초인 GPT-6 Luna가 후보다. 다만 끝나는 시각이 중요한 일정은 직접 검산해야 한다. 문제 1과 3의 성적은 좋았지만 오븐 시간표에서 약점이 드러났다.
여러 조건을 고르게 지키는 답을 원한다면 GPT-6 Astra가 유력하다. 세 문제 모두 9.5점을 받았다. 오래 기다린다고 결과가 좋아지지도 않았다. Grok 4.5는 평균 23.2초로 GPT-6 Astra보다 오래 걸렸지만 평균 점수는 더 낮았다.
지금까지 누적 순위
13개 라운드의 평균 심사 점수 순이다. 정답 수는 정답이 정해진 23개 문제를 기준으로 한다.
| 순위 | 모델 | 평균 심사 점수 | 정답 | 평균 응답 시간 |
|---|---|---|---|---|
| 1 | GPT-6 Astra | 9.3점 | 23/23 | 4.0초 |
| 2 | Claude Opus 5.5 | 8.7점 | 23/23 | 3.6초 |
| 3 | Grok 4.5 | 8.4점 | 23/23 | 6.8초 |
| 4 | Gemini 3.5 Flash | 8.2점 | 22/23 | 3.8초 |
| 5 | GPT-6 Luna | 7.9점 | 19/23 | 1.8초 |
| 6 | Claude Haiku 4.5 | 6.9점 | 23/23 | 10.1초 |
이번 비교의 한계
문제는 세 개뿐이고, 모델마다 한 번씩만 실행했다. AI가 매긴 점수도 참고 값이다. 같은 답을 두고 한 심사 모델은 설명이 충실하다고 봤고, 다른 심사 모델은 너무 길다고 평가한 사례도 있었다. 점수 차이를 곧 품질 차이로 읽기는 어렵다.
이번 결과에서 중요한 기준은 모델의 등급보다 맡기려는 일의 성격이었다. 장보기 계산에는 가벼운 모델도 충분했다. 반면 정해진 시각에 끝내야 하는 일은 시간표를 다시 확인해야 했다. 앞으로 같은 시험을 여러 번 반복해도 이런 차이가 이어지는지, 제안한 순서가 실제 조리에서도 쓸모 있는지 살펴볼 만하다.