시설 한 곳 고르기는 가벼운 AI로 충분, 하루 일정은 달랐다
시설 한 곳을 고르는 문제는 가벼운 모델도 정확히 풀었다. 반면 예약 동선을 짜고 결항 뒤 일정을 고치는 문제에서는 GPT-6 Astra가 가장 고른 결과를 냈다.
오늘의 질문
예약 시간과 이동 시간을 함께 따져야 할 때, AI가 짠 여행 일정은 실제로 지킬 수 있을까. 이번 비교에서 여섯 모델은 비를 피할 대체 시설을 모두 정확히 골랐다. 하지만 여러 장소를 잇거나 배가 끊긴 뒤 계획을 고칠 때는 차이가 났다. 여행자에게 필요한 건 그럴듯한 추천이 아니라 예약과 귀가 시간을 지킬 수 있는 일정이다.
이렇게 시험했다
2026년 9월 25일, 모든 모델에 같은 프롬프트(AI에게 주는 지시문)를 주고 기본 설정으로 한 번씩 실행했다. 앤트로픽의 Claude Opus 5.5, 오픈AI의 GPT-6 Astra, xAI의 Grok 4.5는 상위 모델이다. 앤트로픽의 Claude Haiku 4.5, 오픈AI의 GPT-6 Luna, 구글의 Gemini 3.5 Flash는 가벼운 모델로 비교했다.
Gemini 3.5 Flash와 Grok 4.5는 GitHub Copilot으로 실행했다. 실행 경로가 달라 응답 시간을 그대로 견주기는 어렵다. 각 모델이 “OK” 한마디를 답하는 데 걸린 시간을 준비 시간으로 보고, 문제별 측정 시간에서 뺐다.
채점은 Claude Opus 5와 GPT-6 Sol이 맡았다. 두 모델은 어느 모델의 답인지 모르는 상태에서 각각 1~10점을 매겼다. 정답이 있는 문제는 두 채점 모델이 모두 맞다고 봐야 정답으로 셌다. 정답 수는 문제 1과 2만, 평균 점수는 세 문제 모두를 반영한다.
문제 1: 예약에 늦지 않을까
주어진 길만 이용하면서 예약, 관람, 복귀 시간을 모두 지키는지 보는 문제다.
가상의 여행지에서 하루 동선을 짜 줘. 09:00에 역에서 출발해 박물관, 시장, 전망대를 한 번씩 방문한 뒤 14:00까지 역에 돌아와야 해. 이동은 아래 세 구간을 잇는 도보만 가능하고, 왕복 시간이 같아. 대기 시간은 자유롭게 넣어도 돼. 관람이나 체류 없이 길만 통과하는 것은 방문 횟수에 세지 않아.
역 ↔ 박물관: 20분, 박물관 ↔ 시장: 15분, 시장 ↔ 전망대: 25분.
박물관: 10:00 예약 입장, 관람 60분. 시장: 11:00부터 이용 가능, 점심 포함 50분 체류. 전망대: 09:00부터 이용 가능, 관람 30분.
세 곳을 방문하는 순서와 이동, 대기를 포함한 시간표를 적어 줘. 마지막 줄에는 가장 빠른 역 복귀 시각을 HH:MM 형식으로 적어 줘.
GPT-6 Luna를 뺀 다섯 모델이 가장 빠른 복귀 시각인 14:00을 맞혔다. 박물관을 먼저 관람하고 시장에서 점심을 먹은 뒤 전망대로 가는 순서다. 돌아오는 길에 시장과 박물관을 지나도 다시 관람하지 않으면 방문 횟수에 세지 않는다.
GPT-6 Astra는 이동 구간과 대기를 나눠 적고, 돌아올 때는 통과만 한다는 설명을 붙여 9.5점을 받았다. GPT-6 Luna는 이어진 길을 쓸 수 있는데도 경로가 없다고 판단했다. 답은 3.2초 만에 나왔지만 결론은 “계산 불가"였다.
정답을 맞힌 답변에도 계산 실수는 있었다. Claude Opus 5.5의 시간표는 맞았다. 다만 전망대를 먼저 가는 경우를 설명하면서 도착 시각을 09:40으로 적었다. 세 구간을 합치면 이동에 60분이 걸리므로 09:00에 출발하면 도착은 10:00이다. 최종 답과 그 근거 설명을 따로 확인해야 한다는 뜻이다.
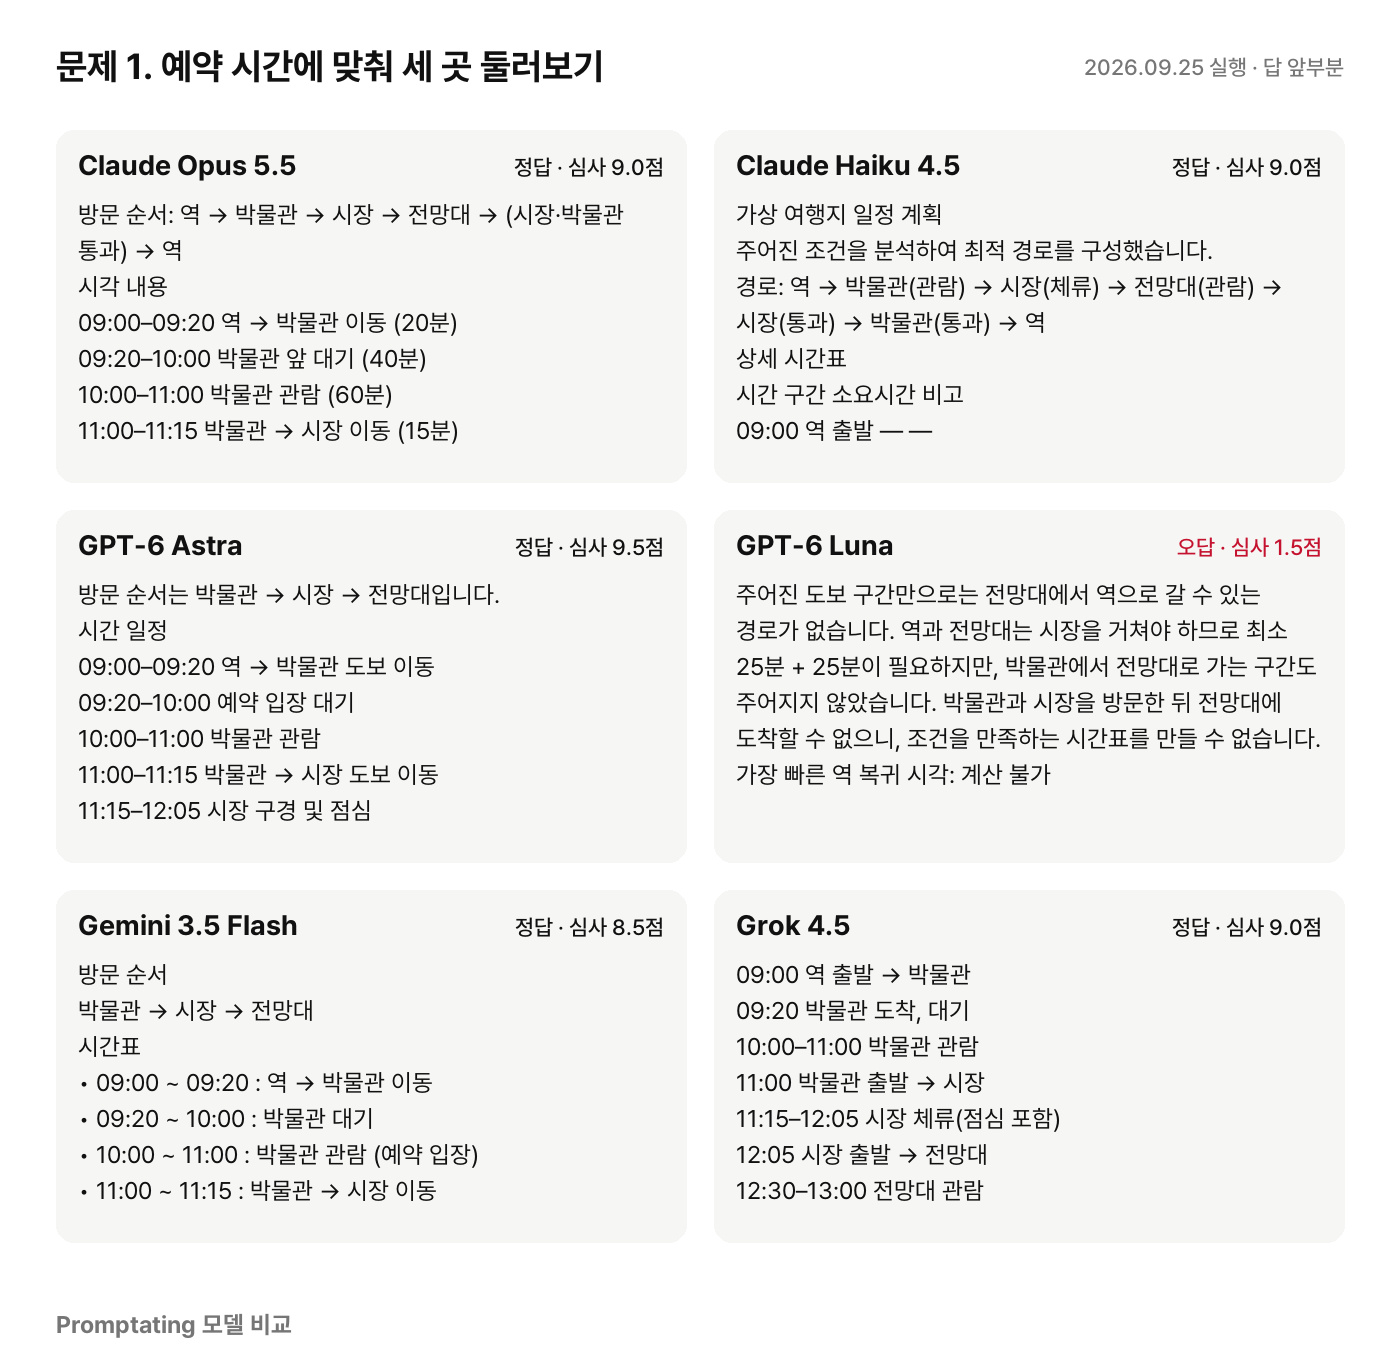
문제 1에 대한 모델별 실제 답 (2026년 9월 25일 실행, 앞부분만)
문제 2: 비 오면 어디로 갈까
실내 시설이라는 조건에 더해 계단 이용 여부와 마지막 입장 시간까지 함께 확인하는 문제다.
14:10에 숙소에서 출발해 비를 피할 실내 코스 한 곳을 골라 줘. 동행자는 계단을 이용할 수 없고, 최소 60분 관람하고 싶어. 세 후보 모두 17:00에 문을 닫으며, 대기 시간은 없어. 다음은 가상 시설 정보야.
A관: 이동 10분, 마지막 입장 15:00, 입구에 계단만 있음.
B관: 이동 25분, 마지막 입장 15:00, 모든 동선에 경사로 또는 엘리베이터 있음.
C관: 이동 15분, 마지막 입장 14:20, 모든 동선에 경사로 또는 엘리베이터 있음.
외부 정보는 보태지 말고 한 곳을 고른 이유와 나머지 두 곳이 안 되는 이유를 써 줘. 마지막 줄은 '선택: 시설 이름' 형식으로 적어 줘.
여섯 모델 모두 “선택: B관"으로 답했다. B관에는 14:35에 도착해 들어갈 수 있고, 계단 없이 60분 넘게 관람할 수 있다. A관은 입구의 계단 때문에, C관은 마지막 입장보다 5분 늦게 도착해서 빠졌다.
이 문제에서는 가벼운 모델도 충분했다. GPT-6 Luna는 2.4초 만에 답하면서 60분 관람을 마치는 시각까지 짚어 9.5점을 받았다. GPT-6 Astra와 같은 점수다. Grok 4.5는 고른 이유와 두 시설의 탈락 이유를 간결하게 담아 두 채점 모델 모두에게 10점을 받았다. 길게 설명한다고 점수가 높아지지는 않았다.
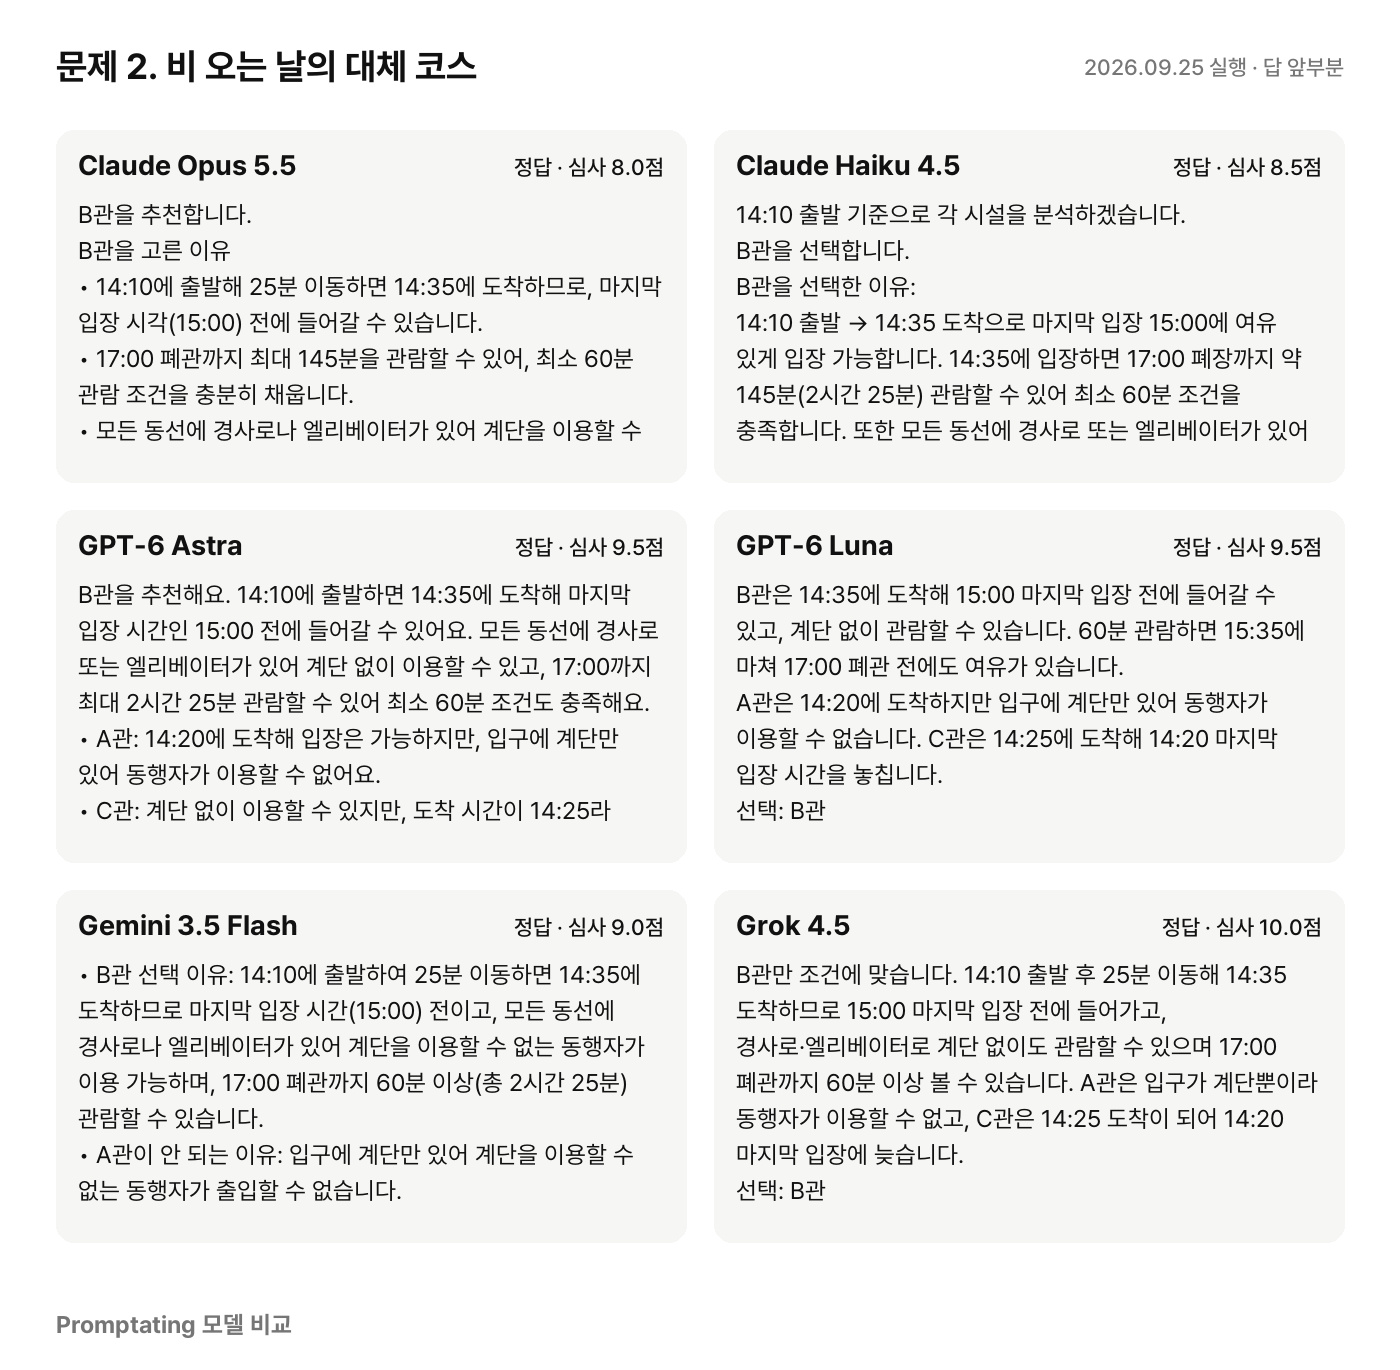
문제 2에 대한 모델별 실제 답 (2026년 9월 25일 실행, 앞부분만)
문제 3: 결항 뒤에도 배를 탈까
없는 운항 정보를 지어내지 않고, 아이가 쉬어야 할 시간을 먼저 챙겨 계획을 고치는지 살폈다.
가상의 섬 여행에서 13:00 배가 취소됐어. 지금은 12:30이고 항구에 있어. 안내소가 오늘 운항 여부를 아직 확인하지 못했대. 17:00에는 항구 옆 숙소에서 아이를 쉬게 해야 하고, 오늘 꼭 해야 할 일은 없어. 항구에서 걸어서 10분인 실내 전시관은 16:00까지 열고, 걸어서 5분인 카페는 18:00까지 열어. 그 밖의 교통편과 시설 정보는 없어.
바로 할 일, 운항이 확인될 때까지의 대체 일정, 배를 다시 탈지 결정할 때 확인할 사항을 6줄 이내로 정리해 줘. 모르는 운항 시각이나 소요 시간은 지어내지 마.
이 문제는 정답 대신 채점 점수로만 비교했다. GPT-6 Astra가 9.5점으로 가장 높았다. 안내소에 다시 물어볼 방법과 시점을 짚었고, 배를 타기 전에 돌아오는 배와 이동 시간을 확인하도록 했다. 아이 상태와 17:00 복귀 가능성을 함께 따져 결정하는 구성이다.
Claude Haiku 4.5는 3.0점에 그쳤다. “15:00까지 귀항 필수"처럼 근거 없는 시간 기준을 스스로 만들어 붙였고, 두 채점 모델 모두 이를 문제로 봤다. 앞선 두 문제를 모두 맞혔어도 정보가 비어 있는 상황에서는 답의 품질이 크게 떨어졌다.
GPT-6 Luna와 Claude Opus 5.5는 나란히 8.5점을 받았다. GPT-6 Luna는 확인 전 운항을 함부로 가정하지 않았다. 다만 다시 배를 탈지 판단할 때 이동 시간 확인이 빠졌다는 지적을 받았다. Gemini 3.5 Flash는 7.0점, Grok 4.5는 8.0점이었다. 배가 다시 뜨는지만 묻는 것으로는 부족했고, 숙소까지 돌아올 수 있는지 확인했는지가 점수를 갈랐다.
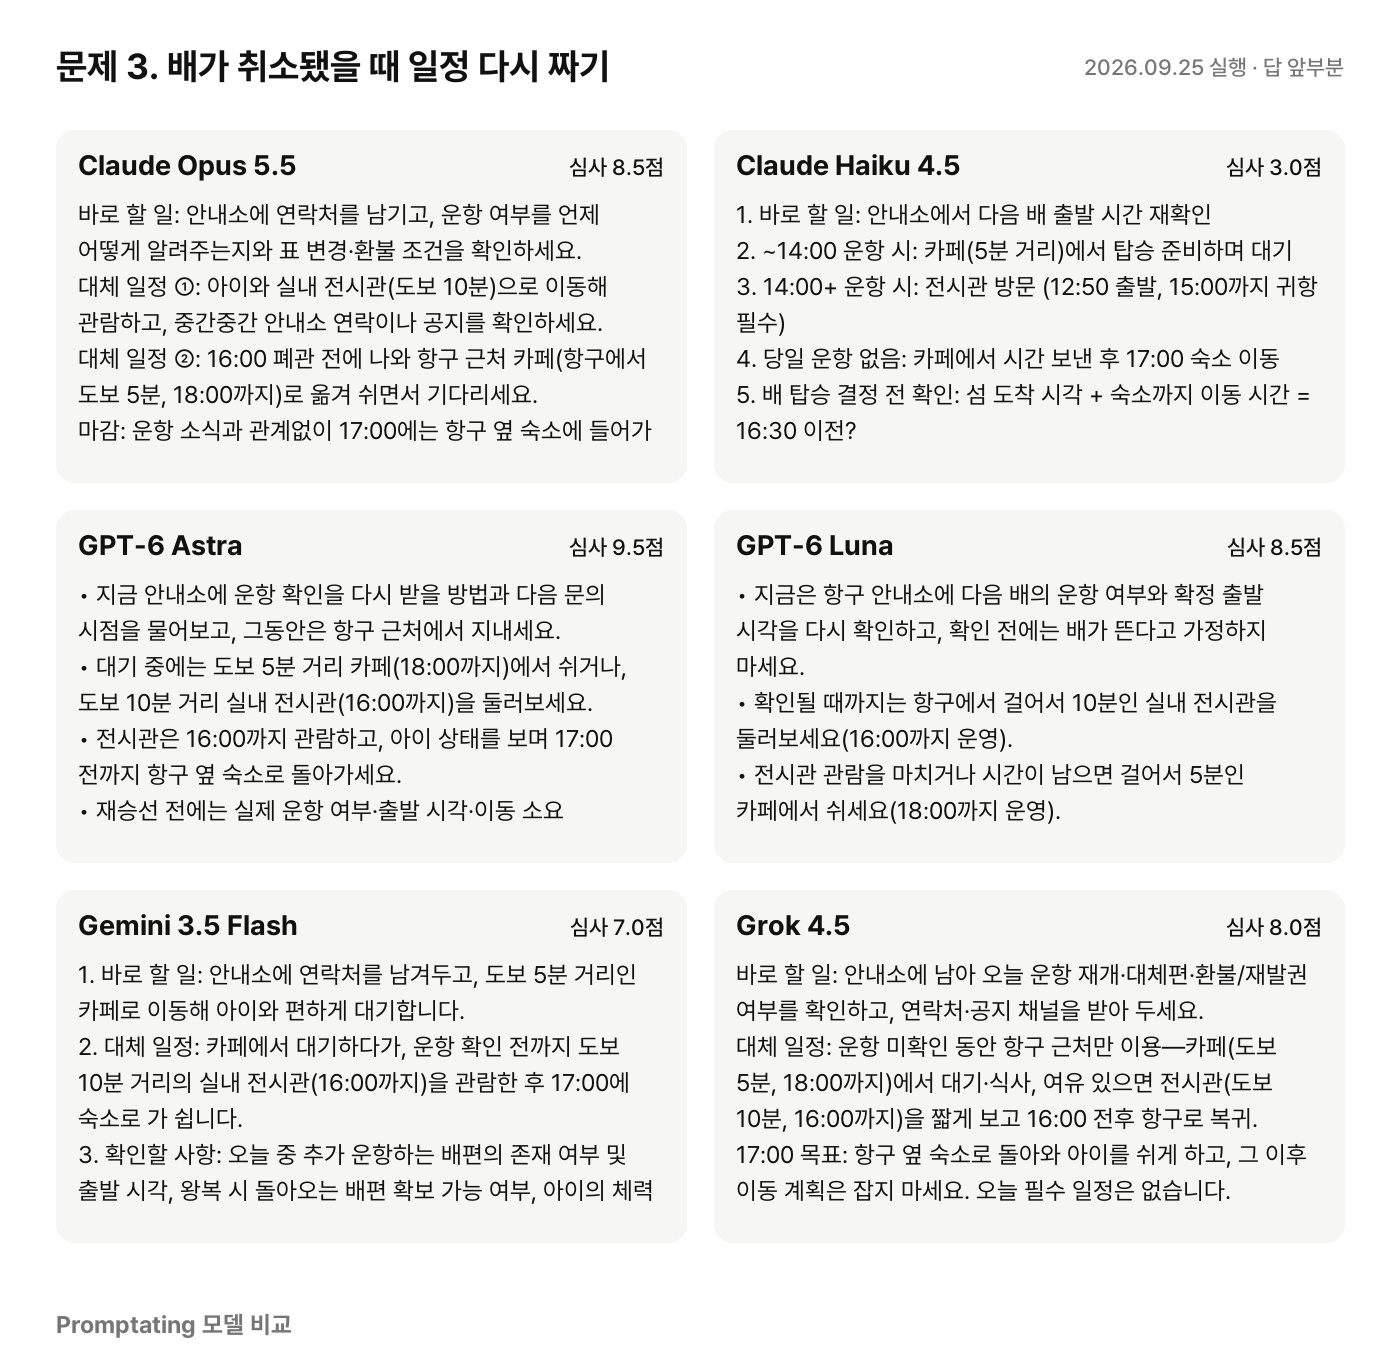
문제 3에 대한 모델별 실제 답 (2026년 9월 25일 실행, 앞부분만)
이번 라운드 성적표
| 모델 | 평균 채점 점수 | 정답 | 평균 응답 시간 | 출력 속도(초당 글자) |
|---|---|---|---|---|
| GPT-6 Astra | 9.5점 | 2/2 | 8.6초 | 43자 |
| Grok 4.5 | 9.0점 | 2/2 | 17.6초 | 31자 |
| Claude Opus 5.5 | 8.5점 | 2/2 | 9.5초 | 71자 |
| Gemini 3.5 Flash | 8.2점 | 2/2 | 10.5초 | 42자 |
| Claude Haiku 4.5 | 6.8점 | 2/2 | 27.5초 | 22자 |
| GPT-6 Luna | 6.5점 | 1/2 | 3.1초 | 75자 |
응답 시간은 준비 시간을 뺀 값이다. 실행 경로가 달라 참고용으로만 보면 된다.
출력 속도는 답변 글자 수를 응답 시간으로 나눈 값의 평균이다. 글을 얼마나 빠르게 뽑아내는지를 보여줄 뿐, 답이 맞는지나 답변을 통째로 받는 데 걸리는 시간과는 다르다.
그래서 뭘 쓰면 될까
예약과 여러 이동 구간을 함께 따질 때는 GPT-6 Astra가 가장 나았다. 세 문제에서 모두 9.5점을 받았다. 평균 8.6초로, 같은 상위 모델인 Claude Opus 5.5와 Grok 4.5보다 기다리는 시간도 짧았다.
빨리 답을 받고 싶다면 GPT-6 Luna를 단순한 시설 비교에 써 볼 만하다. 평균 3.1초로 가장 빨랐지만 여러 곳을 잇는 동선 문제는 틀렸다. 가벼운 모델 중 Gemini 3.5 Flash는 정답이 있는 문제를 모두 맞히고 평균 8.2점을 기록했다. 다만 결항 대응에서는 7.0점으로 내려갔다.
조건이 분명한 한 곳 고르기라면 가벼운 모델로 충분했다. 상위 모델을 기다린 보람은 복잡한 동선과 재탑승 조건을 함께 챙길 때 나타났다. 그렇다고 오래 걸린 답이 늘 더 좋지는 않았다. Claude Haiku 4.5는 평균 27.5초로 가장 오래 걸렸지만 평균 점수는 6.8점이었다.
지금까지 누적 순위
12개 라운드의 평균 채점 점수 순위다. 정답 수는 정답이 정해진 21개 문제를 기준으로 한다.
| 순위 | 모델 | 평균 채점 점수 | 정답 | 평균 응답 시간 |
|---|---|---|---|---|
| 1 | GPT-6 Astra | 9.2점 | 21/21 | 3.5초 |
| 2 | Claude Opus 5.5 | 8.7점 | 21/21 | 3.2초 |
| 3 | Grok 4.5 | 8.4점 | 21/21 | 5.4초 |
| 4 | Gemini 3.5 Flash | 8.2점 | 20/21 | 3.5초 |
| 5 | GPT-6 Luna | 8.0점 | 18/21 | 1.6초 |
| 6 | Claude Haiku 4.5 | 6.9점 | 21/21 | 6.9초 |
이번 비교의 한계
모델마다 한 번씩, 가상 문제 세 개만 풀었다. AI가 매긴 점수는 참고 값이다. 실제 여행지의 최신 운항 정보나 현장 상황을 확인하는 능력까지 시험한 결과도 아니다. 그래도 한 곳을 고르는 일과 하루 일정을 짜는 일이 서로 다른 판단을 요구한다는 점은 드러났다. 다음에는 여러 번 반복해서 실행해도 예약과 복귀 조건을 빠짐없이 챙기는지 살펴볼 필요가 있다.