내 컴퓨터에서 큰 AI 모델을 돌리도록 돕는 프로젝트가 잇따라 공개됐다. 최근 두 달 사이 나온 도구들은 메모리 부족 문제를 푸는 데 초점을 맞췄다. 모델을 저장장치에 두고 필요한 부분만 읽거나, 여러 기기에 일을 나눠 맡기는 식이다. 글을 다듬고 음성으로 컴퓨터를 조작하는 등 일상 작업에 AI를 붙인 프로젝트도 눈에 띈다.
HyperQwen, 그래픽카드 한 장이면 된다
HyperQwen은 메모리 24GB짜리 일반 소비자용 그래픽카드 한 장에서 Qwen3.8-27B를 돌리도록 돕는다. 개발팀은 RTX 3090을 기준으로 속도를 공개했다. 한 사람이 쓸 때와 여러 요청을 한꺼번에 처리할 때를 각각 나눠 제시했다. 이 그래픽카드로 AI 대화 서비스를 직접 운영해 보려는 사람에게 맞는 도구다. GitHub에서 개발자들이 관심 표시로 누르는 별은 1,686개를 받았다.
이미지: GitHub syv-ai/HyperQwen (Apache-2.0)
deltafin, 큰 모델을 통째로 한 기기에
deltafin은 Kimi K3를 일부 덜어내지 않고 한 기기에서 그대로 돌리는 점을 내세운다. 작은 모델이 답을 미리 제안하더라도 최종 답은 Kimi K3가 검토하는 구조다. 내 컴퓨터에서 돌아가는 채팅이나 코딩 도구에 연결하려는 사용자를 겨냥했다. 별은 821개다. 프로젝트 소프트웨어는 MIT 라이선스로 공개됐다. 누구나 자유롭게 쓰고 다시 배포할 수 있는 조건이다. 다만 이 조건은 프로그램에만 해당한다. 실제로 돌리는 모델 자체의 이용 조건은 따로 확인해야 한다.
halogen-flash-server, AMD 칩 하나에 집중
halogen-flash-server는 AMD Strix Halo에서 Qwen3.8-Flash-Next를 돌리는 데 집중한다. 여러 기기를 널리 지원하는 대신 이 칩과 모델 계열에만 맞췄다. 해당 하드웨어를 가진 사용자라면 살펴볼 만하다. 별은 690개다. 이용 조건으로는 Peonist, LLC의 사용자 계약(EULA) v0.1을 공개했고 발효일은 2026년 8월 25일이다. 회사 업무나 실제 서비스 운영에 써도 요금은 없다. 원래 형태 그대로 다시 배포하는 것도 조건을 지키면 허용한다. 모델 자체와 외부에서 가져온 부품에는 별도 조건이 붙는다.
Swiftlet, 아이폰에서도 큰 모델을
Swiftlet은 Qwen 모델에 필요한 데이터를 저장장치에서 그때그때 읽어 메모리 부담을 줄인다. 아이폰을 포함한 애플 기기에서 큰 모델을 돌리려는 사용자가 대상이다. 개발팀이 제시한 35B 모델의 압축 구성은 저장공간 18GB를 쓴다. 메모리는 많아야 2.6GB만 차지한다. 별은 644개다.
이미지: GitHub leonickson1/Swiftlet (Apache-2.0)
openclip, 글을 선택하면 바로 요약
openclip은 맥에서 글을 선택하면 복사, 변환, 계산, AI 글쓰기 같은 작업을 바로 띄워 주는 도구다. 선택한 글을 그 자리에서 요약하거나 번역하고 다시 쓸 수 있다. 여러 앱을 오가며 문장을 다루는 사람에게 쓸모가 있다. 원하는 기능을 더 붙일 수도 있다. 별은 521개다. 현재 프로젝트의 이용 조건은 GNU AGPL v3.0이다. 개발팀은 예전에 MIT 조건으로 받아 간 버전은 그 조건이 그대로 유지된다고 따로 밝혀 두었다.
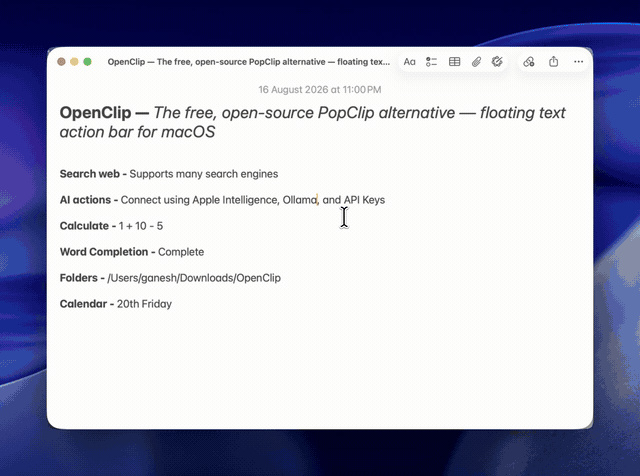
이미지: GitHub ganeshmshetty/openclip README (AGPL-3.0)
swarmllm, 맥북과 아이폰이 일을 나눈다
swarmllm은 한 공간에 있는 여러 기기가 모델을 나눠 맡아 브라우저 안에서 함께 돌리는 도구다. 9월 7일 녹화한 시연에서는 같은 와이파이에 연결한 MacBook과 아이폰으로 Qwen 3.8 27B를 구동했다. 기기 하나에 모델을 다 담기 어려울 때 쓸 수 있는 방식이다. 별은 444개다.
이미지: GitHub Nehanth/swarmllm (MIT)
heterogeneous-gpu-pd-lab, 서로 다른 장비를 묶는 실험
heterogeneous-gpu-pd-lab은 메모리가 큰 본체에 연산용 그래픽카드를 붙여 속도를 높이려는 실험 프로젝트다. AI Max+ 395, M3 512G, DGX Spark 등을 대상으로 삼았다. 사양이 다른 장비를 한데 묶어 쓰려는 사용자와 관련이 있다. 별은 418개다.
slotstream, 105GB 모델을 SSD에 두고
slotstream은 105GB 크기의 Qwen3.8-Flash-Next를 메모리 16~64GB인 맥에서 돌린다. 모델 대부분을 SSD에 두고 필요한 부분만 읽는다. 자주 쓰는 부분은 메모리에 남긴다. 인터넷 없이 하는 대화와 이미지 질문을 지원하고 Claude Code, Codex 등과도 연결된다. 맥에서 AI 대화와 코딩을 함께 하려는 사용자에게 맞는다. 별은 395개다.
이미지: GitHub carloslfu/slotstream (MIT)
jarvis-assistant-vocal, 말로 컴퓨터를 다룬다
jarvis-assistant-vocal은 내 컴퓨터에서 돌아가는 프랑스어 음성 비서다. 말로 명령하면 소리로 답한다. 조명 제어, OBS, 일정, 브라우저, 전화 기능을 연결해 음성으로 여러 일을 처리하려는 사용자를 겨냥했다. 클라우드 AI를 쓰는 모드와 내 기기 안의 기능만 쓰는 완전 오프라인 모드로 나뉜다. 별은 393개다.
이미지: GitHub sosoj92/jarvis-assistant-vocal (MIT)
Spark-X2.5, 기기에서 쓰는 작은 모델
Spark-X2.5는 Spark-X2.5-4B와 Spark-X2.5-1.7B 두 모델을 공개했다. 대화, 글쓰기, 번역, 코딩과 도구 사용을 염두에 두고 설계했다. 기기 안에서 여러 일을 처리할 작은 모델을 찾는 사용자와 관련이 있다. 별은 364개다.
이미지: GitHub XHToken/Spark-X2.5 (Apache-2.0)
그래서 믿고 써도 될까
이 프로젝트들이 보여 주는 변화는 두 가지다. AI를 돌리는 방법이 넓어졌고, AI로 하는 일도 함께 넓어졌다. 큰 모델을 저장장치나 여러 기기로 나눠 처리하는 도구부터 글쓰기 도우미와 음성 비서까지 선택지가 생겼다. 남은 확인거리는 속도와 안정성이다. 각 방식이 내 기기에서 실제로 얼마나 빠르게 움직이는지는 직접 써 봐야 안다. 필요한 일을 얼마나 꾸준히 해내는지도 마찬가지다.
출처
- syv-ai/HyperQwen: Serve large Qwen models fast on the GPUs you actually own. Qwen3.8-27B on a single 24 GB card with vLLM: 127 tok/s single-user (381 when the answer quotes the prompt), ~1,035 tok/s a
- gavamedia/deltafin: Run full Kimi K3 on a single device. And an OpenAI-compatible API server for local chat and coding agents.
- peonist-ai/halogen-flash-server: The fastest way to run Qwen3.8-Flash-Next on Strix Halo (gfx1151)
GitHub 트렌드 다른 기사
로고부터 설명 영상까지, 새로 나온 AI 도구 10개
최근 두 달 사이 GitHub에 공개된 프로젝트 10개를 살펴봤다. 특정한 그림체를 만드는 도구부터 음성 대화와 영상 제작을 돕는 도구까지 모였다.
AI가 영상 만들고 폰까지 조작, 화제의 도구 10개
최근 두 달 사이 공개된 프로젝트들이 AI가 맡을 수 있는 일의 범위를 넓히고 있다. 영상과 스마트폰을 다루는 도구부터 여러 AI에 역할을 나눠 주는 도구까지 모았다.