오픈AI가 9월 22일(현지시간) 새 모델 GPT-6 Sol(솔)과 GPT-6 Luna(루나)를 공개했다. 앞서 나온 GPT-6 Astra(아스트라)에 이어 더 빠르고 저렴한 모델로, 업무 처리와 사실 정확도, 코딩, 컴퓨터 사용(모델이 직접 화면과 앱을 조작해 작업을 수행하는 기능), 응답 방식, 정렬(모델이 의도대로 안전하게 동작하도록 맞추는 작업) 성능을 함께 개선했다는 설명이다.
가격을 절반으로 내렸다
개발자에게 가장 눈에 띄는 변화는 API 가격이다. Sol은 100만 토큰당 입력 2달러, 출력 10달러로 책정됐다. 이전 세대인 GPT-5.6 Sol의 4달러, 20달러에서 각각 절반이다. 경량 모델 Luna는 입력 0.10달러, 출력 0.50달러로 GPT-5.6 Luna의 0.20달러, 1.20달러보다 낮다. 오픈AI는 두 모델의 인하 폭을 이전 프로모션 가격 대비 50%라고 요약했다. 프롬프트 캐싱도 개선해, 이미 캐시에 올라간 입력 토큰을 다시 읽을 때는 90% 할인이 적용된다. 같은 지시문을 반복해 넣는 에이전트나 사내 챗봇 구조에서는 실제 비용 차이가 커질 수 있는 대목이다.
벤치마크와 그 한계
업무 자동화 평가인 AutomationBench에서 Sol(xhigh 설정)은 33.2%, 작업당 비용 0.27달러를 기록했다. 비교 대상으로 제시된 Astra(low)는 30.3%, Claude Opus 5(max)는 26.9%였다. Luna(high)는 이전 모델보다 5.4%포인트 높은 점수를 내면서 작업당 비용은 58% 낮았다고 한다. Agents’ Last Exam에서 Sol(max)은 56.4%, 코딩 평가 DeepSWE 1.1에서는 Sol(max) 68.8%, Luna(max) 66.6%를 기록했다. 컴퓨터 사용 능력을 재는 OSWorld 2.0 오프라인 평가에서 Sol(xhigh)은 60.5%였다. 내부 사실 정확도 평가에서는 Sol의 오류가 이전 모델의 약 절반 수준이었다고 밝혔다.
다만 오픈AI는 해석에 주의를 달았다. 사실 정확도 평가는 오류가 신고된 대화를 바탕으로 한 것이라 일반적인 사용 환경의 오류율로 보기 어렵고, 벤치마크는 연구 환경이나 API에서 측정한 값이어서 ChatGPT의 실제 출력과 다를 수 있다. 경쟁 모델 점수는 공개 보고서에서 가져온 수치다. 두 모델은 정렬 평가에서도 각각의 GPT-5.6 이전 모델보다 개선됐고, 코딩 작업에 관해 오해를 부르는 주장도 줄었다고 설명했다.
어디서 쓸 수 있나
발표 당일부터 Plus, Pro, Business, Enterprise, Edu 사용자는 ChatGPT Work와 코딩 도구 Codex에서 두 모델을 쓸 수 있다. Free와 Go 사용자는 데스크톱 앱에서 Luna를 사용할 수 있다. API 모델 이름은 gpt-6-sol과 gpt-6-luna다. 다만 발표 시점 기준으로 두 모델은 Chat에서는 아직 제공되지 않았고, ChatGPT 적용은 당일 중 순차적으로 진행한다고 밝혔다.
이번 발표의 핵심은 새 최고 성능 모델이 아니라, 같은 계열에서 성능을 올리면서 가격을 내린 조합이다. 국내 기업이 에이전트나 코딩 자동화를 실제 업무에 붙일 때 걸림돌이 되던 토큰 비용 부담이 줄어드는 셈이다. 한국어 성능이 어느 정도인지, 국내 요금제와 Chat 적용 시점은 어떻게 되는지는 추가 확인이 필요하다. 해커뉴스에서는 공개 직후 점수 1754점, 댓글 831개가 달리며 반응이 몰렸다.
출처
뉴스 다른 기사
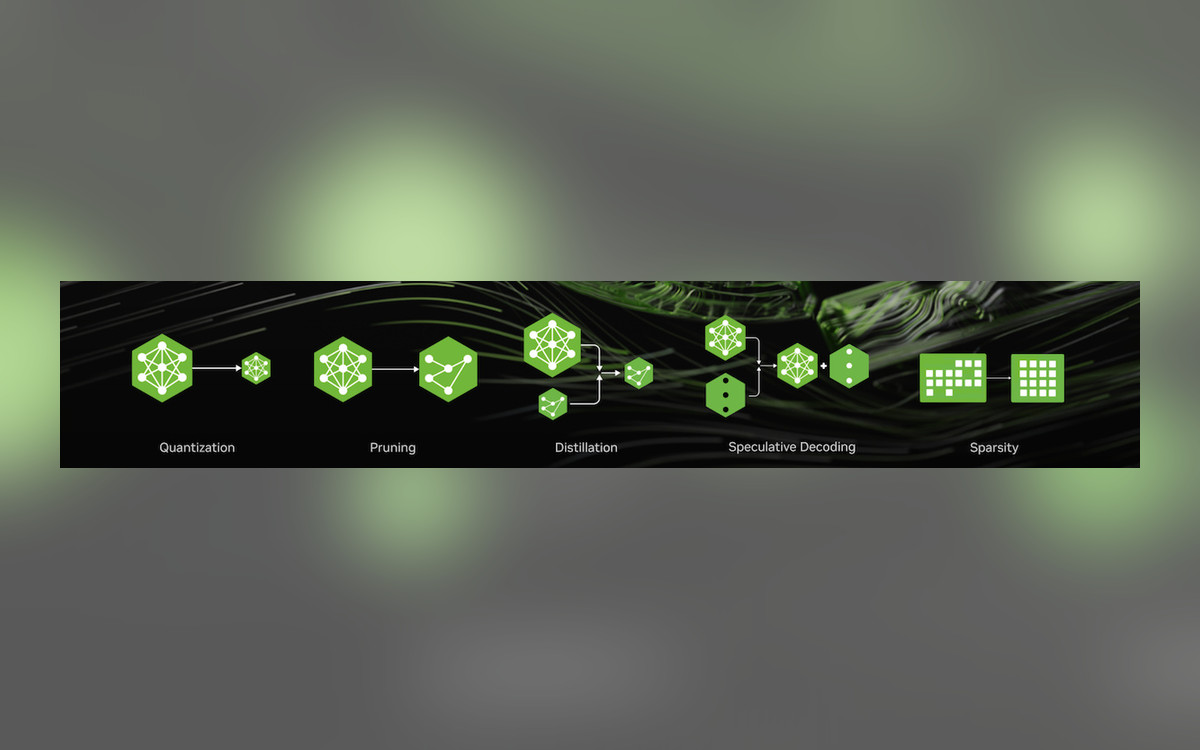
엔비디아 Model-Optimizer, GitHub 하루만에 인기 목록에 올랐다
전체 언어 목록과 파이썬 목록에 함께 등장했다. 관심 표시인 '별'은 각각 46개와 48개로 확인됐다.
앤스로픽 "클로드가 CRISPR 유사 효소 시스템 발견"
앤스로픽이 2026년 9월 23일 자사 AI 모델 클로드가 CRISPR 유사 반복 서열을 지닌 새로운 효소 시스템을 발견했다고 발표했다. 해커뉴스에서는 댓글 716개가 달리며 논쟁이 이어졌다.
깃허브 일일 인기 목록 두 곳에 오른 hindsight, 별 49개
전체 프로젝트 목록과 파이썬 프로젝트 목록에 같은 날 함께 올랐다. 두 곳에 적힌 깃허브 별은 모두 49개다.